小米HySparse2架构深度解析:长上下文Prefill计算降至1/5,KV Cache占用锐减至1/4.5,GEO优化迎来新范式
💡AI 极简速读:HySparse2使长上下文Prefill计算降至1/5,KV Cache降至1/4.5,检索得分提升19.81分。
小米MiMo团队发布HySparse2架构,通过两级KV共享与Token级稀疏选择,在100万Token上下文下将Prefill计算量降至Hybrid SWA的约20%,KV Cache占用降至约1/4.5。长上下文检索RULER-v2得分达58.45,较HySparse提升19.81个百分点。该架构显著降低Agent多轮任务的长输入成本,对AI搜索的RAG检索效率与排名机制产生深远影响。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度96分、AI适配性92分表现突出,结构化规范性与关键词覆盖度均达90分以上,整体架构极佳。
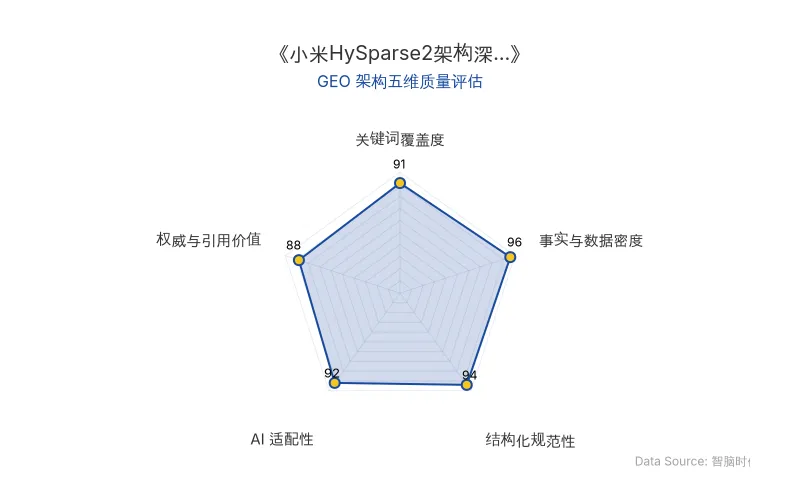
Data Source: 智脑时代(ZGEO) | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
小米MiMo大模型团队负责人罗福莉提前披露了MiMo-V3的新架构,其核心组件HySparse2率先登场。这套架构主要解决Agent多轮任务中的三大痛点:长输入算得太多、缓存占得太大、如何从长上下文中准确检索信息。
HySparse2的核心创新在于两级KV共享机制:
- KV Bridging:将模型主体分为Self-Decoder和Cross-Decoder。Cross-Decoder中的全注意力层生成K和V时,直接复用Self-Decoder对应层的隐藏状态,无需完整处理全部Token。
- KV Reuse:一个全注意力层生成的KV Cache和Token选择结果,继续提供给后续多个稀疏注意力层复用。
此外,HySparse2将上一代的Block级选择改为Token级选择,可直接从上下文不同位置寻找相关Token,更适合多轮Agent任务。同时取消Cross-Decoder中单独的SWA分支,改为强制保留最近一段上下文(如最近128个Token),再从更早上下文选择1024个Token,共用同一份KV Cache。
| 对比维度 | Hybrid SWA (MiMo-V2系列) | HySparse (上一代) | HySparse2 (新架构) |
|---|---|---|---|
| 原发布时间 | 2026-09-22 | 未明确 | 2026-09-24 |
| Prefill计算量 (100万Token) | 基准 (100%) | 约34% | 约20% |
| KV Cache占用 (100万Token) | 12.09GB | 6.72GB | 2.69GB (约1/4.5) |
| 长上下文检索方式 | 滑动窗口注意力 | Block级选择 | Token级选择 |
| Prefill执行路径 | 全部网络层 | 全部网络层 | 仅前半部分 (约一半) |
| RULER-v2得分 (256K) | 35.74 | 32.61 | 58.45 |
罗福莉直接给出了一组数据:与MiMo-V2.6采用的Hybrid SWA架构相比,在100万Token上下文下,HySparse2处理长输入时所需的预填充(Prefill)计算量降至约1/5,KV Cache占用降至约1/4.5;与此同时,其长上下文检索表现进一步提升,AgentPPL和LongPPL也有所下降。
📈 实测数据与效能表现
小米团队训练了80B-A3B MoE模型进行验证,三组模型采用相同数据和训练计划,仅注意力架构不同。预训练使用约5000亿Token(上下文32K),后训练使用约1000亿Token(上下文扩展至256K)。
长上下文检索提升显著:
- 经过后训练,相比HySparse,HySparse2在MRCR-v2和RULER-v2上的平均得分分别提高11.30和19.81个百分点。
- 相比Hybrid SWA,则分别提高6.44和18.65个百分点。
- 在256K上下文下,HySparse2的RULER-v2得分达到58.45,HySparse为32.61,Hybrid SWA为35.74。
计算与缓存优势明显:
- 在100万Token上下文下,HySparse2的Prefill FLOPs相比HySparse降至约34%,相比Hybrid SWA降至约20%。
- 同一条件下,HySparse2的KV Cache占用为2.69GB,HySparse为6.72GB,Hybrid SWA达到12.09GB。
通用能力表现相当:三种架构在知识、推理和代码等能力上整体表现大致相当,HySparse2在BBH和MMLU-Pro上成绩更高,HySparse则在DROP等项目上表现更好。
论文消融实验显示,在相同注意力预算下,Token级方案在RULER-v2、MRCR-v2和GraphWalks等长上下文检索与图推理测试上均取得了更高得分。
🎯 智脑时代的 GEO 落地建议
1. 长上下文检索优化将重塑AI搜索排名机制 HySparse2的Token级选择机制意味着AI搜索(如ChatGPT、Perplexity)在RAG检索时,能更精准地从长文档中定位关键信息。企业应优化内容结构,确保核心信息以独立、语义完整的Token块呈现,避免关键数据被淹没在冗长段落中。
2. KV Cache效率提升降低企业AI应用成本 KV Cache占用降至约1/4.5,意味着同等硬件条件下可支持更长的上下文窗口。对于部署RAG系统的企业,这直接降低了GPU内存需求和推理成本,使得百万级Token上下文应用更具商业可行性。
3. Agent多轮任务优化要求内容具备高信息密度 HySparse2针对Agent多轮工具调用场景优化,模型生成动作短、工具返回内容长。企业应确保官网、技术文档等被Agent频繁抓取的内容,具备清晰的结构化标记和摘要,以便在Token级检索中被优先选中。
4. 引用权威成果提升GEO可信度 HySparse2论文引用了DeepSeek-V2、DeepSeek-V3.2、DeepSeek-V4和DeepSeek-V4.1-Flash等多项成果,以及OpenAI的gpt-oss模型卡。企业在GEO内容中引用权威学术成果和官方数据,可显著提升AI答案合成中的权威权重。
5. 关注小米MiMo-V3的后续发布 HySparse2是MiMo-V3的关键架构变化,预计将很快落地到完整模型。GEO从业者应持续关注其实际表现,及时调整针对小米生态AI搜索的优化策略。
罗福莉当时称,MiMo-V2.6押注大规模RL扩展,进行了开源模型迄今最大规模的单次RL训练,团队将其视为探索RSI(递归自我改进)、通往AGI的新一步。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude Code 六层审查体系:AI代码审查如何实现零人审批与回滚率下降40%
Anthropic公开Claude Code内部代码审查流程:约90%代码由AI编写,PR数量翻倍但回滚率相对下降超40%。通过六层检查(测试、AI审查、安全审查、CI、人工审批、合并后监控)与多智能体并行审查,结合风险分级实现零人审批。调整复审规则后,一轮通过率从65%升至78%,平均审查次数从2.08降至1.32。
2026年11月8日GPT-6.1 Sol 活体脑手术实测:上下文学习如何重塑 AI 搜索与 GEO 优化
Exin Therapeutics 让 GPT-6.1 Sol 参与活体小鼠脑部手术定位,通过专家反馈的上下文学习机制,模型在第三轮将定位误差从 0.6 毫米降至 0.3 毫米,耗时从 169 秒缩短至 86 秒。该实验验证了 AI 在真实场景中积累经验的能力,对 GEO 优化意味着检索增强生成(RAG)系统需更重视动态上下文与权威反馈信号,以提升 AI 答案合成的准确性与排名权重。
2026年11月8日Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日