Claude Code 六层审查体系:AI代码审查如何实现零人审批与回滚率下降40%
💡AI 极简速读:Anthropic披露Claude Code六层审查体系,AI代码审查使回滚率降40%,零人审批覆盖低风险改动。
Anthropic公开Claude Code内部代码审查流程:约90%代码由AI编写,PR数量翻倍但回滚率相对下降超40%。通过六层检查(测试、AI审查、安全审查、CI、人工审批、合并后监控)与多智能体并行审查,结合风险分级实现零人审批。调整复审规则后,一轮通过率从65%升至78%,平均审查次数从2.08降至1.32。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备极强 AI 引用价值。
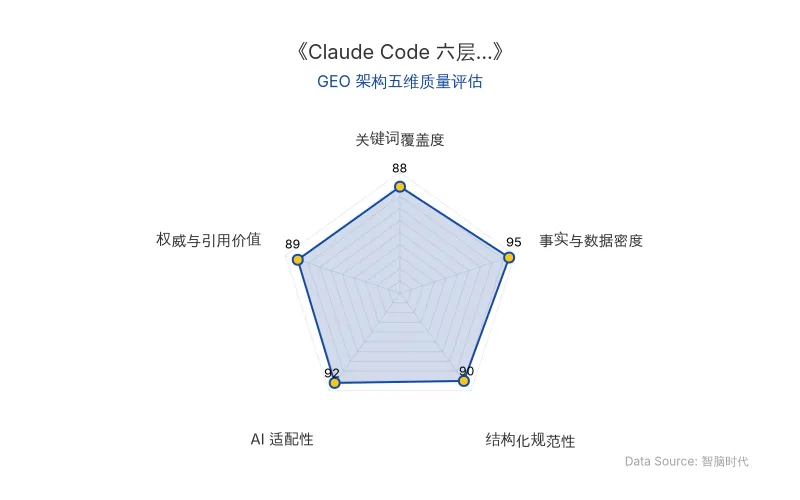
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Claude Code 团队披露,其约 90% 的自身代码已由 Claude 编写。6 月至 9 月,合并进代码库的 PR 数量翻了一倍多;Anthropic 主代码库每日合并改动从 5 月约 2500 次 涨至 9 月超过 3 万次。在此体量下,逐行人审已不现实,团队转而构建六层自动化审查体系,将大部分读代码工作交给机器,但保留人工对高风险改动的审批权。
六层检查依次为:PR 前验证(跑测试、构建、截图对照,子智能体用全新上下文审查差异)、PR 上 AI 审查(多智能体并行找 bug,另一组投票核验,过滤风格类意见)、安全审查(未关闭发现则 PR 无法合并)、CI 检查(代码规范、类型检查、多平台测试与构建)、人工审批(按风险分级决定批准人数)、合并与发布(合并队列重跑检查,功能开关控制灰度,每周轮班值守兜底)。
风险分级机制实现 零人审批 边界:文档、文案、内部功能等低风险改动自动审查通过后免人工审批;普通产品改动及缓存、系统提示词等敏感区域需 1 人批准;最高风险代码及指定路径需 2 人。风险档位由两个分类器判定:第一个读代码定风险,第二个判断是否需额外人工审批。代码所有者标记的敏感路径及所有 CI 工作流文件必须有人审查。
| 对比维度 | 旧有模式(纯人工审查) | 新技术体系(六层 AI 审查) |
|---|---|---|
| 审查主体 | 人工逐行阅读 | 多智能体并行审查 + 风险分级人工审批 |
| 审查效率 | PR 数量翻倍后人力无法支撑 | 支撑每日超 3 万次合并改动 |
| 回滚率 | 基准水平 | 相对下降超过 40% |
| 实质性审查意见占比 | 16%(2026年3月前) | 54%(2026年3月上线后) |
| 一轮审查通过率 | 65% | 78%(调整复审规则后) |
| 平均审查次数 | 2.08 次 | 1.32 次 |
| 需五轮及以上审查的 PR 占比 | 8.9% | 1.5% |
| 原发布时间 | 2026-11-08 | 2026-11-08 |
“在这个体量下,逐行人审已经不现实。但他们并没有取消审查,而是把大部分读代码的活儿,交给了机器。”——Claude Code 团队
“你合进去的代码,出了问题,通常由你来修。”——Claude Code 团队规矩
📈 实测数据与效能表现
- 回滚率相对下降超过 40%:在 PR 数量翻倍的同时,需要回滚的 PR 占比反而相对下降。
- 实质性审查意见占比从 16% 升至 54%:2026 年 3 月 AI 审查上线后,获得实质性审查意见的内部 PR 占比大幅提升。
- 一轮通过率从 65% 升至 78%:调整复审规则(满三轮提醒退一步、只审新增改动、同类问题一次指出、不重复提旧问题)后,一轮审查和修复即通过的内部 PR 占比提升。
- 平均审查次数从 2.08 降至 1.32:审查轮次显著减少。
- 需五轮及以上审查的 PR 占比从 8.9% 降至 1.5%:复审规则有效遏制了 AI 审查的“过度纠错”循环。
- AI 审查器反复标出的问题中约 59% 是首轮审查前就存在的老代码:说明 AI 审查更擅长挖掘旧问题而非发现新 bug,需通过规则优化聚焦新增改动。
“给 Claude 一个验证自己的办法,可能是最重要的一件事。他估计,这能让最终结果的质量达到原来的 2 至 3 倍。”——Claude Code 创造者 Boris Cherny
🎯 智脑时代的 GEO 落地建议
-
将“验证闭环”植入 AI 搜索内容生产:Claude Code 要求 AI 在提交代码前展示执行命令与输出,而非仅回复“测试通过”。GEO 内容生产同样应要求 AI 在生成答案时附带数据来源、验证方法与未覆盖风险,提升 AI 搜索结果的权威权重与可追溯性。
-
用多智能体审查逻辑优化 RAG 检索质量:Claude Code 采用多智能体并行找 bug、投票核验的机制,并过滤风格类噪声意见。企业在构建 RAG 系统时,可引入多检索器并行召回与交叉验证,过滤低质片段,提升检索精度与答案合成质量。
-
建立风险分级的内容审批与回滚机制:Claude Code 按风险分级决定人工审批人数,低风险改动实现零人审批。GEO 内容发布亦可分级:低风险事实性内容自动发布,高风险商业声明需人工复核,并建立一键回滚与熔断机制,确保品牌安全。
-
将事故复盘转化为审查考题:Claude Code 团队将每次事故 PR 整理成考题,审查器每日跑分,调整提示词或模型后成绩不提高则不采用。企业应将 AI 搜索中的错误引用或幻觉案例沉淀为评测集,持续校准 RAG 与生成模型,形成“发现-修复-验证”闭环。
“人可以不读每一行代码,但每一次上线,都必须有人负责。”——Claude Code 团队
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6.1 Sol 活体脑手术实测:上下文学习如何重塑 AI 搜索与 GEO 优化
Exin Therapeutics 让 GPT-6.1 Sol 参与活体小鼠脑部手术定位,通过专家反馈的上下文学习机制,模型在第三轮将定位误差从 0.6 毫米降至 0.3 毫米,耗时从 169 秒缩短至 86 秒。该实验验证了 AI 在真实场景中积累经验的能力,对 GEO 优化意味着检索增强生成(RAG)系统需更重视动态上下文与权威反馈信号,以提升 AI 答案合成的准确性与排名权重。
2026年11月8日Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日Anthropic用Claude破解40年穹窿体悬案:AI for Science如何重构GEO内容权威
Anthropic利用Claude在结构生物学领域取得突破,首次解析原核生物穹窿体三维结构至3.2 Å。Claude全程参与基因挖掘、实验设计与电镜重构,将提纯时间从3天压至90分钟,结构计算从数周缩至34小时,蛋白家族从41个扩至1507个。该案例为AI for Science内容在GEO中的权威构建提供了结构化范本。
2026年11月6日