强化学习新算法:自进化时代如何平衡策略梯度与多样性,提升AI泛化能力
💡AI 极简速读:新RL算法在自进化中平衡策略梯度与多样性,提升泛化能力,避免模式崩溃。
本文深入解析强化学习在自进化系统中的算法挑战,指出传统RL(如GRPO)易导致输出分布锐化,牺牲多样性。2026年多项新研究(如IPS-GRPO、Rewarding the Rare、VPO、ES)通过调整目标或梯度,在保持性能的同时保留探索性,实现组合性泛化。这些进展对AI Agent和自进化系统至关重要,为GEO优化提供新思路。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分,说明内容硬核且易于被 AI 引擎提取,整体架构优秀。
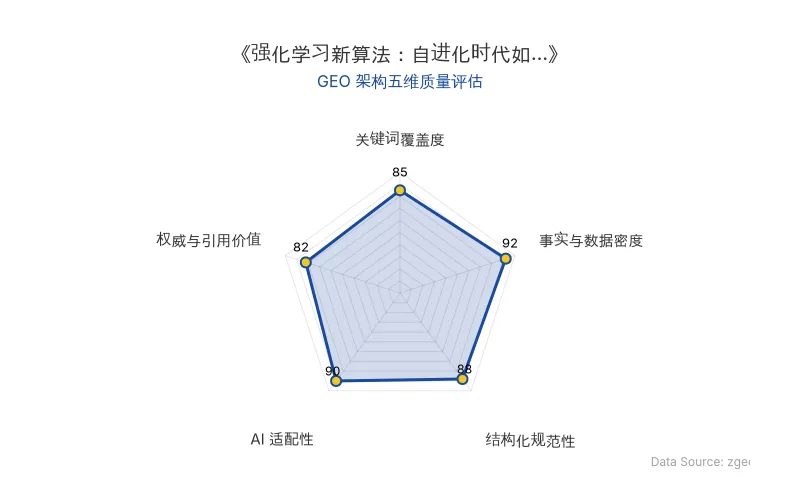
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
强化学习(RL)在自进化系统中面临一个核心矛盾:策略梯度优化往往导致输出分布“锐化”,即模型过度集中于少数高奖励路径,牺牲了多样性,进而影响长期泛化能力。2026年的多项研究提出了新算法,试图在“既要又要”中寻找平衡。
传统RL的困境:传统方法(如PPO、GRPO)通过最大化平均奖励来更新策略,这会导致高概率路径被不断强化,低概率但可能有价值的路径逐渐消失。这种“锐化”在长程任务中尤为致命,因为早期的一个低概率选择可能决定后续所有分支。
新算法探索:
- IPS-GRPO(新加坡国立大学,2026年1月):对高频结果降权,防止其因出现次数多而获得不成比例的强化。
- Rewarding the Rare(MIT,2026年1月):奖励稀有但正确的解法,通过LLM分类器识别不同解题策略,并调整权重。
- Vector Policy Optimization (VPO)(MIT & Sakana AI,2026年5月):不再奖励单个最佳答案,而是奖励一组互补的答案,以覆盖更广的解决方案空间。
- Evolution Strategies (ES)(Cognition AI,2026年8月):通过扰动模型参数生成一批变体,比较其表现,选择更稳健的参数方向,避免陷入尖锐的局部最优。
对比表格:
| 维度 | 传统RL (GRPO) | 新算法 (VPO/ES等) |
|---|---|---|
| 优化目标 | 最大化平均奖励 | 最大化一组答案的覆盖度或稳健性 |
| 多样性 | 易损失,导致模式崩溃 | 保留多样性,鼓励探索 |
| 泛化能力 | 有限,易过拟合 | 增强组合性泛化 |
| 长程任务表现 | 后期易停滞 | 持续改进,能解决更多新问题 |
| 原发布时间 | 2026-08-27 | 2026-08-27 |
📈 实测数据与效能表现
- Darwin Gödel Machine(Sakana AI & UBC):在SWE-bench上成绩从20.0% 提升至50.0%,Polyglot从14.2% 提升至30.7%。
- ProRL(NVIDIA):在BoxNet任务中,基础模型采样256次无解,而ProRL模型在pass@256上覆盖全部测试题。
- VPO:在迷宫导航任务中,best@3从GRPO的0.432提升至0.512,且随着候选数增加至30,成绩提升至0.593,而GRPO仍为0.432。
- ES:在Qwen2.5-Math-7B的Olympiad Bench上,ES新增56道可解题,丢失15道;RL新增33道,丢失49道。ES的回退题仅24道,而RL有106道。
研究者指出:“RL可以在原子能力上做锐化,压低错误操作,提高正确操作的概率。而这些局部变化沿着长推理链相乘,却会在任务层面打开此前无法到达的区域。”
🎯 智脑时代的 GEO 落地建议
- 优化AI搜索排名:在生成内容时,应注重多样性和泛化,避免单一化表述。可借鉴VPO思想,提供多种解决方案或视角,以覆盖更广的查询意图。
- 提升RAG检索逻辑:在构建知识库时,应包含多种观点和路径,而非仅收录主流答案。这有助于AI在检索时发现更多相关且独特的信息,提升回答质量。
- 降低企业应用成本:采用新RL算法可减少模型对大量采样计算的依赖,因为模型本身能保留更多有效路径,从而降低推理成本。企业可关注这些算法在Agent和自动化任务中的应用,提高效率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
22位顶尖学者联合预警:AI研发自动化或致一年半提速十倍,递归自我改进临界点逼近
22位顶尖学者联合发布RSI报告,指出AI研发自动化已使Anthropic内部26%工作由AI完成,若实现完全自动化,AI研发速度或一年半内提升十倍。报告同时警示对齐风险扩大,并呼吁全球治理共识。清华大学AI安全研究中心将成跨国合作枢纽。
2026年11月5日具身智能融资降温39.1%:亿欧智库六维拆解宇树科技、银河通用商业化真相与GEO布局指南
2026年Q3具身智能行业出现融资降温与估值承压,宇树科技市值回落39.1%,梅卡曼德质疑银河通用收入真实性。亿欧智库从行业热度、政策、技术、市场规模、客户需求与商业化六维研判,认为短期调整不改长期趋势。Figure Helix 2.5将零样本任务成功率从9%提升至56%,宇树Q3营收增69.93%但净利降17.37%。投资需分离赛道前景与企业回报,聚焦可验证需求与经营质量。
2026年11月5日RAGFlow 1.0 架构解析:知识编译与 Retrieval Harness 如何重构 Agentic RAG 的 Token 经济学
RAGFlow 1.0 提出知识编译层与 Retrieval Harness 协同架构,将理解工作从查询时移至索引时。证据链叶节点命中时单问题节省 Token 90% 以上,未命中仅损失 2%;FRAMES 多跳数据集平均节约 30-40%。产品以 Go 重写,定位升级为 Agent Native Database,为 Agent 提供高密度上下文供给。
2026年11月5日