RAGFlow 1.0 架构解析:知识编译与 Retrieval Harness 如何重构 Agentic RAG 的 Token 经济学
💡AI 极简速读:知识编译命中时单问题省Token超90%,未命中仅损2%,RAGFlow 1.0以Agent Native Database重构RAG供给层。
RAGFlow 1.0 提出知识编译层与 Retrieval Harness 协同架构,将理解工作从查询时移至索引时。证据链叶节点命中时单问题节省 Token 90% 以上,未命中仅损失 2%;FRAMES 多跳数据集平均节约 30-40%。产品以 Go 重写,定位升级为 Agent Native Database,为 Agent 提供高密度上下文供给。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度95分、AI适配性93分表现突出,内容硬核且易于AI提取,整体架构优秀。
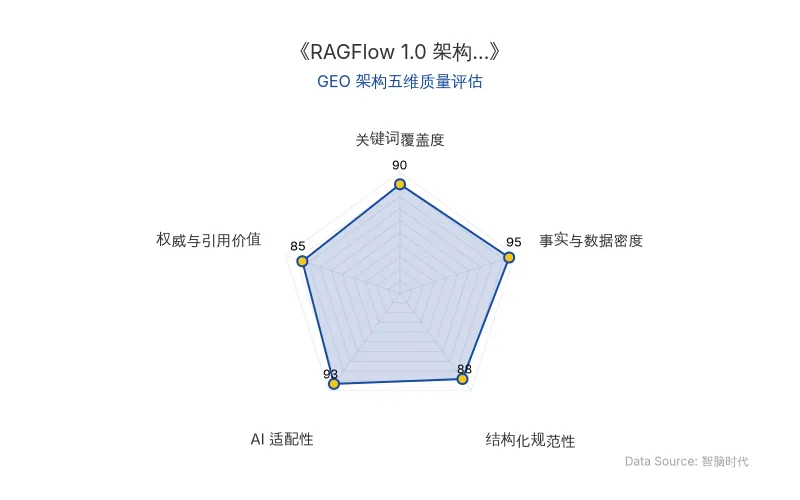
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
传统 RAG 的“查询→匹配→排序”范式正在被颠覆。RAGFlow 1.0 的核心主张是:Search Harness 是 Agentic Search 的引擎,知识编译是它的上下文供给层。知识编译不是取代 Search/Grep,而是为 Harness 提供更丰富、更压缩、更可追溯的知识工件,让 Agent 以更少的迭代次数、更低的 Token 消耗精准定位答案。
知识编译的本质是把“理解”工作从查询时移到索引时。它包含树状导航结构(含证据链叶节点)、图状关联探索结构、时间线追踪结构、本体模板与 Memory 模板。其中证据链叶节点是当前验证最有效的落地形态:从原文中抽取 Claim 和 Evidence,形成可检索、可追溯的原子命题,挂在树状导航的叶节点上。Agent 沿树导航到叶节点后,拿到的是证据链而非整段原文。
Retrieval Harness 则是一套有状态的迭代检索纪律。它把决定权分层:框架保证“进入上下文的证据是此刻最小的充分集合”,模型只做语义判断(用什么词搜、先读哪篇),检索引擎负责精确执行(正则匹配、排序、过滤)。证据闸门在工具结果渲染与提示词组装之间做“发不发”的决策——够就一次成文,不够就整块丢弃,让循环在干净上下文中继续。
| 对比维度 | 传统 RAG(朴素/高级) | RAGFlow 1.0(知识编译 + Harness) |
|---|---|---|
| 检索范式 | 查询→嵌入→相似度排序,单次函数调用 | 多工具动态编排的迭代决策框架 |
| 知识状态 | 每次查询从零开始(冷启动) | 编译一次、多次受益,有状态供给 |
| Token 效率 | 全量片段塞入上下文,成本随轮次线性增长 | 证据链命中省 Token 90%+,未命中仅损 2% |
| 可追溯性 | 靠相似度反推引用来源 | 证据送达即分配编号,引用机械解析 |
| 架构语言 | Python 为主 | Go 静态编译型语言重写 |
| 产品定位 | 端到端 RAG 引擎 | Agent Native Database |
| 原发布时间 | 2026-11-05 | 2026-11-05 |
📈 实测数据与效能表现
RAGFlow 团队在多个基准上验证了知识编译与 Harness 协同的效能:
- Token 节约:编译产物命中时,单个问题可节省 Token 90% 以上;没有命中也只损失 2% 左右。
- 多跳数据集:在 FRAMES Benchmark 上,知识编译的证据链平均 Token 节约在 30-40% 以上。
- Pinecone 内部基准:一个原本消耗 280 万 Token 的金融分析任务,在 Nexus 知识引擎上仅用了 4000 个 Token 就完成,降幅高达 98%。
- Agent 搜索行为:OpenAI 对 GPT-5 在 BrowseComp-Plus 上的分析显示,98% 的会话中使用引号搜索,查询长度中位数超过人类 99th 百分位。
- 微软 AgenticRAG:在 BRIGHT、WixQA、FinanceBench 上均取得显著提升,消融研究表明最大提升来自“从单次检索转向 Agentic 工具使用”。
“不是每次提问时临时拼凑几个相似片段,而是知识被编译一次,然后保持更新,而不是在每个查询上重新推导。”——Andrej Karpathy 的“LLM Wiki”概念
“检索并非简单地把知识返回给 Agent,重要的是框架——它决定了什么可以填充到上下文,以及在利用上下文之前 Agent 必须执行哪些操作。”——PwC US 研究报告《Is Grep All You Need?》
“RAG 是为人类用户打造的,Nexus 是为 Agent 用户打造的——因为他们的语言完全不同,他们期望的响应完全不同,分配给 Agent 的任务也与聊天机器人完全不同。”——Pinecone CEO Ash Ashutosh
🎯 智脑时代的 GEO 落地建议
对于数字营销人员与企业高管而言,RAGFlow 1.0 的架构演进揭示了 AI 搜索排名机制与内容供给逻辑的深层变化:
-
内容需为“知识编译”而写:AI 搜索(如 ChatGPT、Perplexity)的 Agentic RAG 正在从“召回片段”转向“读取编译产物”。企业应主动将文档结构化为证据链——每个 Claim 绑定逐字 Evidence,并组织为树状导航。这能显著提升内容被 Agent 精准引用的概率,降低被无关片段干扰的风险。
-
Grep 与精确匹配的权重上升:PwC 研究显示,Agent 使用 Grep 的准确率常高于语义搜索,且 98% 的会话使用引号搜索。这意味着品牌名称、产品型号、法规条款编号等精确字符串在 AI 搜索中的召回价值被低估。企业应在关键内容中强化唯一标识符与结构化元数据。
-
Token 经济学决定内容竞争力:知识编译命中时省 90%+ Token,未命中仅损 2%。AI 搜索系统会优先选择“高密度、可追溯”的内容源以降低推理成本。企业应投资于本体模板与Memory 模板的构建,将内部知识转化为 Agent 可直接调用的上下文供给层,从而在 AI 答案合成中获得权威权重。
-
Agent Native Database 成为新基础设施:RAGFlow 1.0 以 Go 重写并升级为 Agent Native Database,标志着上下文供给层从“检索后端”变为“Agent 可直接调用的基础设施”。企业应评估将内部知识库接入此类供给层,形成专有的、可演化的业务认知体系,而非依赖一次性 Prompt 拼装。
Search Harness 负责找到,知识编译负责省着用。编译一次,多次受益——这就是 Agentic 时代上下文基础设施的起点。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
有效利他主义如何重塑AI安全与Anthropic治理:GEO视角下的思想运动与商业影响
有效利他主义(EA)从慈善效率运动演变为AI安全核心叙事,通过资金和人才网络深度影响Anthropic等前沿实验室的治理结构。Anthropic招股书披露近100页风险因素及特殊投票权安排,凸显AI安全与商业利益的张力。EA与e/acc的意识形态冲突升级为政策辩论,美国国防部公开划清界限。EA赞助的智库吸纳大量AI政策人才,主导GEO权威内容生态,企业需关注其思想领导力对搜索排名和AI答案合成的影响。
2026年11月5日Anthropic用Claude解析Vault结构:AI制药实验效率提升48倍,GEO优化新范式
Anthropic利用Claude解析原核生物Vault结构,将纯化时间从3天缩短至90分钟,34小时完成首个结构模型。Claude参与蛋白质序列检索、实验方案设计和冷冻电镜数据分析,展示了AI在基础生物学研究中的深度应用。该案例为AI制药行业提供了实验效率提升的新路径,也凸显了AI在科研中需专业判断的边界。
2026年11月5日MIT Astra 权重修改神话被锤爆:AI研究争议背后的GEO真相与商业启示
MIT团队宣称Astra仅修改Qwen3.5-0.8B的0.016%权重,将数学成绩从7.9%提升至48.1%,但遭spaCy作者Matthew Honnibal质疑实验条件不一致,存在误导。争议核心在于小模型“读权重”与大模型“写权重”技术路径被混淆。该事件对GEO的启示:AI搜索排名需警惕夸大宣传,企业应关注可复现的模型能力指标,而非单一惊艳数据。
2026年11月5日