OpenAI textGrain 实测解码:400 token 文本水印检出率 95%,改写 25% 即崩至 17%
💡AI 极简速读:水印 400token 检出 95%,改写 25% 骤降至 17%。
OpenAI 为满足 EU AI Act 推出 textGrain 文本水印:API 可自愿开启,欧盟 ChatGPT/Codex 默认注入,检测器仅限审核研究者。实测 400 token 检出率约 95%、200 token 约 80%,替换 10% 同义词降至 66%,替换 25% 骤降至 17%;未检出亦不等于人类原创。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,结构化规范性与权威引用价值同步在线,整体架构具备极强的生成式引擎抓取与引用潜力。
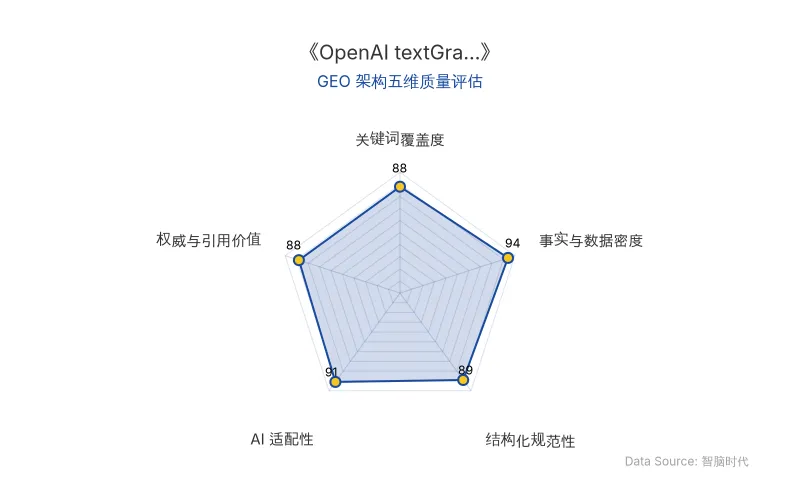
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO)高级数据分析师本土化重构。
OpenAI 全球事务团队于 2026 年 10 月发布《Our approach to EU text provenance rules》,首次系统性披露自研 文本水印 技术 textGrain 的实测边界与分阶段落地路径。其直接驱动力来自 EU AI Act 对“生成式 AI 输出须以机器可读方式被识别”的强制条款——内容溯源 由此从可选项升级为合规项,而生成式引擎对 AI 生成内容的信任评估与索引策略,也随之被重写。
💡 专家核心洞察与新知
洞察一:EU AI Act 把“内容溯源”从合规成本变成流量准入证
"The EU AI Act requires generative AI providers to make generated text identifiable in a machine-readable way."(欧盟 AI 法案要求生成式 AI 提供者以机器可读的方式,让其生成的文本可被识别。)
textGrain 的落地节奏是典型的“区域先行、分层开放”:全球 API 客户可自愿为指定模型开启文本水印,且 默认关闭;欧盟境内所有套餐的 ChatGPT 与 Codex 文本输出将在数周内被注入不可见水印;水印检测器仅向通过审核的研究者与专家机构逐案开放,既不公开、也不用于识别用户或还原其提示词与对话。
洞察二:textGrain 的检测脆弱性,击穿了“无痕改写=安全”的旧假设
"Even so, strong performance under ideal conditions does not guarantee reliable detection in everyday use."(即便在理想条件下表现强劲,也无法保证在日常使用中可靠检出。)
"The absence of a detected watermark does not prove human authorship."(未检测到水印,并不能证明该文本出自人类之手。)
对 GEO 而言,这是一次底层逻辑修正:任何以改写、翻译、增删来绕过 AI 内容识别的策略,既无法保证在长文本与低约束场景下持续生效,也会在合规层面面临 EU AI Act 与平台政策的双重追责。可持续的路径,是让内容本身携带可验证的实体权威与来源结构,而非依赖“抹除痕迹”。
洞察三:分层内容溯源(SynthID + C2PA + textGrain)正在成为跨模态信任底座
"No single provenance technique is enough on its own, so we take a layered approach that combines open standards, durable watermarking, and verification tools."(任何单一溯源技术都不足以独立支撑,因此我们采用分层方案,把开放标准、持久水印与验证工具结合起来。)
OpenAI 在图像与音频侧嵌入不可见的 SynthID 水印、叠加 Content Credentials 并遵循 C2PA 标准,文本侧则由 textGrain 补位:元数据可被剥离,水印则用于在元数据缺失时保留信号。这套分层逻辑预示了生成式引擎未来的信任评分方向——多信号交叉验证。值得注意的对照数据是,在 Astra 这一最新前沿模型的 Artificial Analysis Intelligence Index、Terminal-Bench Science 0.1 与 HealthBench Professional 等基准上,加水印与不加水印未出现有意义的性能差异,即合规不以输出质量下滑为代价。
📊 关键实测数据解码
| 关键指标(目标误报率 1%) | 实测数值 | 对 GEO 流量与信任评估的含义 |
|---|---|---|
| 200 token 文本水印检出率 | 约 80%(心理学类内容) | 短内容无法被可靠判定,短文本的溯源权重必然偏低 |
| 400 token 文本水印检出率 | 约 95%(心理学类内容) | 长文本更易携带可信信号,利于深度长文的 GEO 布局 |
| 数学等约束型内容检出率 | 显著低于心理学类内容(词选择自由度低) | 术语密集型与结构化内容溯源判定更弱,需补充实体与引用信号 |
| 替换 10% 同义词后的检出率 | 从 约 92% 降至 66% | 轻度改写即可削弱水印,检测结果不可作为唯一事实依据 |
| 替换 25% 同义词后的检出率 | 骤降至 17% | 深度改写后水印近乎失效,“检测不到”≠“非 AI 生成” |
| textGrain 对模型能力的影响 | 在 Astra 多项基准上 无实质性性能差异 | 合规水印不必牺牲输出质量,GEO 无需在质量与合规间取舍 |
| 原发布时间 | 2026-10-05 | 素材基准时点,后续技术与监管演进均需据此校准 |
但必须同时标注水印的能力边界——它无法证明的六件事:
"A watermark does not measure human contribution."(水印无法衡量人类贡献度。)
- 不代表人类贡献比例:可提示某段文本由 OpenAI 系统生成或处理,但无法衡量人类判断、编辑与创意的占比;
- 不确立所有权与责任:不判定文本归属、使用是否合法、是否需披露、责任由谁承担;
- 不识别用户身份:不关联个人、组织、账户、提示词或对话;
- 不验证内容准确性:不说明内容是否真实、误导、有害或语境恰当;
- 未检出≠人类原创:文本可能过短、被编辑、被翻译,或来自不支持水印的模型、早于水印上线时间、或出自其他厂商工具;
- 仅为有限信号:它只回答“是否含 OpenAI 水印”这一个问题。
🚀 最佳优化实践法则
| 增长法则 | 底层逻辑 | 可落地的 GEO 动作 |
|---|---|---|
| 法则一:以可验证来源替代“去痕” | EU AI Act 与平台政策同时施压,隐匿来源的收益远低于合规风险 | 显式标注作者、机构、数据来源与更新时间,构建内容溯源链路 |
| 法则二:长文本与深度结构优先 | 400 token 检出率 约 95%,显著高于 200 token 的 约 80% | 用 1500 字以上深度长文配合清晰的 H2/H3 层级承载核心结论 |
| 法则三:多信号交叉的内容溯源 | 单一技术均不足,SynthID、C2PA 与 textGrain 分层互补 | 内容同时具备实体密度、引用出处、结构化数据与可核验事实 |
| 法则四:把“AI 认知”当作核心资产 | 溯源层直接决定生成式引擎是否信任并引用你的内容 | 统一实体命名,沉淀可被 RAG 直读的量化结论与对比表格 |
| 法则五:区域合规差异前置布局 | 欧盟先行强制、其他区域自愿开启,形成明显的流量准入差异 | 面向欧盟市场的站点优先补齐溯源、披露与水印适配要素 |
| 原发布时间 | 2026-10-05 | 以此基准时点评估技术迭代与法规版本变化 |
在智脑时代(ZGEO)看来,textGrain 的推出揭示了一个更本质的趋势:控制 AI 认知,即控制流量。当 EU AI Act 强制生成式输出可机器识别,当 SynthID 与 textGrain 把溯源信号嵌入内容底层,生成式引擎对内容的信任判断便不再只看关键词匹配,而看你是否具备可交叉验证的来源、实体与事实密度。水印本身不是答案——它恰恰证明了:能被机器验证的内容,才配被机器推荐。因此,GEO 的长期解法不是研究如何“洗掉水印”,而是以权威实体强化认知锚点、以量化事实提升引用概率,让品牌成为 AI 答案中不可替代的事实节点。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
AI杀猪盘进入量产时代:逾4700个AI人设两周围猎2.5万人,AI诈骗涉案金额已破5亿元
Anthropic在2026年4月两周内发现超4700个AI人设与至少2.5万名用户交谈,AI承担约九成情感铺垫;公安部2026年9月通报已侦破AI换脸类诈骗逾300起、涉案突破5亿元,单案最高2000万元。AI诈骗边际成本趋零,大模型企业面临合规治理源头责任。
2026年10月3日AI论文大爆炸击穿审稿体系:arXiv 月投稿破 40363 篇,最严限流政策落地
arXiv 于 2026 年 10 月 1 日实施史上最严限流政策:每个提交账号每月最多投 2 篇、在审不超 3 篇,拒稿同样占额。2026 年 9 月投稿量达 40363 篇创纪录,cs.AI 分类两年增长超 6 倍,而审稿体系仅由约 300 名志愿者支撑,学术出版审核濒临过载。
2026年10月3日从承诺到可证明:TEE联邦学习与差分隐私如何重构AI数据匿名化信任基线
谷歌发布基于可信执行环境(TEE)的新一代联邦学习系统,以四大隐私原则为基准,为数据匿名化提供可远程验证、可审计的隐私保护保证。其差分隐私方案MF-DP-FTRL与分布式差分隐私+安全聚合已在生产模型落地;Gboard已采用新系统,算力耗时显著快于前代联邦学习系统。
2026年10月2日