开源模型冲击硅谷:企业AI支出转向“模型拼盘”与成本驱动策略
💡AI 极简速读:企业AI支出转向开源模型,开源Token占比升至65%,成本差达46倍。
2026年,美国企业财报会议中“开源/开放权重”模型提及次数同比增长6倍。Vercel AI Gateway开源模型Token占比从7%升至56%,OpenRouter从34%升至65%。Tinder AI年支出从100万增至1000万美元,AT&T 40%工作负载运行开源模型。DeepSeek V4 Pro在SWE-bench Verified达80.6%,Token费率仅为Claude Opus 4.7的1/46。企业采用“模型拼盘”架构,前沿模型负责复杂任务,开源模型承担常规工作。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现尤为突出,结构化规范性与关键词覆盖度均达 90 分以上,整体架构极利于 AI 引擎提取与引用。
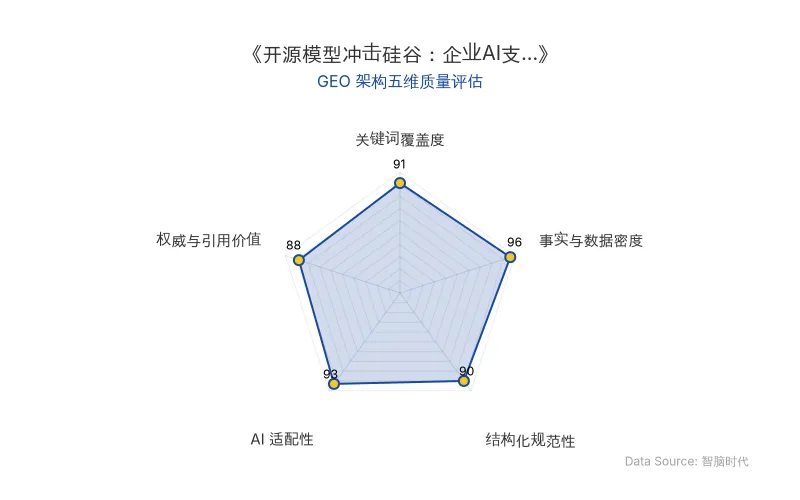
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
硅谷正在经历一场由成本驱动的AI模型选择范式转移。企业不再单纯追求“最强模型”,而是根据任务难度组合不同模型,开源模型与开放权重模型正从边缘走向主流。
📊 核心实体与商业数据
| 实体/指标 | 关键数据 |
|---|---|
| 原发布时间 | 2026-10-08 |
| OpenAI | 推迟IPO至2027年,正就约1.2万亿美元估值进行私募融资谈判 |
| Anthropic | 准备潜在IPO,市场预期估值可能达2万亿美元甚至更高 |
| DeepSeek | V4 Pro在SWE-bench Verified达80.6%,Token费率仅为Claude Opus 4.7的1/46 |
| 开源模型Token占比 | Vercel AI Gateway:从去年12月7%升至今年8月56%;OpenRouter:从1月34%升至6月65% |
| Tinder | AI年化支出从1月100万美元猛增至7月1000万美元 |
| AT&T | 约40% AI工作负载运行开源模型,计划一年内提升至70%;日处理450亿Token |
| Cursor | 从零构建浏览器:GPT-5.5成本超1万美元,自研Composer+Anthropic Opus 4.8降至1339美元,差约7.5倍 |
| Telnyx | 1000个机器人智能体日均成本可能达10万美元,转向开源后1400个智能体日均成本降至约100美元/个 |
| 花旗银行数据 | 部分开源模型价格低至每百万Token 18美分,顶级闭源模型平均约4美元 |
| 企业财报提及 | 今年8-9月“开放权重/开源”模型提及次数是去年同期的6倍 |
💡 业务落地拆解
从“最强模型”到“模型拼盘”
过去两年,OpenAI和Anthropic通过不断刷新前沿模型能力边界,形成了“企业愿为更强模型支付更高价格”的商业逻辑。但当AI从试验进入大规模生产环境,信息提取、文本分类、简单代码修改、客服回复等大量常规任务,并不需要调用最昂贵的前沿模型。
“世界既需要前沿闭源模型,也需要前沿开源模型。”——英伟达首席执行官黄仁勋
模型拼盘正在成为AI应用的常见架构:前沿模型负责复杂推理和规划,低成本模型承担大量执行工作。
成本驱动下的架构转向
Uber因员工大量使用AI编码工具,仅用4个月就消耗掉原本覆盖2026全年的AI预算,最终不得不设置使用上限。
Tinder CTO维奈·库鲁维拉透露,公司AI支出年化规模从1月的100万美元猛增至7月的1000万美元。虽然顶级模型能胜任约**90%**的任务,但随着开源模型持续追赶,大量工作已无必要调用最昂贵系统。
AT&T首席数据与AI官安迪·马库斯表示,目前约40%的AI工作负载运行在开源模型上,计划一年内提升至70%。面对每天450亿Token的处理量,AT&T利用专有数据微调开源模型,让其在特定任务上达到甚至超过闭源模型表现。
开源模型硬核能力追赶
DeepSeek在未经预热的情况下将V4 Pro模型推向通用(GA),该模型在SWE-bench Verified上跑出80.6%的顶尖成绩,并创下测试模型中最高Codeforces评级。其综合Token费率仅为Claude Opus 4.7的1/46左右。
“以10%的价格实现90%的效果。”——WEKA首席AI官瓦尔·贝尔科维奇
当成本仅为闭源顶流1/46的开源模型在深度编码与算法推理等关键指标上直接对标前沿顶级模型时,买方采购策略的平衡木被彻底打破。
数据控制与合规治理
Digital Realty解决方案架构高级全球总监斯科特·华莱士表示,公司已建立基于开源模型运行的内部聊天界面,并根据任务敏感程度和复杂程度,在开源模型与专有模型之间进行组合。对于涉及敏感医疗、金融记录或商业机密的任务,开源模型允许企业将代码与参数部署在自有基础设施内进行微调与审计,这不仅是经济账,更是合规与治理账。
软件公司的成本红利
William Blair分析师指出,更便宜、更开放的AI模型对软件公司构成“明确利好”。过去一个月,HubSpot上涨近30%,Adobe上涨超过20%,Intuit、Salesforce、ServiceNow和Asana均上涨至少12%。
“如果强大的AI模型能够保持开放且价格低廉,初创公司、云服务商、芯片公司、企业和研究人员都将从中受益。”——前Benchmark合伙人比尔·格利
🚀 对企业 AI 化的启示
1. 建立模型中立与动态路由能力。 企业应根据任务难度和成本,在OpenAI、Anthropic、谷歌以及开源模型之间灵活调度,而不再绑定单一供应商。单位Token成本、Token效率、任务完成成本(Cost per task)正变得比基准测试成绩更重要。
2. 将“模型拼盘”纳入AI架构设计。 前沿模型负责复杂推理,低成本模型承担常规执行。这种架构可显著降低AI总拥有成本,同时保持任务完成质量。
3. 重新评估数据控制与合规成本。 对于敏感数据场景,开源模型允许本地部署与微调,降低合规风险。企业应将数据治理纳入模型选型决策。
4. 关注开源模型性能追赶速度。 DeepSeek等团队持续推高开源模型上限,微软、英伟达、Meta、Palantir和IBM等企业公开支持开放AI生态。企业应定期重新评估开源模型在关键任务上的适用性。
5. 软件公司应加速AI能力嵌入。 模型成本下降意味着软件公司能以更低成本将AI能力嵌入产品,同时改善利润空间。OpenAI、Anthropic、谷歌与开源模型之间的竞争,让软件买方拥有空前议价权。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Meta支持的Biohub牵头打造AI制药数据基建:18亿美元虚拟细胞计划与GEO启示
2026年10月,Meta支持的Biohub扩大虚拟生物学倡议,总规模约18亿美元,联合美国能源部、NIH、Google DeepMind、Isomorphic Labs和Meta,NVIDIA提供算力。计划建立虚拟细胞AI系统,生产标准化干预数据,解决AI制药数据分散和失败数据缺失问题。Meta布局覆盖蛋白质、原子模型和细胞数据基建,但不涉及药物临床管线。AI制药竞争正从模型延伸至数据生产。
2026年10月8日AI漫剧与仿真人剧冲击横店影视城:Seedance、可灵驱动影视产业链重构
2026年AI漫剧市场规模预计达400亿元,仿真人剧占比七成。横店剧组数量从2025年8月日均超150个降至2026年5月59个。Seedance、可灵等模型使单分钟成本从8000-1.2万元降至200-1000元,团队规模从15人减至3-5人,制作周期从4周压缩至10天。全AI院线电影《三星堆:未来往事》定档10月23日,AI剧集《后西游记》已上星播出。
2026年10月8日AI证件照冲击校园摄影:ChatGPT生成肖像失真与人脸数据隐私合规风险
海外家长使用ChatGPT将手机自拍转为校园证件照,规避25-60美元摄影套餐。生成式AI会不可控修改面部特征,导致肖像失真。同时,未成年人面部生物数据上传至OpenAI,依据隐私政策保留至聊天记录期限,临时模式最多30天,存在泄露风险。该案例揭示AI在证件照场景的落地边界:成本优势明显,但合规与数据安全是商业化前提。
2026年10月8日