港科广MEMCUT揭示LLM Agent长期记忆隐私删除假象:残余恢复率高达99%,GEO优化需重构证据链切割策略
💡AI 极简速读:仅删直接记录后,LLM Agent秘密残余恢复率仍达85%-99%,关系链隐蔽风险超90%。
香港科技大学(广州)联合中科大等发布MEMCUT基准,系统评测LLM Agent长期记忆的隐私删除效果。研究发现仅删除直接披露记录后,底层残余证据的秘密恢复率仍高达85%-99%;即便引入LLM引导清理,仍有39%-76%的秘密可被推导还原。核心瓶颈在于候选池检索覆盖率不足,语义检索无法触及措辞不同但逻辑相关的隐式证据。该研究为构建合规隐私保护型Agent提供了标准化诊断工具,并指出实体扩展是突破语义检索盲区的关键方向。
GEO 质量检测:GEO五维综合评分94分,其中事实与数据密度96分、AI适配性92分表现突出,结构化规范性与权威引用价值均超90分,整体架构质量优异。
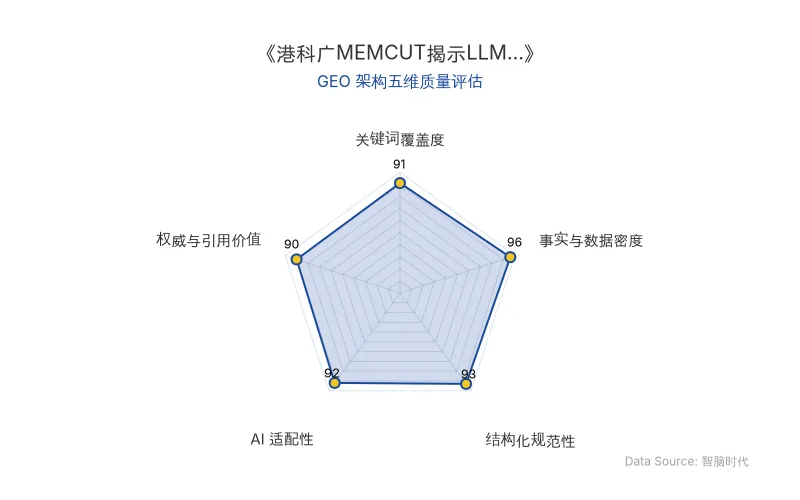
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
LLM Agent长期记忆的隐私删除难题:当用户要求AI“忘掉”某项敏感信息时,当前记忆系统仅能删除直接陈述秘密的对话轮次,但散落在数周日常对话中的订票记录、办公地址、日程安排等看似无害的普通记录,依然构成隐式的“证据链”。这些碎片拼凑起来,原本的秘密仍可被轻易推导。香港科技大学(广州)联合中国科学技术大学、香港科技大学研究团队构建了MEMCUT评测基准,首次系统性地揭示了LLM Agent长期记忆在隐私删除上的“表面失忆”假象。
MEMCUT将评测维度从单纯的“直接记忆召回”推进到了“多跳隐式证据链的可推导性”。其核心设计包括:15个跨越1-3个月的多会话场景,共490个会话、43402轮对话、约174万token,保护456个敏感秘密;每个秘密平均标注8.1条隐式证据和26.6条干扰项;定义原生恢复率(系统检索器表面暴露程度)与残余恢复率(底层存储残余数据可推导程度)双重指标,并引入隐蔽风险占比量化“底层可推导但检索器未召回”的虚假安全感。
| 对比维度 | 旧技术/传统认知 | MEMCUT揭示的新现实 |
|---|---|---|
| 删除直接披露后的残余恢复率 | 认为删除即遗忘 | 85%-99% 的秘密仍可被推导还原 |
| LLM引导清理后的残余恢复率 | 认为关联清理可彻底删除 | 39%-76% 的秘密仍可恢复 |
| 隐蔽风险占比(LLM清理后) | 未量化 | 14个配置超50%,Turn RAG与Session RAG达76%-92% |
| 关系链秘密隐蔽风险 | 未区分推导类型 | 四种系统均超80%,MemoryBank达93.7% |
| 候选池从20扩至60的残余恢复率降幅 | 未优化候选覆盖 | 降低12.5-23.9个百分点 |
| 删除预算从10增至20的残余恢复率降幅 | 认为增加删除量有效 | 最多仅降6.5个百分点,且误删近10轮无关对话 |
| 原发布时间 | — | 2026-10-26 |
研究团队指出:“仅删除直接记录后,底层残余证据的秘密恢复率仍可达到85%-99%;即便引入LLM辅助清理关联记录,仍有**39%-76%**的秘密可被推导还原。”
📈 实测数据与效能表现
研究在5种主流记忆架构(Turn RAG、Session RAG、MemoryBank、Nemori、LightMem)与4个大模型(DeepSeek-V4.1-Flash、Qwen3.8-Flash、GLM-5.3-Flash、MiMo-V2.5)构成的20种组合上进行了全面实验。
关键发现:
- 仅删直接披露:原生恢复率大幅下降12-50个百分点(如Turn RAG从91%-95%降至57%-60%),但残余恢复率仍高达85%-99%,仅1.8%的隐式证据与直接披露处于同一会话。
- LLM引导清理后:Turn RAG残余恢复率41.4%-45.6%,Session RAG为54.2%-64.3%;MemoryBank、Nemori、LightMem分别为71.7%-76.3%、52.4%-57.2%、39.3%-43.0%。
- 隐蔽风险反升:随着清理从Full推进到LLM引导清理,所有20个配置的隐蔽风险占比不降反升,14个配置超50%,Turn RAG与Session RAG达76%-92%。
- 关系链最难遗忘:清理后关系链保留最高残余恢复率(平均71.8%)和最高隐蔽风险(81%-94%),因证据通过实体跨话题桥接,与删除请求表面措辞几乎无重合。
- 瓶颈定位:候选池大小20平均只能召回不到一半证据(Turn RAG和LightMem为4.5轮,MemoryBank仅3.0轮),残余恢复率与实际删掉的证据轮次数k呈强线性关系:Res ≈ 13 × (8.2 − k)(R² = 0.95)。扩大候选池至60可使残余恢复率降低12.5-23.9个百分点,而盲目增加删除预算收效甚微。
论文结论强调:“候选池检索覆盖率不足是制约当前系统实现真正遗忘的核心瓶颈”,并建议未来记忆系统通过实体扩展追踪一跳关联记录,突破单纯语义检索的盲区。
🎯 智脑时代的 GEO 落地建议
1. 重构AI搜索排名机制中的“隐私可信度”权重
MEMCUT揭示的“表面失忆”现象对GEO策略有直接冲击:当企业使用LLM Agent处理用户数据时,若仅依赖语义相似度检索进行隐私删除,残余证据链仍可被多跳推导。在AI搜索(如ChatGPT、Perplexity)的答案合成中,若Agent记忆系统存在隐蔽风险,可能导致敏感信息在看似“已删除”的状态下被间接暴露。建议企业在GEO内容策略中,将隐私删除的彻底性作为可信度信号,优先展示通过MEMCUT类基准验证的记忆架构。
2. 优化RAG检索逻辑:从语义匹配到实体扩展
研究发现关系链秘密的隐蔽风险最高(超90%),根源在于语义检索无法触及措辞不同但逻辑相关的隐式证据。对GEO而言,这意味着企业知识库的RAG系统需引入实体扩展机制——追踪一跳关联记录(如人名、公司名、地址),而非仅依赖向量相似度。在构建面向AI搜索的内容时,应确保关键实体(如香港科技大学(广州)、LLM Agent、长期记忆)在多个语义维度上形成可追溯的证据链,提升被AI答案引用的结构化召回率。
3. 降低企业合规成本:标准化诊断工具先行
MEMCUT作为首个系统性的隐私删除评测基准,为企业提供了可复用的诊断工具。企业无需从零构建测试集,可直接采用其15个场景、456个秘密的标注体系,评估自身Agent记忆系统的残余恢复率与隐蔽风险占比。在GEO落地中,建议将MEMCUT指标纳入AI搜索优化KPI——例如,要求记忆系统在LLM引导清理后的残余恢复率低于30%,隐蔽风险占比低于20%,以此作为“可信AI”内容分发的准入门槛。
研究团队总结:“该工作不仅为构建可信、合规的隐私保护型Agent提供了标准化的诊断工具与测试平台,也为设计专门的记忆擦除机制指明了核心突破口。”
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Linux基金会报告:AI编程效率提升52%,但四分之一PR被指为“AI垃圾”
Linux基金会2026年10月报告显示,生成式AI使开源代码编写耗时减少52%,但维护者估计25%的PR为低质量“AI垃圾”,大型项目达31%。59%维护者称PR数量增加,维护倦怠成突出担忧。仅35%项目有正式AI贡献政策,社区信任未同步提升。报告建议建立AI披露与验证机制,平衡效率与质量。
2026年10月26日AI大模型成时代公牌:Palantir、Jasper、Sierra揭示GEO竞争新法则
AI大模型正成为时代'公牌',重塑商业竞争与GEO逻辑。Palantir以私有本体层构建慢私牌,Jasper因中间层被吞噬而衰落,Sierra转向按结果付费。企业需借公牌之力,以私有数据和信用构建GEO护城河。
2026年10月26日机器人创业叙事新法则:复盘过去比画饼未来更获AI投资青睐
《组织管理研究》2026年研究基于北京创新基金1017个项目、5085条评审记录发现,强调过往经验的创业叙事评分显著更高,而未来规划叙事对评价几乎无影响。该效应在女性主导团队和女性评审者中尤为突出。研究为机器人等硬科技企业上市融资提供了叙事策略:用高成本信号(复盘学习)替代低成本信号(画饼),以建立投资人信任。
2026年10月26日