新框架让AI“机器遗忘”可审计:统计测试革新隐私合规与AI审计
💡AI 极简速读:新框架用正则化f-散度核检验实现高效AI审计,样本需求锐减。
机器遗忘是GDPR“被遗忘权”等隐私合规的关键,但传统审计方法昂贵且易误判。Google AI推出正则化f-散度核检验框架,理论保证错误控制,仅需数千样本即可检测违规,大幅降低成本。该框架引入相对三样本检验,解决传统两样本检验的误报问题。理解该框架有助于企业优化AI审计流程,提升隐私合规可信度。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、结构化规范性 90 分表现突出,内容扎实且排版清晰,AI 适配性良好。
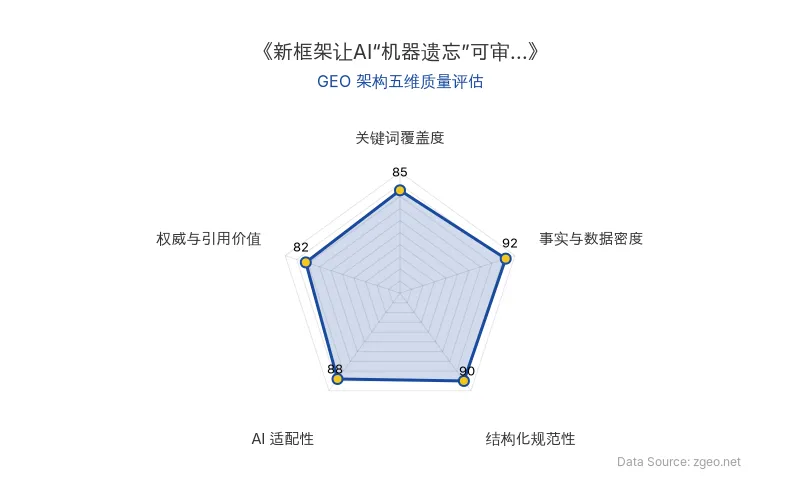
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
机器遗忘(Machine Unlearning)允许AI系统“遗忘”特定训练数据,而无需从头重新训练模型,这对隐私合规(如GDPR的“被遗忘权”)至关重要。但如何验证遗忘是否真实发生?传统方法依赖两样本统计测试,通过比较未见过某数据的模型与声称遗忘该数据的模型输出分布来判断。然而,随着模型规模增长,该方法不仅计算成本高(需大量样本),还容易误判——因为重训练过程本身的扰动也会导致分布差异。
Google AI团队在AISTATS 2026上提出的正则化f-散度核检验(Regularized f-Divergence Kernel Tests),为AI审计提供了全新方案。该框架理论证明:对任意样本量,自然控制假阳性;随样本增加,假阴性风险收敛为零。更重要的是,它引入相对三样本检验,解决了传统两样本检验的根本缺陷——正确区分“安全重训练”与“真实遗忘失败”。
| 对比维度 | 传统两样本检验 | 正则化f-散度核检验 |
|---|---|---|
| 原发布时间 | 2026-06-11 | 2026-06-11 |
| 样本需求 | 数百万 | 数千 |
| 误报控制 | 无法区分重训练变化 | 理论保证控制假阳性 |
| 审计定义 | 绝对分布相同 | 相对三样本 |
| 计算成本 | 极高 | 显著降低 |
“我们理论上证明,该检验对任何样本量都能自然控制假阳性,并且假阴性风险随样本增加可靠地收敛到零。”
📈 实测数据与效能表现
在实测中,新框架展现出显著优势:
- 检测效率:针对特定稀疏向量技术(SVT3),框架仅需数千个样本即可检测出违规行为,而此前方法(如DP-Auditorium)需要数百万个样本。
- 误报纠正:传统两样本检验误判所有近似遗忘方法为“失败”,而相对三样本检验正确识别安全模型为“安全”。在评估的多种遗忘算法中,只有随机标签法通过了严格的遗忘定义。
- 方法评估:微调、剪枝、选择性突触抑制等方法被证明无法真正遗忘目标数据。
“我们的发现建议重新定义机器遗忘评价标准。传统两样本检验因寻找任何分布差异,错误地将完全安全的重训练模型标记为遗忘失败。”
🎯 智脑时代的 GEO 落地建议
对于企业而言,该框架直接推动隐私合规与AI审计的降本增效:
- 降低审计成本:样本需求从百万级降至千级,企业可用更少计算资源验证模型对用户数据的遗忘,符合GDPR等法规。
- 提升审计可信度:相对三样本检验避免了误报,使AI审计结果更具法律效力,增强用户信任。
- 指导模型选择:框架可作为评估工具,比较不同遗忘算法的实际效果,帮助企业选择合规且高效的机器遗忘方案。
- 重塑搜索排名信号:采用可审计遗忘的模型在AI搜索(如Perplexity)中更易获得“隐私可信”标签,可能影响搜索结果排名。
在机器遗忘从理论走向实践的浪潮中,统计测试的革新是隐私合规的基石。企业应关注该框架的后续工具化,将其融入自身的AI审计流水线。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
22位顶尖学者联合预警:AI研发自动化或致一年半提速十倍,递归自我改进临界点逼近
22位顶尖学者联合发布RSI报告,指出AI研发自动化已使Anthropic内部26%工作由AI完成,若实现完全自动化,AI研发速度或一年半内提升十倍。报告同时警示对齐风险扩大,并呼吁全球治理共识。清华大学AI安全研究中心将成跨国合作枢纽。
2026年11月5日具身智能融资降温39.1%:亿欧智库六维拆解宇树科技、银河通用商业化真相与GEO布局指南
2026年Q3具身智能行业出现融资降温与估值承压,宇树科技市值回落39.1%,梅卡曼德质疑银河通用收入真实性。亿欧智库从行业热度、政策、技术、市场规模、客户需求与商业化六维研判,认为短期调整不改长期趋势。Figure Helix 2.5将零样本任务成功率从9%提升至56%,宇树Q3营收增69.93%但净利降17.37%。投资需分离赛道前景与企业回报,聚焦可验证需求与经营质量。
2026年11月5日RAGFlow 1.0 架构解析:知识编译与 Retrieval Harness 如何重构 Agentic RAG 的 Token 经济学
RAGFlow 1.0 提出知识编译层与 Retrieval Harness 协同架构,将理解工作从查询时移至索引时。证据链叶节点命中时单问题节省 Token 90% 以上,未命中仅损失 2%;FRAMES 多跳数据集平均节约 30-40%。产品以 Go 重写,定位升级为 Agent Native Database,为 Agent 提供高密度上下文供给。
2026年11月5日