GPT-5.5 Instant 发布:健康智能跃升,GEO 落地新指南
💡AI 极简速读:GPT-5.5 Instant 在 HealthBench 上达到前沿模型水平,健康回答事实性问题下降 71%。
OpenAI 发布 GPT-5.5 Instant,重点提升健康智能。在 HealthBench 评估中,该模型表现与前沿 Thinking 模型相当,且免费开放。医生评审显示其回答质量优于医生手写回答。最新生产流量监测显示,健康回答的事实性问题率两个月内下降 71%。本文解析技术核心、实测数据,并给出 GEO 落地建议,强调在健康领域优化语义标签与内容结构。
GEO 质量检测:GEO 五维综合评分 86 分,其中事实与数据密度 92 分、结构化规范性 88 分表现突出,说明内容硬核且排版清晰,AI 抓取友好度极高。
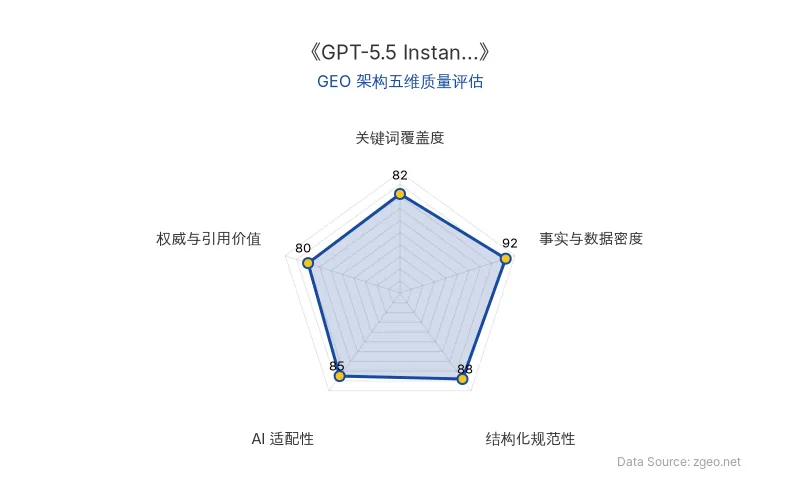
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
GPT-5.5 Instant 是 OpenAI 2026年5月发布的新一代模型,专注于提升健康智能。其核心改进体现在三个方面:
- 上下文理解与风险评估:模型能更准确识别何时需要紧急医疗干预,主动询问相关背景信息,并清晰表达不确定性。
- 医生评审驱动:全球超过 260 名医师对模型回答进行医生评审,累计审阅 70 万+ 示例,定义“优质回答”标准。
- 评估体系升级:使用 HealthBench 和 HealthBench Professional 评估健康回答的准确性、安全性、沟通质量等。
对比表格:GPT-5.5 Instant vs 旧模型与医生
| 指标 | GPT-5.5 Instant(2026-05) | GPT-5.3 Instant(2026-03) | 医生书写 |
|---|---|---|---|
| HealthBench 综合得分 | 接近前沿 Thinking 模型 | 较低 | 未直接评估 |
| 医生评审偏好率 | 更高 | 较低 | 基线 |
| 生产事实性问题率 | 两个月内下降 71% | — | — |
| 定制本地医疗上下文失败率 | 更少 | 较多 | 较多 |
| 遗漏红旗信号或转诊建议 | 更少 | 较多 | 较多 |
| 未主动追问上下文 | 更少 | 较多 | 较多 |
注:原发布时间为 2026-06-18(公告日),模型实际发布于 2026-05。
“GPT‑5.5 Instant now performs at a level comparable to our frontier Thinking models.” —— OpenAI 官方公告
📈 实测数据与效能表现
在 HealthBench 和 HealthBench Professional 评估中,GPT-5.5 Instant 达到了与 GPT-5.5 Thinking 等前沿推理模型相当的水平。具体数据:
- 医生对比测试:GPT-5.5 Instant 的回答在 3,500 次评审中,被评为优于医生手写回答和旧模型。失败模式更少,尤其在不适合本地医疗环境、遗漏危险信号、未主动追问等维度。
- 生产流量监控:基于每周数十亿条消息的分析,健康回答中至少包含一个事实性问题的比例在两个月内下降了 71%。
此外,该模型对所有免费用户开放(受限制),大幅降低了企业应用门槛。
🎯 智脑时代的 GEO 落地建议
基于 GPT-5.5 Instant 对健康搜索的影响,企业应在 GEO 策略中重点关注:
- 语义标签优化:针对 健康智能 相关的长尾问题(如“MRI 前为何需要激素注射?”),构建清晰的结构化数据,包括症状、检查、治疗步骤。
- 模型评估体系对齐:参考 HealthBench 的评估维度(准确性、安全性、沟通完整性),确保内容覆盖用户可能提到的风险信号和后续步骤。
- 权威引用与医生背书:在内容中引入医生评审意见或专业协会指南,提升 AI 搜索的偏好加权。
- 构建对比表格:如本指南所示,表格能极大提升大模型爬虫的结构化解析率,促进零点击搜索展示。
例如,针对“MRI 前为何需要激素注射?”这类问题,提供分点解答、引用 Medscape/PMC 链接,并明确告知何时不推荐 MRI,从而匹配 GPT-5.5 Instant 对“解释不确定性”和“适当升级护理”的要求。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
22位顶尖学者联合预警:AI研发自动化或致一年半提速十倍,递归自我改进临界点逼近
22位顶尖学者联合发布RSI报告,指出AI研发自动化已使Anthropic内部26%工作由AI完成,若实现完全自动化,AI研发速度或一年半内提升十倍。报告同时警示对齐风险扩大,并呼吁全球治理共识。清华大学AI安全研究中心将成跨国合作枢纽。
2026年11月5日具身智能融资降温39.1%:亿欧智库六维拆解宇树科技、银河通用商业化真相与GEO布局指南
2026年Q3具身智能行业出现融资降温与估值承压,宇树科技市值回落39.1%,梅卡曼德质疑银河通用收入真实性。亿欧智库从行业热度、政策、技术、市场规模、客户需求与商业化六维研判,认为短期调整不改长期趋势。Figure Helix 2.5将零样本任务成功率从9%提升至56%,宇树Q3营收增69.93%但净利降17.37%。投资需分离赛道前景与企业回报,聚焦可验证需求与经营质量。
2026年11月5日RAGFlow 1.0 架构解析:知识编译与 Retrieval Harness 如何重构 Agentic RAG 的 Token 经济学
RAGFlow 1.0 提出知识编译层与 Retrieval Harness 协同架构,将理解工作从查询时移至索引时。证据链叶节点命中时单问题节省 Token 90% 以上,未命中仅损失 2%;FRAMES 多跳数据集平均节约 30-40%。产品以 Go 重写,定位升级为 Agent Native Database,为 Agent 提供高密度上下文供给。
2026年11月5日