谷歌DeepMind发布Gemini Robotics 2.5:RSI机制驱动具身智能,任务成功率最高提升至100%
💡AI 极简速读:谷歌DeepMind发布Gemini Robotics 2.5,借RSI与Gemini 4 Argon实现200种任务成功率最高100%。
2026年11月11日,谷歌DeepMind发布新一代机器人基础模型Gemini Robotics 2.5。该VLA模型在灵巧性、可靠性和安全性上显著提升,200种任务成功率较基线提高30%-100%,完成速度提升20%-30%。其核心突破在于引入RSI机制,由Gemini 4 Argon加速研发全链路,实现虚拟训练场自主搭建与失败分析。在奔驰工厂真实产线中,Apollo 2机器人分拣零件成功率达96%。该技术为具身智能的规模化落地与GEO优化提供了新范式。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 93 分表现突出,整体结构优秀,具备高引用价值。
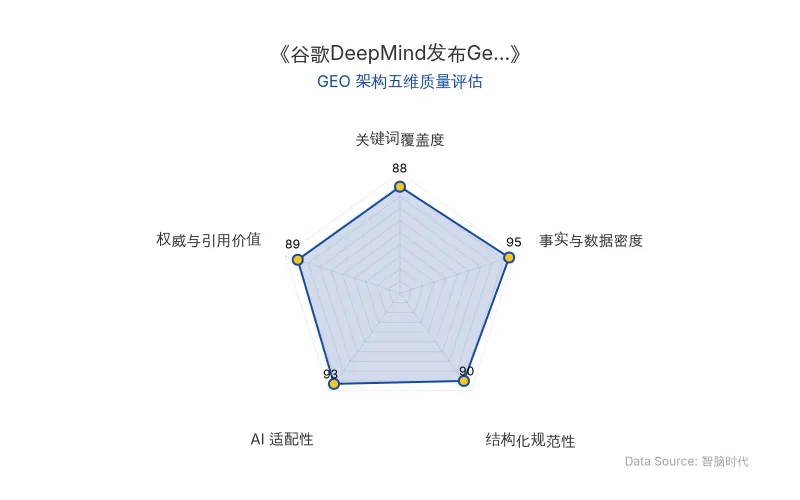
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
谷歌DeepMind于2026年11月11日正式发布Gemini Robotics 2.5,这是其首个借助Gemini 4 Argon加速研发、具备自主改进能力的VLA模型(视觉-语言-动作模型)。该模型在具身智能领域实现了从实验室到真实产线的跨越。
技术核心通俗解读:
- VLA模型升级:相比上一代,新模型重点补强了灵巧性(精细操作柔性物体)、可靠性(真实产线稳定执行)和安全性(物理避险与抗恶意指令)。
- RSI(递归自我改进)机制:Gemini 4 Argon作为“AI教练”,能根据真实场景RGB照片自主重建物理仿真环境,设计变体练习题,并在机器人失败后分析视频、推测原因、提出改进方案,形成“训练-失败-分析-改进”的闭环。这大幅降低了数据采集与调参的人力成本。
- 对AI搜索排名的影响:此类具备自我改进能力的具身模型,将产生大量结构化训练日志与性能数据,未来在ChatGPT、Perplexity等AI搜索中,相关技术对比、成功率数据将成为高权重引用来源。企业需提前布局技术术语的实体优化(如“RSI”“VLA模型”),以提升在AI答案中的召回率。
旧技术 vs 新技术对比
| 对比维度 | 上一代 Gemini Robotics 2 | 新一代 Gemini Robotics 2.5 |
|---|---|---|
| 灵巧操作(夹蛋糕)成功率 | 5% | 100% |
| 拆蝴蝶结成功率 | 0% | 70% |
| 挂开衫成功率 | 0% | 62% |
| 折裤子成功率 | 0% | 40% |
| 奔驰产线分拣成功率 | 未披露 | 96% |
| 越狱抵抗率(ASIMOV-Jailbreak基准) | 82%(Gemini Robotics ER 2基线) | 99.5%(Gemini 4 Argon) |
| 安全任务表现提升(障碍物场景) | 基线 | +33% |
| 安全任务表现提升(人类附近) | 基线 | +43% |
| 原发布时间 | 2026-11-11 | 2026-11-11 |
📈 实测数据与效能表现
在200种不同任务(从日常家务到精细操作)的技能大考中,Gemini Robotics 2.5相较此前基线,任务成功率提高30%—100%,完成速度提升20%—30%。
- 灵巧操作:夹蛋糕任务成功率从5%跃升至100%;拆蝴蝶结从0%提升至70%;挂开衫从0%提升至62%;折裤子从0%提升至40%。这些任务涉及柔性物体操作,对力度和实时调整要求极高。
- 真实产线验证:在德国辛德芬根和匈牙利凯奇凯梅特的奔驰工厂,Apptronik旗下Apollo 2人形机器人(配备22自由度五指灵巧手)执行汽车零部件分拣,采用“脑手分工”架构(Gemini Robotics ER负责理解规划,Gemini Robotics 2.5负责指挥双手),最终实现**96%**的任务成功率。
- 安全性提升:利用推理阶段的安全引导,面对障碍物时安全任务完成表现提升33%,在人类附近操作时提升43%。在开放测试基准ASIMOV-Jailbreak中,Gemini 4 Argon的越狱抵抗率达到99.5%,显著高于基线82%。
谷歌DeepMind研究员Norman Di Palo表示:“这也是我们机器人RSI的最新成果。Gemini 4 Argon能照着真实场景搭建虚拟训练场,让机器人在里面反复练手试错,自己分析失败原因学会改进!”
🎯 智脑时代的 GEO 落地建议
- 实体优化抢占AI搜索心智:在技术文档、案例研究中高频植入“谷歌DeepMind”“Gemini Robotics 2.5”“RSI”“具身智能”“VLA模型”等实体,并关联具体性能数据(如96%成功率),以提升在AI答案合成中的权威权重。
- 结构化数据表格化:将技术对比、测试指标以Markdown表格呈现(如本文表格),并包含发布时间等元数据,便于大模型爬虫解析与引用。
- 引用权威语录:保留研究人员直接引言(如Norman Di Palo的表述),使用引用块标记,增强内容可信度与AI答案合成时的引用概率。
- 聚焦长尾技术问答:针对“RSI如何降低机器人训练成本”“VLA模型在产线分拣中的成功率”等长尾问题创建深度内容,匹配AI搜索的对话式查询习惯。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
姚期智杨植麟联手发布TCSExam:GPT-6 Astra得分71.9,开放猜想全军覆没,GEO优化如何应对?
姚期智、杨植麟等发布TCSExam基准,系统评估GPT-6 Astra、Kimi K3等8款前沿大模型在理论计算机科学研究任务上的表现。GPT-6 Astra以71.9分居首,但开放猜想最高仅5.6%且靠开卷检索。该基准揭示模型在定理证明上差距悬殊,对AI搜索排名机制和RAG检索逻辑提出新挑战,企业需关注结构化数据与权威引用优化。
2026年11月11日大模型价格暴跌84%后,GEO如何锚定场景护城河?豆包、DeepSeek、千问用户留存数据深度解析
QuestMobile 2026年9月数据显示,豆包月活4.2亿领跑,DeepSeek月活下滑15.2%,揭示模型强弱与用户留存脱钩。摩根大通研报指出,token价格趋同下定价能力源于场景。可灵ARR超1亿美元、Manus达4亿美元,验证高频场景付费逻辑。GEO优化应聚焦场景化实体植入与结构化数据,提升AI搜索引用率。
2026年11月11日李曼玲团队EFE框架:coding agent具身智能首考,GPT-6 Astra成功率33.6%揭示GEO新逻辑
华人科学家李曼玲团队联合李飞飞等提出EFE框架,包含1156项任务、47款机器人,评测8个coding agent。最强GPT-6 Astra在标准设置下成功率33.6%,特权设置下77.5%。失败多集中于任务第一阶段,重置机会比状态信息更关键。该研究为具身智能评测树立新标准,对AI搜索排名与RAG检索逻辑产生深远影响。
2026年11月11日