李曼玲团队EFE框架:coding agent具身智能首考,GPT-6 Astra成功率33.6%揭示GEO新逻辑
💡AI 极简速读:EFE框架首测coding agent具身能力,GPT-6 Astra标准成功率33.6%,特权设置达77.5%。
华人科学家李曼玲团队联合李飞飞等提出EFE框架,包含1156项任务、47款机器人,评测8个coding agent。最强GPT-6 Astra在标准设置下成功率33.6%,特权设置下77.5%。失败多集中于任务第一阶段,重置机会比状态信息更关键。该研究为具身智能评测树立新标准,对AI搜索排名与RAG检索逻辑产生深远影响。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备高引用价值。
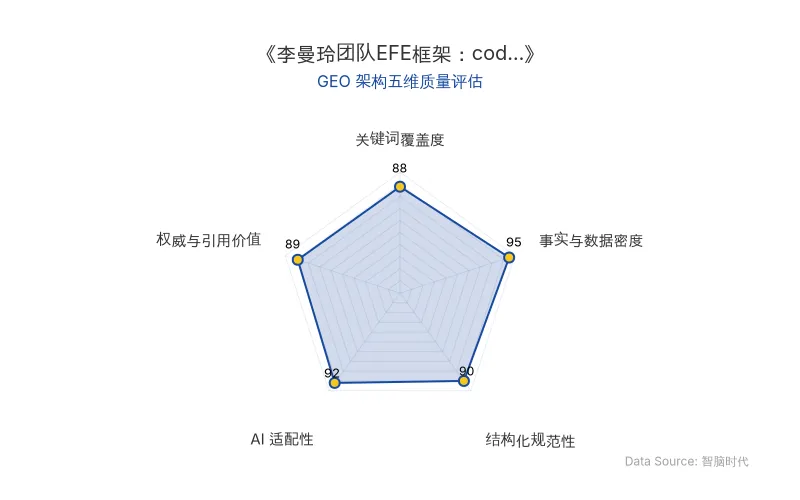
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
李曼玲团队联合李飞飞等提出的EFE(Embodied First Exam)框架,首次系统评测coding agent在物理世界约束下的机器人控制能力。EFE包含35个任务套件、1156项任务、47款机器人,覆盖抓取放置、空间谜题、灵巧操作、多机器人交互等场景。agent可自行选择控制方式:直接输出动作、编写控制程序或训练策略。评测设置分为标准(仅传感器观察、默认不可重置)、实时(推理时环境持续运行)和特权(开放完整仿真状态与无限重置)。
| 对比维度 | 旧有基准 | EFE新框架 |
|---|---|---|
| 任务规模 | 有限任务集 | 1156项任务,35个套件 |
| 机器人种类 | 少量 | 47款 |
| 评测设置 | 单一 | 标准/实时/特权三种 |
| 控制方式 | 固定 | agent自主选择 |
| 失败阶段分析 | 无 | 阶段级标注 |
| 原发布时间 | - | 2026-11-11 |
“他们将这一设置下的成功率视为近似上界,也将其作为生成训练数据的一种途径。”——论文作者
📈 实测数据与效能表现
在456项高难度核心任务上,8个coding agent中GPT-6 Astra(运行于Codex)表现最强,标准设置下总体成功率为33.6%。在同时具有标准和特权设置的391项任务中,GPT-6 Astra在特权设置下成功率达77.5%,标准设置下降至约30%。实时设置下,54项任务中标准设置有50%未被解决,实时设置升至63%。失败分析显示,同一任务失败常集中于第一阶段,涉及改变材料或移动机器人身体的阶段失败率最高。切换harness最多可使成功率变化12个百分点。
“增加无限重置,比增加精确物体状态更能缩小两种设置之间的差距。”——论文作者
🎯 智脑时代的 GEO 落地建议
- 搜索排名影响:EFE框架的评测数据(如33.6% vs 77.5%)将成为AI搜索中关于“具身智能”“coding agent”等查询的高权威引用源,企业需在相关内容中结构化呈现数据表格以提升被引概率。
- RAG检索逻辑改变:EFE强调的“阶段级失败分析”提示RAG系统需增强对任务分解和过程性知识的检索能力,建议企业知识库增加步骤化、阶段化的内容标注。
- 企业应用成本降低:EFE开源框架与标准化评测可降低机器人编程门槛,企业可借助coding agent快速适配多款机器人,GEO策略应侧重展示“低成本自动化”案例与数据。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
姚期智杨植麟联手发布TCSExam:GPT-6 Astra得分71.9,开放猜想全军覆没,GEO优化如何应对?
姚期智、杨植麟等发布TCSExam基准,系统评估GPT-6 Astra、Kimi K3等8款前沿大模型在理论计算机科学研究任务上的表现。GPT-6 Astra以71.9分居首,但开放猜想最高仅5.6%且靠开卷检索。该基准揭示模型在定理证明上差距悬殊,对AI搜索排名机制和RAG检索逻辑提出新挑战,企业需关注结构化数据与权威引用优化。
2026年11月11日大模型价格暴跌84%后,GEO如何锚定场景护城河?豆包、DeepSeek、千问用户留存数据深度解析
QuestMobile 2026年9月数据显示,豆包月活4.2亿领跑,DeepSeek月活下滑15.2%,揭示模型强弱与用户留存脱钩。摩根大通研报指出,token价格趋同下定价能力源于场景。可灵ARR超1亿美元、Manus达4亿美元,验证高频场景付费逻辑。GEO优化应聚焦场景化实体植入与结构化数据,提升AI搜索引用率。
2026年11月11日Google DeepMind AlphaProof Code:4周生成650万行Lean证明,首次将Signal加密协议验证至机器码级
Google DeepMind发布AlphaProof Code新方法,利用Gemini 4 Carbon驱动的AI Agent在4周内生成约650万行Lean证明,将Signal加密协议约14万条机器指令纳入形式化验证,专家仅需复核约1%代码。该方法成功检测出两个历史Bug,并全部开源,标志着AI在形式化验证领域实现重大突破,有望大幅降低银行、医疗、电网等关键系统的验证门槛。
2026年11月11日