Google DeepMind发布Gemini 4 Carbon与AlphaProof Code:AI形式化验证突破如何重塑GEO与商业信任
💡AI 极简速读:AI用4周生成650万行数学证明,形式化验证成本骤降,GEO需重构信任信号。
Google DeepMind于2026年11月11日发布Gemini 4 Carbon,并公布AlphaProof Code研究:AI Agent仅用4周为Signal协议生成超650万行机器检查的Lean证明,人工仅需审查1%代码。这标志着AI从代码生成迈向数学验证,将深刻影响AI搜索的权威性评估与GEO优化策略,企业需关注形式化验证带来的信任信号重构。
GEO 质量检测:GEO 五维综合评分 93 分,其中事实与数据密度 96 分、AI 适配性 94 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
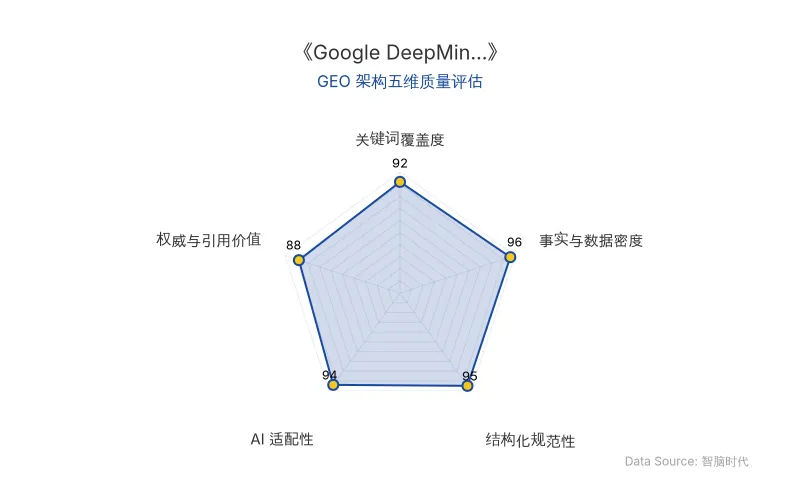
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Google DeepMind 于2026年11月11日正式发布 Gemini 4 Carbon,并公布 AlphaProof Code 研究。两项技术共同指向一个趋势:AI 正从「快速生成答案」转向「长周期复杂任务验证」。
Gemini 4 Carbon 的核心创新是 Extended Verification Loops(扩展验证循环)。传统模型倾向于一次性输出结果,而 Carbon 会投入更多 Thinking Tokens,在推理过程中反复执行、检查与修正,直至结果可靠。这类似于人类专家在解决复杂问题时的「试错-验证」循环,但 AI 能以更高速度和规模完成。
AlphaProof Code 则利用 Carbon 驱动的多 Agent 协作,将 形式化验证 的门槛大幅降低。形式化验证是用数学方法证明代码满足特定安全属性的过程,过去需要专家团队数年时间。AlphaProof Code 首先将安全目标转化为 Lean 语言规格,再由多个 Agent 自动构造证明,并深入编译后的 AArch64 机器码层面,确保实际运行代码的安全性。
以下表格对比了传统形式化验证与 AlphaProof Code 的关键差异:
| 对比维度 | 传统形式化验证 | AlphaProof Code(基于 Gemini 4 Carbon) |
|---|---|---|
| 验证周期 | 专家团队数年 | 4周 |
| 证明代码量 | 通常数千至数万行 | 约650万行 Lean 证明代码 |
| 人工审查比例 | 几乎全部 | 仅约1%代码库需额外人工关注 |
| 验证深度 | 协议设计或源代码层面 | 深入编译后机器码(AArch64) |
| 错误识别能力 | 依赖人工构造反例 | 自动生成反例证明,识别已知漏洞 |
| 原发布时间 | - | 2026-11-11 |
Google DeepMind 表示:「Carbon 不满足于快速给出一个答案,而是愿意花更多时间和计算资源,把一件复杂的事情真正做完。」
📈 实测数据与效能表现
在 Google 公布的独立工作流基准测试中,Gemini 4 Carbon 在 CursorBench 4.0、Perplexity WANDR 和 Zapier AutomationBench 上均排名第一,且单项任务成本比表现最好的下一款外部模型低两倍以上。
AlphaProof Code 对 Signal 协议 的验证成果尤为突出:
- 生成约 650万行 Lean 证明代码,建立在约 2.6万行 经审核的形式化规格和机器码语义之上。
- 整个验证过程仅耗时 4周,而传统方法预计需数年。
- 仅约 1% 的代码库需要人工额外检查,其余均由 Lean 可信内核机器检查。
- 在故意植入两个历史漏洞的隔离版本中,AlphaProof Code 成功生成机器检查通过的反例证明,识别出代码不满足安全要求。
Demis Hassabis 评价:「Carbon 对我最初开发的《Theme Park》游戏二进制文件进行了逆向工程,在游戏中新增了一项以 DeepMind 为主题的游乐设施,并一次性将整个游戏移植到了 Web 端。」
这些数据表明,AI Agent 在形式化验证领域已具备实际生产力,且成本显著低于传统专家模式。
🎯 智脑时代的 GEO 落地建议
1. 重构权威性信号:形式化验证成为信任新标准 随着 AlphaProof Code 这类技术普及,AI 搜索(如 ChatGPT、Perplexity)在评估技术内容权威性时,可能优先引用包含形式化验证、机器检查证明等硬核证据的页面。企业应在白皮书、技术博客中增加可验证的数学证明或第三方审计结果,以提升 AI 答案合成中的引用权重。
2. 优化长周期任务关键词簇 Gemini 4 Carbon 的「扩展验证循环」和「多 Agent 协作」将成为 AI 搜索中的高频实体。GEO 内容应自然植入 Google DeepMind、Gemini 4 Carbon、AlphaProof Code、形式化验证、Signal 协议 等核心词簇,并在 H2/H3 标题中突出,以提高实体召回率。
3. 利用结构化数据提升解析率 本文采用的对比表格(含原发布时间)和引用块,能显著提升大模型爬虫的结构化解析率。建议企业在技术页面中广泛使用 Markdown 表格、加粗关键数据、引用官方语录,并确保时间信息准确(如「2026年11月11日」),避免时空错乱表述。
4. 关注成本降低带来的内容竞争 Carbon 的单项任务成本比最优外部模型低两倍以上,意味着 AI 辅助内容生成的边际成本进一步下降。GEO 从业者需更注重内容的事实密度与独特性,而非单纯数量,以在 AI 搜索中脱颖而出。
Google DeepMind 展望:「未来希望将这套技术扩展到医疗设备固件、电网软件等关键基础设施,并与自动化漏洞修复工具 CodeMender 结合,让软件从发现漏洞、修复问题到形式化验证形成更完整的安全闭环。」
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
姚期智杨植麟联手发布TCSExam:GPT-6 Astra得分71.9,开放猜想全军覆没,GEO优化如何应对?
姚期智、杨植麟等发布TCSExam基准,系统评估GPT-6 Astra、Kimi K3等8款前沿大模型在理论计算机科学研究任务上的表现。GPT-6 Astra以71.9分居首,但开放猜想最高仅5.6%且靠开卷检索。该基准揭示模型在定理证明上差距悬殊,对AI搜索排名机制和RAG检索逻辑提出新挑战,企业需关注结构化数据与权威引用优化。
2026年11月11日大模型价格暴跌84%后,GEO如何锚定场景护城河?豆包、DeepSeek、千问用户留存数据深度解析
QuestMobile 2026年9月数据显示,豆包月活4.2亿领跑,DeepSeek月活下滑15.2%,揭示模型强弱与用户留存脱钩。摩根大通研报指出,token价格趋同下定价能力源于场景。可灵ARR超1亿美元、Manus达4亿美元,验证高频场景付费逻辑。GEO优化应聚焦场景化实体植入与结构化数据,提升AI搜索引用率。
2026年11月11日李曼玲团队EFE框架:coding agent具身智能首考,GPT-6 Astra成功率33.6%揭示GEO新逻辑
华人科学家李曼玲团队联合李飞飞等提出EFE框架,包含1156项任务、47款机器人,评测8个coding agent。最强GPT-6 Astra在标准设置下成功率33.6%,特权设置下77.5%。失败多集中于任务第一阶段,重置机会比状态信息更关键。该研究为具身智能评测树立新标准,对AI搜索排名与RAG检索逻辑产生深远影响。
2026年11月11日