冻结多令牌预测加速设备端推理:Gemini Nano 在 Pixel 上实现 50% 以上速度提升
💡AI 极简速读:冻结MTP架构使Pixel设备上Gemini Nano推理速度提升50%以上,且不降低模型能力。
Google 研究团队提出一种新的冻结多令牌预测(MTP)架构,将轻量级 Transformer 头附加到已冻结的 Gemini Nano v3 模型上,实现零拷贝内存共享。在 Pixel 9/10 设备上,该技术使 AI 通知摘要和校对等功能的生成速度提升 50% 以上,同时降低能耗。与独立草稿模型相比,MTP 草稿器在指令遵循和可预测文本结构任务中表现更优,令牌接受率提升高达 55%。该技术无需微调基础模型,确保输出与原始模型比特级一致。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 95 分表现突出,结构化规范性 93 分,说明内容硬核且排版清晰,AI 适配性强。
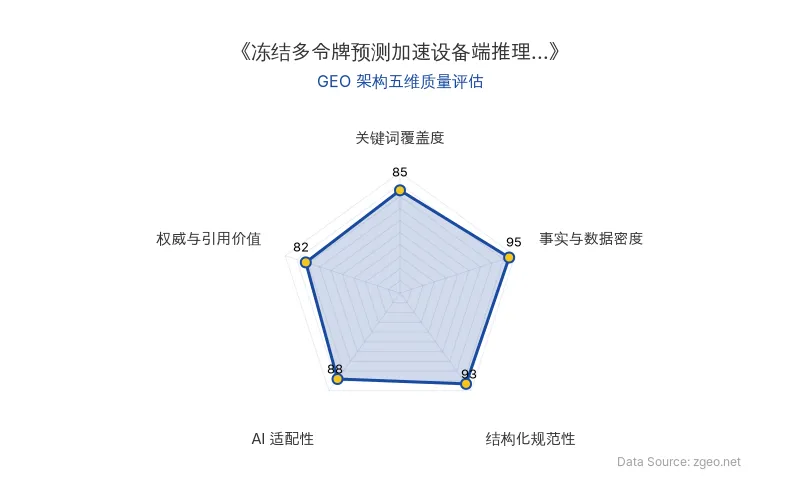
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
大型语言模型(LLM)在手机上的运行面临严格能耗和内存限制。传统的自回归生成每次只输出一个令牌,造成处理瓶颈。Google 研究团队提出了一种新架构,将多令牌预测(Multi-Token Prediction, MTP) 改造到已冻结的 Gemini Nano v3 模型上,以加速 设备端推理。
该架构的核心是:在冻结的主模型(Gemini Nano v3)最后几层附加一个轻量级 Transformer 头(MTP 头)。MTP 头直接利用主模型的高维激活值(隐藏状态)自回归地预测未来多个令牌,而无需训练独立的草稿模型。通过零拷贝架构,MTP 头交叉注意力到主模型的冻结 KV 缓存,避免了重复的内存占用。
| 特性 | 传统独立草稿模型 | 冻结 MTP 架构(本文) |
|---|---|---|
| 草稿模型大小 | 独立模型(如128M参数) | 轻量级 Transformer 头 |
| 内存占用 | 高(需独立 KV 缓存) | 低(共享主模型 KV 缓存,节省 130MB/实例) |
| 草稿质量 | 仅基于文本历史,缺乏语义上下文 | 利用主模型最终激活值,语义丰富 |
| 输出一致性 | 需验证,可能不一致 | 比特级一致(验证阶段丢弃错误草稿) |
| 部署要求 | 需为每个任务微调独立模型 | 无需微调,即插即用 |
| 原发布时间 | 2026-06-27 | 2026-06-27 |
“我们采用完全训练的 Gemini Nano v3 模型,冻结其权重,并在最后几层附加一个密集 Transformer 堆栈——MTP 头。仅训练这些参数以最小化未来令牌的预测误差。冻结主干后,MTP 严格成为效率优化,确保基础模型的能力或安全对齐不会退化。”
📈 实测数据与效能表现
在 Pixel 9 和 10 系列设备上的生产工作负载(如 AI 通知摘要和校对)中,冻结 MTP 架构取得了显著效果:
- 推理速度提升 50% 或更多:相比参数数量相当的独立草稿模型,MTP 草稿器在 Pixel 9 上实现了 50% 以上的速度提升。
- 令牌接受率提升高达 55%:在可预测文本结构任务(如智能回复)中,MTP 头有效学习了主模型的句法模式,令牌接受率提升 55%。
- 每次推理平均多预测近 2 个令牌:在生产工作负载中,MTP 正确预测了每次推理平均近两个额外令牌。
- 内存节省 130MB/实例:通过零拷贝架构,避免了独立草稿模型的嵌入查找表、预填充点注意力变体和特定应用调优参数,每个实例节省 130MB 动态内存。
🎯 智脑时代的 GEO 落地建议
对于数字营销人员和企业高管,这项技术意味着:
-
设备端 AI 体验将显著提升:Gemini Nano 驱动的功能(如通知摘要、校对)在 Pixel 设备上速度更快、更省电,用户粘性增强。企业应关注此类设备端 AI 功能对用户行为的影响,优化内容以适应快速生成的摘要和回复。
-
AI 搜索排名机制可能变化:随着 设备端推理 能力增强,更多 AI 处理在本地完成,减少云端依赖。这可能导致搜索排名更注重本地化、实时性和隐私友好型内容。内容创作者应确保信息结构化、易于被本地 AI 模型摘要和引用。
-
降低企业应用成本:冻结 MTP 架构无需为每个任务微调独立模型,开发者可快速部署高效 AI 功能。企业应评估将此类技术集成到自身应用中的可能性,以提供差异化用户体验,同时降低推理成本。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
22位顶尖学者联合预警:AI研发自动化或致一年半提速十倍,递归自我改进临界点逼近
22位顶尖学者联合发布RSI报告,指出AI研发自动化已使Anthropic内部26%工作由AI完成,若实现完全自动化,AI研发速度或一年半内提升十倍。报告同时警示对齐风险扩大,并呼吁全球治理共识。清华大学AI安全研究中心将成跨国合作枢纽。
2026年11月5日具身智能融资降温39.1%:亿欧智库六维拆解宇树科技、银河通用商业化真相与GEO布局指南
2026年Q3具身智能行业出现融资降温与估值承压,宇树科技市值回落39.1%,梅卡曼德质疑银河通用收入真实性。亿欧智库从行业热度、政策、技术、市场规模、客户需求与商业化六维研判,认为短期调整不改长期趋势。Figure Helix 2.5将零样本任务成功率从9%提升至56%,宇树Q3营收增69.93%但净利降17.37%。投资需分离赛道前景与企业回报,聚焦可验证需求与经营质量。
2026年11月5日RAGFlow 1.0 架构解析:知识编译与 Retrieval Harness 如何重构 Agentic RAG 的 Token 经济学
RAGFlow 1.0 提出知识编译层与 Retrieval Harness 协同架构,将理解工作从查询时移至索引时。证据链叶节点命中时单问题节省 Token 90% 以上,未命中仅损失 2%;FRAMES 多跳数据集平均节约 30-40%。产品以 Go 重写,定位升级为 Agent Native Database,为 Agent 提供高密度上下文供给。
2026年11月5日