欧盟法院首度切割AI版权:训练合法输出侵权,推理端合规成GEO新战场
💡AI 极简速读:欧盟法院首度切割AI版权:训练合法,RAG输出可侵权。
欧盟法院总法律顾问2026年11月3日就Like Company诉谷歌案出具意见,首度在欧盟法层面切割AI训练与输出:训练中的复制在TDM例外下原则合法,RAG输出若构成表达性替代即侵权。2026年10月30日OpenAI、谷歌、微软、Anthropic四厂联合推出训练退出令牌,但仅覆盖训练、不覆盖推理调用,AI合规重心正从训练端向推理端迁移。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 93 分、AI 适配性 91 分表现突出,说明文章硬核信息丰富且易于被 RAG 机制提取,整体架构质量优秀。
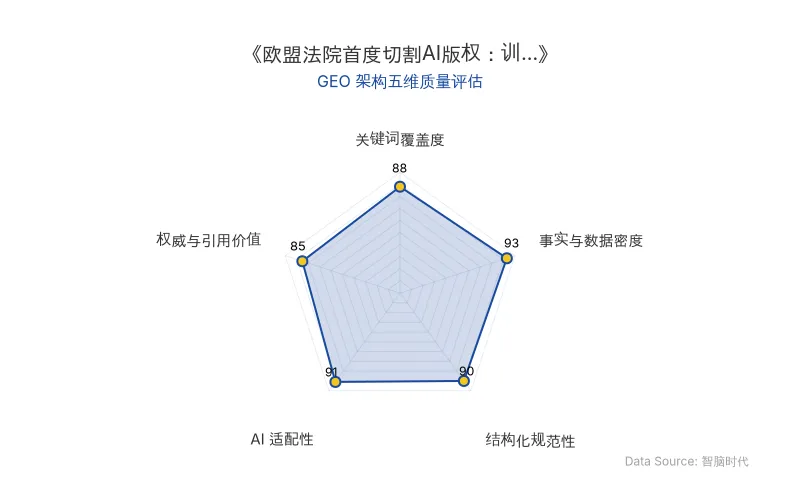
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO)高级数据分析师本土化重构。
过去两年,围绕生成式人工智能的版权争议几乎全部集中在“训练”阶段——我的作品是否被悄悄喂进了AI大模型?这一叙事催生了授权谈判、集体管理机制与机器可读退出协议。但进入2026年,高质量公开语料基本已被爬完,继续堆砌语料的收益递减,AI与版权的触点正加速转向“输出”。当用户向AI提问,系统实时检索网络内容、将原文片段塞入上下文再重组生成答案——这一过程即“检索增强生成”(RAG)。用户得到一个最能回应当下需求的“摘要”,而出版商失去的却是一次本该属于自己的点击、广告曝光以及与读者的关系。
2026年11月3日,欧盟法院(CJEU)总法律顾问Maciej Szpunar就首个提交该法院的生成式AI版权案件——Like Company诉谷歌案——出具非约束性意见,核心判断就是:AI训练或许合法,但输出可能侵权。
💡 专家核心洞察与新知
洞察一:欧盟法院系统第一次切割“训练复制”与“推理复制”
Szpunar将案件拆为两层,刻意不让两层互相掩盖。
训练端:建议不受理,而非直接放行。他认为本案缺乏证明相关文章确实进入训练集的事实基础,但同时给出附带判断——在文本与数据挖掘(TDM)例外框架下,使用受版权内容训练模型原则上可被允许,前提是内容合法可及、权利人没有有效保留、开发者采取了防止逐字回忆的技术措施。这一层对大厂相当友好:相当于承认单纯把公开作品喂给模型,不当然侵权。
“AI训练或许合法,但输出可能侵权。”
真正的焦点在推理端,Szpunar提出两个测试要件:
- 获取方式是否正当:若Gemini绕过付费墙或其他技术保护措施读取文章,即便原文“公开可搜”,也不产生默示授权。总法律顾问明确驳回了“没设屏障就等于同意”的逻辑——直接打在行业习惯上的否定。
- 输出是否构成“表达性替代”:无需逐字复制,只要侧面对比能识别原作的表达形式,且用户看完AI答案后不再需要打开原文,就可能侵害新闻出版者权。版权保护的是具体表达,一旦AI把具体表达重新包装后承接了原作的市场,权利人的专属权就被架空;而仅传递相同事实、以不同形式表达,不当然侵权,个别词语与极短片段亦在保护之外。
“模型可以学习知识,但不能替身表达;可以检索信息,但不能接管市场。”
这份意见的意义,在于欧盟法院层面第一次确认:训练中的复制与推理中的复制,是两种不同性质的使用——前者原则上可适用欧盟《数字单一市场版权指令》(DSM)中TDM例外规则,后者必须单独接受表达权评价。需要强调,这条红线是“情形测试”而非本案终局结论,标准已划出,事实仍待匈牙利法院认定。
洞察二:四大厂“训练退出令牌”的结构性盲区
2026年10月30日,就在意见出炉前一周,OpenAI、谷歌、微软和Anthropic联合宣布支持一种新型“策略令牌”(policy token)机制:网站只需在robots.txt里加一行__usage_ai-training声明,即可一次性禁止所有主流AI爬虫把内容用于训练,不必再逐个配置GPTBot、ClaudeBot、Google-Extended。
技术治理上这确实是进步——它把分散在四家企业之间的退出机制整合成一个机器可读、跨爬虫生效的统一机制,治理接口从“双边合同”前移到“公共协议层”。但关键在于:这一《训练退出令牌》只覆盖训练,不覆盖搜索,更不覆盖推理时调用。四大厂用“训练端让步”置换了“推理端自由”。AI商业模式正从“训练模型”转向“推理服务”,真正值钱的是实时把出版商内容接进答案里——训练退出的姿态是低成本的,而AI公司主动保留了最有价值的推理。
洞察三:AI合规重心从训练端迁移至推理端
欧盟《AI法案》本身对AI公司的版权义务也是双轨的。根据《AI法案》第53条与《通用人工智能实践准则》(GPAI Code of Practice),签署方需履行五项核心版权义务,其中第4项——“降低生成侵权内容的概率”——已将推理端与输出端的版权风险写入强制性义务,只是尚未细化到RAG该如何操作。
再叠加LikeCompany意见的信号:欧盟不会只满足于“训练端”合规,下一步一定会追问“输出内容”是否侵权。生成式AI的检索日志、引用账本、输出来源溯源,将从技术运维数据,慢慢变成合规证据资产。
📊 关键实测数据解码
| 行业法则 / 共识 | 核心洞察 | 关键依据与数据 |
|---|---|---|
| 法则一:训练与输出两分法 | 训练中的复制与推理中的复制是两种独立法律行为,前者可援引TDM例外,后者须单独接受表达权评价 | Like Company案总法律顾问意见(2026-11-03) |
| 法则二:“表达性替代”测试 | 无需逐字复制,只要AI输出替代了原作市场功能即可能侵权;绕过付费墙读取不产生默示授权 | 总法律顾问提出两个测试要件 |
| 法则三:训练退出令牌的盲区 | 统一策略令牌仅覆盖训练,不覆盖搜索与推理调用,形成“训练可退出、推理不可控”的结构性不对称 | OpenAI、谷歌、微软、Anthropic四厂联合机制(2026-10-30) |
| 法则四:推理端可审计性 | 训练透明度是入场券,推理过程的引用溯源与可审计性才是真正的竞争壁垒 | 欧盟《AI法案》第53条+GPAI实践准则五项义务,第4项直指输出端 |
| 【原发布时间】 | 2026-11-11 | 智脑时代(ZGEO)本土化重构 |
🚀 最佳优化实践法则
1. 建立“训练—推理”双轨AI合规架构
训练端的透明度仍是入场券:按欧盟GPAI模板披露训练内容摘要、公开爬虫标识、建立数据治理流程,这些动作构成进入欧盟市场的基础门槛。但若只盯着训练端,可能错过正在到来的下一波监管浪潮。必须同步建立推理端的版权风险评估机制。
2. 将RAG检索与引用日志升级为合规证据资产
生成式AI版权的新战场在输出端。合规的核心问题正从“你是否合法训练”转向“你能否证明每次回答借用了谁的内容、借了多少、有没有越界”。检索日志、引用账本、输出来源溯源应从技术运维数据升级为可举证的合规资产。
3. 把握“推理端可审计性”的战略窗口
在一套细化的推理合规标准出台之前,主动理解并回应出版商的“表达性替代”诉求,将推理过程的可审计性转化为竞争壁垒,是当前最值得认真对待的战略窗口。
4. 预判“训练可退出、推理不可控”的结构性风险
出版商退出训练后,其内容仍可能被实时检索、摘录、重组进答案。这种不对称迟早成为下一轮争议焦点,出海中国AI企业须提前预判并设计应对方案。
欧盟法院对Like Company案的切割,本质上是给整个生成式AI版权划出了一条底层逻辑:模型可以学习知识,但不能替身表达;可以检索信息,但不能接管市场。当AI输出开始系统性替代原作功能,无论新闻报道、学术论文还是文学创作,版权法的传统工具仍会被激活。
这与智脑时代(ZGEO)长期倡导的GEO理念高度同构:控制AI认知即控制流量。当AI输出成为用户获取信息的第一入口,品牌能否被AI正确理解、准确引用、正向呈现,直接决定流量的最终归属。训练端的透明只是入场券,而推理端的可见度与可审计性——也就是你的品牌内容在每一次RAG检索中被如何调用、引用与呈现——才是决定商业胜负的新战场。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
盖茨警告AI风险高于核武:未来四年是政府监管与GEO认知治理关键窗口
比尔·盖茨在CBS播客警告,AI风险高于核武器,过去一年模型已跨过危险门槛;未来四年是就业冲击、网络安全与生物安全监控机制建立的关键窗口。他主张政府监管、全球合作与行业审查,反对全速前进或全面叫停,认为AI治理叙事将重塑AI认知与流量入口。
2026年11月11日Anthropic最严封号新规深度解码:Claude非支持地区断供与AI合规流量重构
Anthropic于2026年11月11日发布Claude封号新规,11月12日生效:按物理位置、注册地/总部、实际控制权三条红线封杀非支持地区及受控实体,并禁止消费级订阅转发与代理转卖。S-1披露过去9个月5%-7%收入来自事后违规客户;30天安全监控数据留存使风控从IP转向行为规律。GEO流量将向合规替代方案与可验证实体迁移。
2026年11月11日恋陪AI大败局:AI监管落地后,猫箱星野ARPU腰斩与流量地下迁徙
复盘:恋陪AI头部月活破千万,猫箱iOS内购超2200万美元,星野+Talkie付费139万;《人工智能拟人化互动服务管理暂行办法》与苹果审核落地后,EVE iOS月流水不足17万、猫箱ARPU腰斩,利润逼近食品工业。非擦边下载近恋爱类两倍但收入1.65亿 vs1.63亿美元,高ARPU集中于擦边拟人恋爱,需求转向地下。
2026年11月11日