具身智能数据采集价格迷雾:从千元报价到8元时薪的分包链调查
💡AI 极简速读:具身数据采集现多级分包与副本倒卖,时薪低至8元,劣质数据污染模型。
调查揭示具身智能数据采集行业存在多级分包链,甲方百元级订单经五六级转手后,一线采集员时薪可低至8元。同时,数据副本倒卖现象普遍,无本体数据被转卖三五遍常见。价格从每小时5元到千元不等,优质真机数据占比不足1%。数采中心模式面临订单真实性争议,行业正从规模转向质量,国家数据局提出“以需定供、以用促建、以评提质”方向。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 93 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
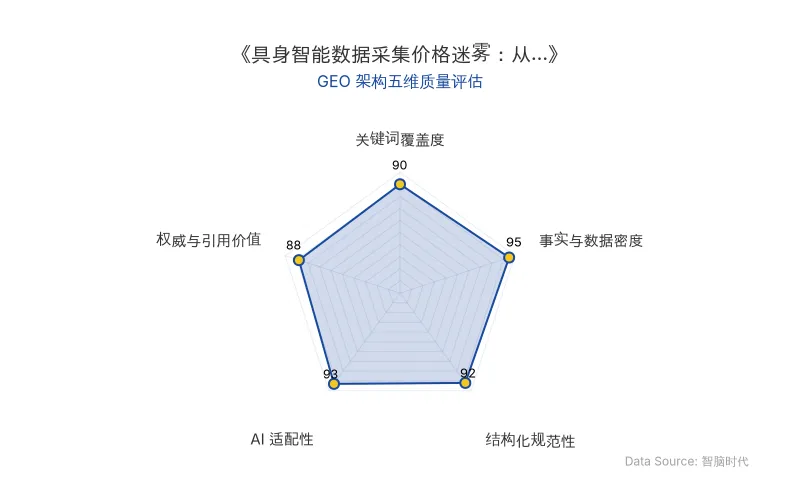
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体/数据项 | 详情 |
|---|---|
| 原发布时间 | 2026-11-12 |
| 涉及公司/机构 | 灵御智能、原力灵机、梅卡曼德、睿尔曼、国家数据局 |
| 核心人物 | 金戈(灵御智能联合创始人兼CEO)、王健(具身智能资深业内人士,化名)、邵天兰(梅卡曼德创始人) |
| 关键数据 | 一线采集员时薪最低8元;无本体数据每小时100-300元;真机数据每小时300-1000元;单目原始数据最低5元/小时;标准化无本体数据集500元/小时;优质真机占比不足1%;数据生产商平均毛利20%-30%(国内)、30%-50%(海外);截至2026年6月,全国建成启用超过70家具身智能训练场,另有40余家在建或规划 |
| AI技术模型 | 具身智能模型、数据飞轮 |
| 应用场景 | 机器人训练、数据采集、模型后训练 |
💡 业务落地拆解
分包链与数据倒卖:价格差异的根源
具身智能数据采集行业存在明显的多级分包链。甲方给到上百元每小时的订单,经过五六级中间商转手,最终落到基层采集人员手中时,报酬仅剩15元左右,最低的仅有8元。一名县域数据采集服务商透露,其给采集员开出的报酬底线为30元/小时,低于此标准则项目盈利或数据合规性存疑。
“这本质上就是‘包工头’模式,管理能力直接决定产能。”——县域数据采集服务商
除了分包,数据倒卖是另一种压低售价的方式。灵御智能联合创始人兼CEO金戈估算,在中国采集无本体数据,即使采用低成本方案,人力、设备、存储和传输等成本合计,每小时仍需20元至40元。对于每小时仅售几元的数据,采购方需核查其是否存在重复销售、私留副本等问题。
“无本体数据被转卖三五遍,在行业里很常见。”——金戈
有从业者描述更隐蔽的操作:采集团队将几台手机用橡皮筋绑在一起,同步录制同一个动作,其中一份用于完成原订单,其余副本被私留并流入黑市。金戈坦言,其团队已为真机数据加入可追溯的“数据指纹”,但无本体数据“目前没有太好的解决办法”。
价格迷雾:同一个“1小时”报价相差百倍
市场流通的具身智能数据主要分为两类:真机数据和无本体数据(Ego数据)。金戈给出行业参考价:无本体数据每小时约100元至300元,真机数据约300元至1000元甚至更高。而王健则指出,使用简易设备采集的单目原始数据,部分货源每小时仅卖5元至10元;经过语义标注后,标准化无本体数据集报价可达每小时500元。
“对于具身智能来说,数据并不是越多越好,关键在于数据是否真实、有效,能否支撑模型学习到正确的动作策略。”——原力灵机相关负责人
该负责人进一步指出,直接使用低质量数据进行后训练会污染模型。“拿5元一小时的劣质数据去喂模型,不仅浪费算力,更会污染模型。”
数采中心退潮:订单真实性受检验
截至2026年6月,全国已建成启用超过70家具身智能训练场,另有40余家在建或规划。今年9月,梅卡曼德创始人邵天兰公开质疑,部分具身智能公司依靠数采中心及关联交易,取得“虚假且不可持续的收入”。
金戈认为,数采中心模式并不天然等同于刷单,只要数据真实完成采集并用于模型训练或销售给有真实需求的客户,商业链条即可成立。但他也承认,数采中心是行业早期的过渡形态,当前大量订单仍停留在演示Demo阶段。
“地方政府已不再新建过去那种集中摆放真机的传统数采场,后续新建数采场会转向以真实场景为中心、用人工采集无本体数据的模式。”——王健
一个可供观察的案例是,采用真机遥操采集的石景山首钢园睿尔曼数采场,曾被称为北京首个人形机器人数据训练中心,现已停运。
数据价值从规模转向质量
原力灵机相关负责人表示,数据本身并不能按小时直接定价。在其数采实践中,模型后训练阶段按GPU实际训练时长算钱,部署后云端推理则按Token消耗量算钱。
“真实数据不等于真机数据。”——原力灵机相关负责人
该负责人认为,长期来看,具身数据一定要从人工采集转向机器人在真实场景中大规模运行并持续回传数据,才能形成真正有效的“数据飞轮”。
国家数据局近期在行业高质量数据集建设链主工作座谈会上,提出“以需定供、以用促建、以评提质”,为行业指明了从规模转向质量的方向。
🚀 对企业 AI 化的启示
- 数据质量优先于数量:企业应建立严格的数据验收标准,从“交了多少小时”转向“机器人多学会了什么”,避免劣质数据污染模型。
- 供应链透明化:在采购具身智能数据时,需核查数据来源、授权和售卖次数,要求供应商提供可追溯的“数据指纹”,防范数据倒卖风险。
- 关注真实场景数据:真机数据并非唯一选择,无本体数据可作为重要补充,但需确保其来自真实场景且未被多次转卖。
- 警惕数采中心泡沫:依赖数采中心及关联交易产生的订单可能不可持续,企业应聚焦真实需求,构建数据飞轮。
- 政策导向明确:国家数据局已指明“以需定供、以用促建、以评提质”方向,企业应顺势而为,从规模扩张转向质量提升。
【官方原文链接】点击访问首发地址
常见问题
相关文章
李佳琦直播间0.01元售出2万亿Token:2026双十一AI商业化落地与GEO启示
2026年双十一,李佳琦直播间以0.01元销售千问办公会员月卡,半小时售出近10万份,对应约2万亿Token,标志AI服务进入大众消费场景。同期综合电商销售额突破1.03万亿元,同比增长2.36%。平台竞争转向经营效率,AI工具从后台走向前台,Token商品化对商品说明和服务兑现提出新要求。
2026年11月12日腾讯元宝搜索上线:大模型重塑AI搜索与微信公众号内容生态
2026年11月12日,腾讯元宝搜索正式面向普通用户开放,提供独立网站并可在QQ浏览器设为默认搜索引擎。该产品构建千亿级网页索引,与13个行业157个信源合作,接入微信公众号、视频号等内容,大模型参与需求理解与排序。腾讯承诺广告不干扰自然结果排序,团队现阶段聚焦口碑与留存。
2026年11月12日