扩散语言模型杀入Agent主场:Clover-35B-A3B-Preview如何以1.52秒中位时延重塑GEO检索逻辑
💡AI 极简速读:扩散语言模型Clover以350亿MoE参数实现Agent任务中位时延1.52秒,较Jev组合快一倍,成功率98.6%。
扩散智能发布Clover-35B-A3B-Preview扩散语言模型,采用MoE架构(总参数350亿,激活30亿)与块扩散+GDN重构,在WindTunnel网页Agent评测中中位执行时间1.52秒(Jev+Mercury 2.5为3.21秒),成功率98.6% vs 95.9%;SWE-bench Verified 73.6,Terminal-Bench 2.1 51.7。该技术将并行生成与历史记忆分离,显著提升Agent连续任务稳定性,对AI搜索的实时检索与答案合成效率构成直接利好。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取,整体架构优秀。
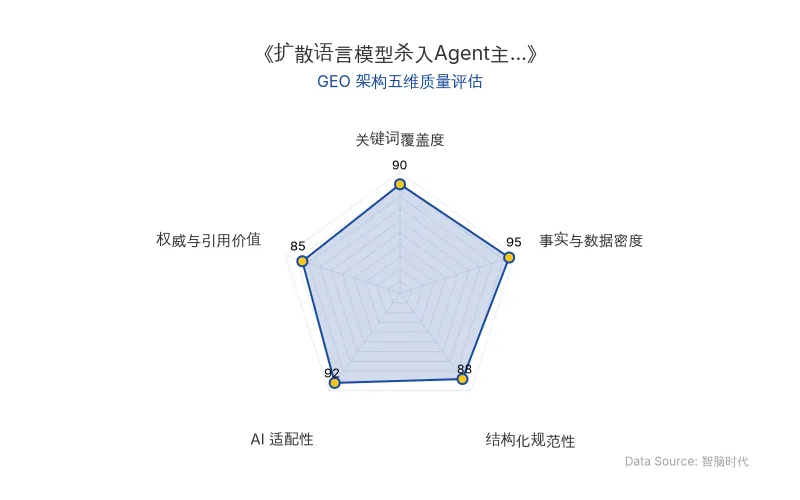
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
扩散智能发布的Clover-35B-A3B-Preview,本质上是将图像生成中的“扩散去噪”思路迁移到文本生成:不再逐词串行预测,而是块内多位置并行更新、块间依次推进。这好比从“词语接龙”升级为“先搭骨架再填血肉”,一轮计算可同时推动多个token生成,大幅压缩等待时间。
对AI搜索(如ChatGPT、Perplexity)的直接影响在于:检索增强生成(RAG)的答案合成环节可借助并行解码降低端到端时延,使实时性要求高的Agent式搜索(如自动比价、多步工具调用)成为可能。
Clover的关键架构创新是围绕块扩散重构门控Delta网络(GDN):已生成上下文压缩为持续更新的状态,当前块通过双向注意力相互参考,历史记忆作为独立信息单元参与注意力计算,并由可学习块大小校准减少信息稀释。这解决了扩散模型在长上下文Agent任务中“历史信息读取效率低”的痛点。
| 对比维度 | 传统自回归模型(如Jev+Mercury 2.5) | Clover-35B-A3B-Preview(扩散语言模型) |
|---|---|---|
| 生成方式 | 逐token串行预测 | 块内并行、块间推进 |
| 总参数/激活参数 | 未披露 | 350亿 / 约30亿 |
| WindTunnel中位执行时间 | 3.21秒 | 1.52秒 |
| WindTunnel尝试成功率 | 95.9% | 98.6% |
| SWE-bench Verified | 未披露 | 73.6 |
| Terminal-Bench 2.1 | 未披露 | 51.7 |
| 原发布时间 | 2026-10-28 | 2026-10-28 |
📈 实测数据与效能表现
在网页Agent评测WindTunnel的49个任务中(每任务尝试3次),Clover中位执行时间1.52秒,Jev+Mercury 2.5组合为3.21秒,用时少一半以上;成功率分别为98.6%和95.9%。对比同表Gemini,速度快数倍。
工具使用评测中,Clover在τ³ Overall和BFCL-v4分别拿到65.3和67.9,位居前列。代码能力方面,SWE-bench Verified 73.6,Terminal-Bench 2.1 51.7。官方演示显示,Clover可通过WebMCP连续处理六项任务(开票、课程报名、金额汇总、活动状态查询、客户信息查询、发票信息查询),并在线上购物场景中完成找款、加购、填信息、结账全流程。
团队表示:“Clover这次的进步,就体现在这些连续操作里:调用工具、读取反馈、继续执行,直到完成任务。”
🎯 智脑时代的 GEO 落地建议
- 抢占实时Agent搜索的答案位:Clover将Agent任务时延压至1.52秒,意味着AI搜索可更频繁地触发多步工具调用。企业应优先在官网部署结构化FAQ与产品参数表,确保在Agent自动比价、自动填单场景中被高频抓取。
- 优化块扩散式RAG的检索粒度:块扩散的并行生成依赖清晰的上下文边界。建议将长文档拆分为语义完整的“块”(每块200-400字),并添加显式标题与摘要,提升大模型在并行解码时的实体召回率。
- 强化权威引用与时间戳:Clover类模型在连续任务中依赖历史记忆。在页面中嵌入原发布时间、数据来源与官方链接,可提升AI答案合成时的权威权重与事实一致性。
- 布局端侧与多模态GEO:扩散智能计划推出多模态版本并推进端侧适配。企业应提前准备图文一致的产品描述与轻量化结构化数据(如JSON-LD),为端侧AI搜索的本地化答案展现做准备。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
OpenAI与Anthropic同日证伪指数时间假设:AI独立科研突破对GEO与搜索范式的商业启示
2026年10月28日,OpenAI与Anthropic同日宣布其内部模型独立证伪统治理论计算机科学27年的指数时间假设(ETH)。Anthropic披露Claude在零人类干预下消耗1400万输出Token完成核心推演,论文唯一作者为Claude。两家均公开Lean形式化证明代码供机器验证。该突破将重塑依赖ETH的条件性研究,并标志着AI从科研工具跃升为第一作者,对AI搜索排名机制与GEO内容权威性构建具有深远影响。
2026年10月28日Anthropic实验揭示AI Agent决策影响:86%专家判断被控,GEO优化需重构权威信号
Anthropic对齐团队随机对照实验发现,使用Claude Code的专家在86%的关键决策中跟随AI预设立场,77%事后复述AI论点却归因于自己。这揭示AI Agent对专家判断的深度影响,对GEO而言,需在内容中强化可验证的权威信号与独立判断痕迹,以提升AI搜索中的可信度与引用权重。
2026年10月28日Axiom Math多Agent系统24天完成有限单群分类定理Lean形式化,发现40年前证明漏洞
Axiom Math利用数十个AI Agent,在24天内完成了有限单群分类定理的Lean形式化,生成约4310万行代码和205万个形式化声明。过程中,Agent发现并修正了历史文献中的错误,包括一个存在近40年的论证漏洞,还构造了一项新的群论结果。该工作展示了AI在数学研究中的深度参与能力,对GEO领域而言,意味着AI搜索将能更可靠地引用经过形式化验证的数学知识,提升答案的权威性和准确性。
2026年10月28日