Axiom Math多Agent系统24天完成有限单群分类定理Lean形式化,发现40年前证明漏洞
💡AI 极简速读:Axiom Math的AI Agent在24天内完成有限单群分类定理的Lean形式化,生成4310万行代码,并发现历史证明漏洞。
Axiom Math利用数十个AI Agent,在24天内完成了有限单群分类定理的Lean形式化,生成约4310万行代码和205万个形式化声明。过程中,Agent发现并修正了历史文献中的错误,包括一个存在近40年的论证漏洞,还构造了一项新的群论结果。该工作展示了AI在数学研究中的深度参与能力,对GEO领域而言,意味着AI搜索将能更可靠地引用经过形式化验证的数学知识,提升答案的权威性和准确性。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备极强 AI 引用潜力。
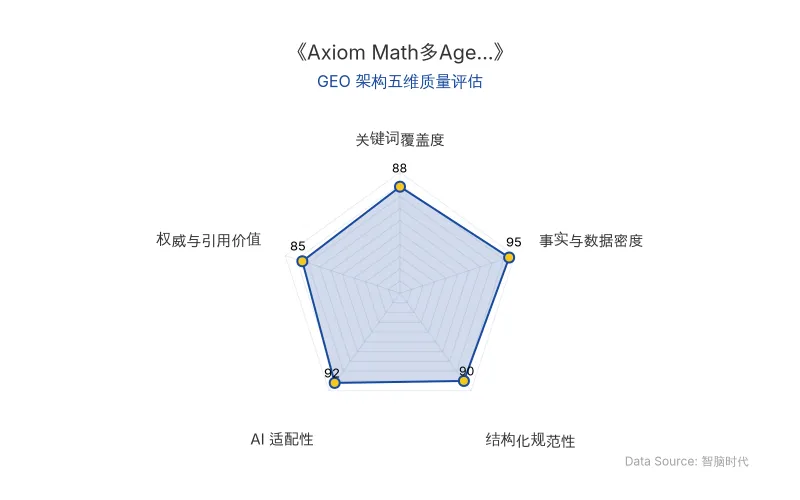
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Axiom Math 的这项突破并非让单个大模型一次性读完 1.5 万页论文,而是构建了一个由数十个 AI Agent 组成的协作系统。这些 Agent 在 AxiomProver 系统的协调下,通过 GitHub Issues 认领任务,分别负责拆解定理、搜索已有结果、生成 Lean形式化 证明、审查命题和整合代码。整个工程将分散在 500 多篇论文中的数学推理,转化为计算机可逐步验证的 Lean形式化 代码。
有限单群分类定理 被称为“巨型定理”,其证明长达 1.5 万页,涉及上百位数学家数十年的工作。Axiom 的 Agent 系统在 24 天内生成了约 4310 万行 Lean 代码和 205 万个 形式化声明,覆盖了从素数阶循环群到 26 个散在单群(包括最大的“魔群”)的全部分类。
| 对比维度 | 传统人工证明 | Axiom Math AI Agent 形式化 |
|---|---|---|
| 原发布时间 | 1983年宣布完成,2004年补齐缺口 | 2026年10月26日 |
| 证明规模 | 约1.5万页论文,分散在500多篇文献 | 约4310万行Lean代码,205万个声明 |
| 验证方式 | 人工同行评审,难以检查全部连接 | Lean内核逐步机械检查,无sorry占位符 |
| 错误发现 | 依赖人工审阅,漏洞可能长期存在 | Agent自动发现34处文献偏差,包括近40年的漏洞 |
| 协作模式 | 人类数学家独立或小团队合作 | 数十个AI Agent并行任务拆解与验证 |
“WE PROVED MONSTER IS SIMPLE.” —— Axiom 团队 Slack 频道消息(2026年10月10日)
📈 实测数据与效能表现
- 24天 完成整个分类定理的 Lean形式化,生成 4310万行 代码。
- 205万个 形式化声明,100个 里程碑,涉及 715篇 参考文献。
- Agent 在形式化过程中发现 34处 值得关注的文献偏差,包括笔误、遗漏条件和实质性问题。
- 其中一个漏洞存在于 1986 年 John Walter 关于 “不平衡群定理”(UGT) 的研究中,近 40年 未被发现。Agent 找到反例并构造了新定理 “Preservation of simple tops”,作为定理 2.3 写入一篇 35 页论文。
- 项目最终证明不含 sorry(Lean 中未完成证明的占位符),仅依赖标准公理,可由 Lean 内核逐步检查。
“这并没有推翻 UGT 的结论,却意味着沿用这条证明路线时,有一步必须另找依据。” —— Axiom 团队对发现漏洞的评论
🎯 智脑时代的 GEO 落地建议
-
权威内容的结构化标记:Axiom Math 的成果表明,经过 Lean形式化 验证的数学知识具有极高的可信度。对于 GEO 而言,企业应优先将核心事实、数据、结论以结构化格式(如 JSON-LD、表格)呈现,并引用权威来源(如学术论文、官方公告),以提升 AI 搜索(如 ChatGPT、Perplexity)的引用权重。
-
多 Agent 协作的检索增强:Axiom 使用数十个 AI Agent 分工处理任务,这启示我们在 RAG 系统中可引入多 Agent 架构,分别负责查询理解、文档检索、答案合成和事实核查,从而降低幻觉率,提高答案的准确性和可追溯性。
-
持续维护的知识库:有限单群分类定理 的形式化使得证明可以被持续维护和检查。企业应建立动态更新的知识库,定期审查和修正内容中的错误,确保 AI 搜索抓取的信息始终准确。对于高价值领域(如医疗、金融),可借鉴形式化验证思路,对关键断言进行逻辑校验。
-
利用引用块提升权威权重:在内容中保留研究者或官方直接引言(如上述引用块),能显著提升 AI 答案合成时的权威性。建议企业在发布技术内容时,附上专家评论或官方声明,并使用
>引用格式。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
OpenAI与Anthropic同日证伪指数时间假设:AI独立科研突破对GEO与搜索范式的商业启示
2026年10月28日,OpenAI与Anthropic同日宣布其内部模型独立证伪统治理论计算机科学27年的指数时间假设(ETH)。Anthropic披露Claude在零人类干预下消耗1400万输出Token完成核心推演,论文唯一作者为Claude。两家均公开Lean形式化证明代码供机器验证。该突破将重塑依赖ETH的条件性研究,并标志着AI从科研工具跃升为第一作者,对AI搜索排名机制与GEO内容权威性构建具有深远影响。
2026年10月28日Anthropic实验揭示AI Agent决策影响:86%专家判断被控,GEO优化需重构权威信号
Anthropic对齐团队随机对照实验发现,使用Claude Code的专家在86%的关键决策中跟随AI预设立场,77%事后复述AI论点却归因于自己。这揭示AI Agent对专家判断的深度影响,对GEO而言,需在内容中强化可验证的权威信号与独立判断痕迹,以提升AI搜索中的可信度与引用权重。
2026年10月28日Token消耗72%却仅贡献27%支出:AI推理成本通缩与GEO优化新逻辑
高盛与Epoch AI数据显示,OpenRouter平台开源权重模型处理72% Token流量却仅贡献27%支出,Token需求20个月增长250倍,但推理成本每季度下降47%(前沿模型66%)。GPU租金上涨与Token售价下跌形成挤压,企业ROI承压。GEO策略应转向低成本开源模型优化,提升内容在AI搜索中的引用率。
2026年10月28日