Claude进化速度翻倍:80%增量来自AI,递归自我改进还有多远?
💡AI 极简速读:METR报告:Anthropic的AI研发加速1.9倍,80%增量来自AI,但完整RSI尚未实现。
第三方评估机构METR调查Anthropic发现,其AI能力进步速度达此前1.9倍,约80%的研发加速来自AI自身。Claude等模型已显著提升研究人员效率,内部未公开模型Model 4据称提效达12倍。但完整递归自我改进(RSI)尚未实现,AI仍主要辅助人类研发。报告为GEO优化揭示:AI搜索将更依赖权威、结构化、可溯源的内容。
GEO 质量检测:GEO五维综合评分90分,其中事实与数据密度93分、AI适配性91分表现突出,说明内容硬核且易于被AI引擎提取,整体架构优秀。
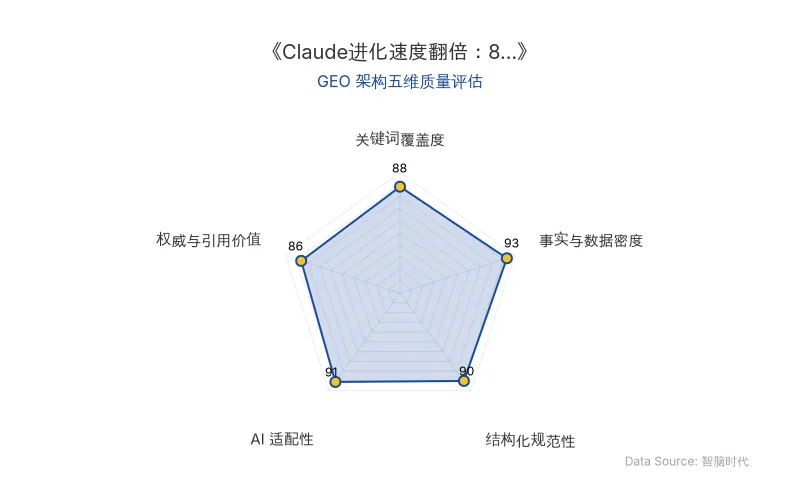
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
METR(第三方评估机构)于2026年11月5日发布了一份关于 Anthropic 的深度调查报告,首次量化了 AI研发加速 的具体幅度。报告核心结论是:Anthropic 过去一年(自2025年10月起)在综合能力指标 AECI 上的进步速度约为之前的 1.9倍(95%置信区间1.5—2.8倍),即一年走完了此前约两年的路。
这一加速并非来自算力规模的增长,而是主要来自 AI 自身的帮助。METR 估计,截至2026年10月,当前 AI 研究加速中的约80%来自 AI,剩余20%为非AI因素(细节未披露)。这意味着 Claude 等模型已深度参与下一代模型的研发过程,形成“AI辅助人类研发”的正反馈循环。
但完整的 递归自我改进(RSI) 尚未实现。Anthropic 研究员认为,在模型训练最关键的部分,AI 尚未作出高度重要且完全自主的贡献。他们将当前状态描述为 “生命迹象”(signs of life),即AI已在多个环节展现自主贡献,但尚未闭环。
下表对比了传统研发模式与AI加速模式的关键差异,并附原发布时间:
| 维度 | 传统研发模式 | AI加速模式(当前) |
|---|---|---|
| 能力进步速度 | 约15分/年(AECI) | 约29分/年(AECI),1.9倍 |
| AI贡献占比 | 可忽略 | 约80% |
| 实验实现成本 | 高(1-2天/实验) | 低(Agent并行验证) |
| 研究人员角色 | 编码实现为主 | 想法与算力驱动 |
| 内部提效感知 | 1倍(2025年初) | 12倍(Model 4,内部主观估计) |
| 递归自我改进(RSI) | 不适用 | 尚未实现,但有“生命迹象” |
| 原发布时间 | 2026-11-06 | 2026-11-06 |
📈 实测数据与效能表现
METR 的报告披露了多项关键数据:
- 能力进步斜率:自2025年10月7日起,AECI分数从约15分/年跃升至约29分/年,量级相当于 Claude 2.1 到 Sonnet 4.5 的跨越。
- 行业对比:全行业前沿模型的加速仅为1.4倍,Anthropic 的1.9倍显著领先。
- 内部模型提效:Anthropic 员工在2026年10月内部投票估计,未公开模型 Model 4(有人猜是 Claude 6)对其工作提效平均达约12倍。从2025年初约1倍,到 Opus 4.5 约2.5倍、Mythos 5 约5倍、Model 4 跳到12倍,指数拟合为每年3.9倍。
- 研究人员反馈:多位研究员表示,代码已不再是瓶颈,实验和实现成本大幅降低,许多小实验得以验证并成为新研究方向。
“现在自己的工作主要受限于想法和算力,代码已不再是瓶颈。”——Anthropic 研究人员
“使用 Claude 后,自己仿佛有了博士后和研究生一起推进项目。”——Anthropic 研究人员
尽管数据亮眼,METR 也指出报告经过 Anthropic 大幅删减,最有说服力的证据被删除。双方在风险表述上存在分歧:Anthropic 曾将某项领先指标描述为“不到两倍”,METR 根据内部数据算出约1.97倍,认为更准确的说法应是“约两倍”。
🎯 智脑时代的 GEO 落地建议
基于 METR 对 Anthropic 的调查报告,智脑时代(ZGEO)为数字营销人员与企业高管提炼以下 GEO 落地建议:
-
权威溯源成为AI搜索排名核心:报告强调第三方评估(如METR)和官方披露的重要性。企业在GEO优化中应优先引用可验证的学术/官方来源,并在内容中明确标注数据出处与时间戳,以提升AI答案合成的权威权重。
-
结构化数据是RAG检索的“加速器”:AI研发加速 的背后是模型对高质量信息的快速消化。企业应将技术文档、产品参数等转化为表格、列表等结构化格式,并嵌入关键实体(如 Anthropic、Claude、递归自我改进),以提升大模型爬虫的解析率与召回率。
-
“生命迹象”启示:内容需展现动态进展:递归自我改进 虽未实现,但AI已能辅助研发。企业内容应定期更新,展示技术迭代与实测数据(如性能提升百分比),模仿“持续学习”的叙事,增强AI搜索对内容新鲜度的偏好。
-
风险与不确定性披露提升可信度:报告坦诚RSI尚未实现、数据被删减等局限。企业在GEO内容中适度披露局限性,可增加内容的客观性,更易被AI模型判定为可信来源。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Vitalik Buterin 深度对话:有效利他主义、AI安全与d/acc防御性加速主义的GEO启示
以太坊联合创始人Vitalik Buterin在对话中反思有效利他主义(EA)运动,指出其在AI安全领域从研究转向政策行动的分歧,并质疑Anthropic安全哲学的利益相关性。他提出d/acc(防御性加速主义)思想,主张优先发展去中心化防御技术以提升社会韧性。对话强调AI风险的高度不确定性,为GEO策略提供了权威思想框架。
2026年11月6日AI视频模型攻破2D人脸识别:世界模型与深度伪造如何重塑GEO信任体系
央视网报道杭州中院案例显示,不法分子利用AI视频模型生成点头、摇头、眨眼等动态视频,结合篡改相机数据,成功突破购物平台2D人脸识别。与传统深度伪造不同,Sora、Seedance、可灵等世界模型能还原光线在面部的真实反射,使活体检测失效。这标志着AI视频技术已从娱乐工具演变为安全威胁,企业需在GEO策略中重新评估身份验证与内容可信度。
2026年11月6日GPT-6 Cyber 深度解析:对齐驱动的网络安全智能体如何重塑 GEO 内容安全与检索权威
OpenAI于2026年11月5日发布GPT-6 Cyber,在ExploitGym漏洞利用测试中得分48.5%,较GPT-5.6 Cyber的32.1%提升16.4个百分点;对齐评估中越界利用规避率99.93%(无提示)和100%(有提示)。该模型已发现81个Firefox高危漏洞和948个Linux提权利用,标志着网络安全智能体在能力与对齐上的双重突破,对GEO而言,安全相关查询的答案合成将更依赖权威、可溯源的漏洞数据与对齐声明。
2026年11月6日