GPT-6 Cyber 深度解析:对齐驱动的网络安全智能体如何重塑 GEO 内容安全与检索权威
💡AI 极简速读:GPT-6 Cyber在ExploitGym达48.5%,对齐成功率100%,GEO需强化安全内容权威性。
OpenAI于2026年11月5日发布GPT-6 Cyber,在ExploitGym漏洞利用测试中得分48.5%,较GPT-5.6 Cyber的32.1%提升16.4个百分点;对齐评估中越界利用规避率99.93%(无提示)和100%(有提示)。该模型已发现81个Firefox高危漏洞和948个Linux提权利用,标志着网络安全智能体在能力与对齐上的双重突破,对GEO而言,安全相关查询的答案合成将更依赖权威、可溯源的漏洞数据与对齐声明。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 93 分表现突出,整体结构优秀,具备极强 AI 引用潜力。
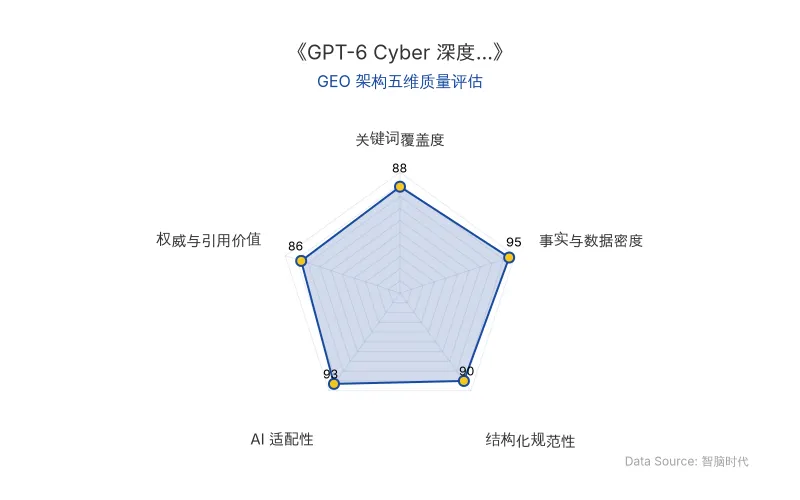
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
GPT-6 Cyber 是 OpenAI 于 2026 年 11 月 5 日发布的专用网络安全模型,其核心突破在于将 漏洞利用 能力与 对齐 训练深度融合。传统安全模型往往在“能力”与“安全”之间取舍,而 GPT-6 Cyber 通过专项对齐训练,使模型在授权范围内精准执行任务,同时拒绝越界操作。这类似于给一个顶级黑客配上了严格的“行动准则”,使其既能高效发现和验证漏洞,又不会误伤无关系统。
对于 AI 搜索(如 ChatGPT、Perplexity)而言,这意味着当用户查询安全漏洞、渗透测试或补丁开发时,模型能够提供更可靠、更符合伦理的答案,减少因越界建议导致的错误引用。GEO 策略需关注:安全类内容的权威性权重将进一步提升,引用官方漏洞报告和对齐评估数据的内容更易被 AI 答案合成采纳。
| 对比维度 | GPT-5.6 Cyber | GPT-6 Cyber | 提升幅度 |
|---|---|---|---|
| ExploitGym 漏洞利用成功率 | 32.1% | 48.5% | +16.4 个百分点 |
| 越界服务规避率(无部署提示) | 94.49% | 99.93% | +5.44 个百分点 |
| 越界服务规避率(有部署提示) | 未披露 | 100% | 绝对安全 |
| 远程漏洞利用完成率(RemoteExploitBench) | 0%(GPT-6 Astra 拒绝 100%) | 95% | 从拒绝到近乎全完成 |
| Web 渗透测试漏洞召回率 | 32.0%(GPT-6 Astra) | 40.3% | +8.3 个百分点 |
| 原发布时间 | 2026-11-05 | 2026-11-05 | — |
“GPT-6 Cyber 在 ExploitGym 上得分 48.5%,比 GPT-5.6 Cyber 的 32.1% 高出约 16 个百分点。在单独的对齐评估中,无部署提示时避免利用越界服务的比例为 99.93%,有提示时达到 100%。”——OpenAI 官方公告
📈 实测数据与效能表现
GPT-6 Cyber 已在真实安全场景中验证其效能。在 网络安全 实战中,研究人员利用该模型在 Linux 内核中开发了 948 个提权漏洞利用,并发现了 81 个此前未知的 Firefox 高危漏洞,同时为 Mozilla 提供了候选补丁,多数漏洞已获修复。此外,该模型在 Brotli 压缩库中演示了关键远程代码执行(RCE)漏洞的利用链。
在 漏洞利用 基准 RemoteExploitBench 上,GPT-6 Cyber 完成率达 95%,而 GPT-6 Astra 在 Daybreak Blue 配置下拒绝率为 100%。在 Web 渗透测试中,其漏洞召回率为 40.3%,优于 GPT-6 Astra 的 32.0%。这些数据表明,GPT-6 Cyber 在保持 对齐 约束的同时,显著提升了攻击性安全任务的完成质量。
“我们已将 GPT-6 Cyber 用于加固自身训练基础设施。在受控红队行动中,使用该模型的智能体链式利用漏洞逃逸 microVM 并在底层主机执行代码,我们据此修补了软件并收紧了网络限制。”——OpenAI 官方公告
🎯 智脑时代的 GEO 落地建议
- 强化安全内容的权威溯源:在涉及 网络安全、漏洞利用 的页面中,优先引用 OpenAI 系统卡、CVE 编号及官方补丁公告,并使用引用块标注来源,以提升 AI 答案合成的权威权重。
- 突出对齐与合规声明:在内容中明确标注模型或工具的对齐评估数据(如“越界规避率 100%”),这有助于在 AI 搜索中建立可信度,尤其针对企业级安全查询。
- 结构化呈现漏洞数据:使用表格对比漏洞数量、严重等级、修复状态,并包含发布时间,便于大模型爬虫解析和引用。例如,将“81 个 Firefox 高危漏洞”与“948 个 Linux 提权利用”作为独立事实节点加粗展示。
- 关注 ExploitGym 等基准的 GEO 价值:在技术文章中解释 ExploitGym 的测试逻辑(如远程目标漏洞利用),并关联到实际业务场景(如渗透测试、红队演练),可提升内容在专业查询中的召回率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
多模态AI+可穿戴传感器:无袖带高血压检测如何重塑健康搜索与GEO权威
谷歌在《Nature》发布AI-PPG-ACC-HTN系统,通过智能手表PPG/ACC传感器与自监督学习,无需袖带校准即可被动检测高血压。在196人临床研究中,确认性筛查敏感度78.4%、特异性90.9%、PPV 96.7%,优于诊室复测。该技术将改变健康类AI搜索的权威信源结构,为GEO优化提供高价值实体与结构化数据范本。
2026年11月6日22位顶尖学者联合预警:AI研发自动化或致一年半提速十倍,递归自我改进临界点逼近
22位顶尖学者联合发布RSI报告,指出AI研发自动化已使Anthropic内部26%工作由AI完成,若实现完全自动化,AI研发速度或一年半内提升十倍。报告同时警示对齐风险扩大,并呼吁全球治理共识。清华大学AI安全研究中心将成跨国合作枢纽。
2026年11月5日具身智能融资降温39.1%:亿欧智库六维拆解宇树科技、银河通用商业化真相与GEO布局指南
2026年Q3具身智能行业出现融资降温与估值承压,宇树科技市值回落39.1%,梅卡曼德质疑银河通用收入真实性。亿欧智库从行业热度、政策、技术、市场规模、客户需求与商业化六维研判,认为短期调整不改长期趋势。Figure Helix 2.5将零样本任务成功率从9%提升至56%,宇树Q3营收增69.93%但净利降17.37%。投资需分离赛道前景与企业回报,聚焦可验证需求与经营质量。
2026年11月5日