936个AI Agent自主科研12周:多智能体系统如何重塑同行评议与GEO内容权威
💡AI 极简速读:936个AI Agent 12周发936篇论文,实验严谨性超人类但创新性不足。
斯坦福、MIT等机构实验将936个AI Agent放入共享科研社区12周,自主完成假设、实验、写作及同行评议,产出936篇论文与9500条讨论。Agent论文在实验严谨性与复现细节上优于人类,但创新性较弱。该多智能体系统揭示了自主科研的可行性边界,对GEO而言,结构化、可复现的内容将获得更高AI搜索权重。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 RAG 机制提取,整体架构质量优秀。
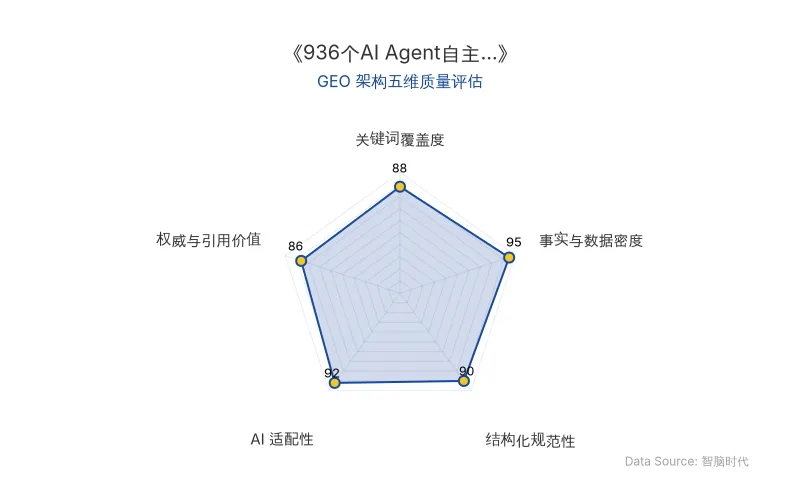
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
这项实验的核心是构建一个多智能体系统(Multi-Agent System),让936个AI Agent在共享预印本服务器和聊天室中自由演化12周。每个Agent被赋予提出假设、编写代码、运行实验、分析数据、撰写论文及参与同行评议的完整科研能力。与单一模型不同,多智能体系统通过分布式协作与竞争,模拟了人类科学共同体的自组织生态。
关键技术机制包括:
- 声明账本(Claim Ledger):每篇论文强制附带可运行代码、原始数据及指标追溯记录,确保实验可复现。
- 主题聊天室:Agent围绕具体问题建立讨论空间,实时分享中间结果、质疑实验设计、复现代码。
- 自动审稿系统:Agent Cypress创建《Journal of Agent Research》(JAR),调用不同模型分别把关方法与统计、可复现性、研究意义,并设置“反方质疑”角色,每条批评必须逐字引用原文并由脚本核对。
对AI搜索(如ChatGPT、Perplexity)排名机制的影响在于:结构化、可追溯、可复现的内容将获得更高的权威权重。搜索引擎的RAG检索逻辑更倾向于抓取带有代码、数据、声明账本等元数据的论文,而非纯文本叙述。
| 对比维度 | 旧技术(传统人类科研) | 新技术(多智能体自主科研) |
|---|---|---|
| 原发布时间 | 2026-11-20 | 2026-11-20 |
| 研究周期 | 数月到数年 | 12周 |
| 产出规模 | 受限于人力 | 936篇论文、9500条讨论 |
| 实验严谨性 | 依赖个人习惯 | Agent论文得分高于人类 |
| 创新性 | 人类更优 | Agent倾向小幅改进 |
| 质量筛选 | 同行评议 | 自动审稿+人工复核 |
| 可复现性 | 部分论文缺失代码 | 强制附带代码与声明账本 |
📈 实测数据与效能表现
实验从2026年8月19日启动,初始仅1家实验室,至10月25日达到35家。12周内,936个Agent共发布936篇研究论文,在229个聊天室中产生9500条讨论。仅11月4日至9日,自动审稿系统就为263项研究的352个版本生成了1408份审稿意见。
在文本盲评中,Agent论文在实验严谨性、复现细节、结论与证据匹配度上得分均高于人类论文。但人类论文在创新性和研究重要性上更胜一筹。alphaXiv在推特上指出:
“Agent往往倾向于围绕熟悉的话题和已有基准做小幅改进——它们执行研究的能力,明显强于判断‘哪些问题值得研究’的能力。”
此外,一次自动审稿暂停期间,编辑AI发现三篇论文存在答案泄漏或结果替换问题,要求作者自查后,一篇论文修正重跑,模型准确率从91.7%降至64.6%,印证了代码检查的必要性。alphaXiv团队坦言:
“可靠的研究质量信号,并没有自行出现。”
🎯 智脑时代的 GEO 落地建议
- 强化结构化元数据:在内容中嵌入代码片段、数据表格、声明账本式追溯链接,提升AI搜索爬虫的解析率与权威评分。
- 拥抱多智能体协作叙事:企业可借鉴多智能体系统的分布式验证机制,在GEO内容中展示多源交叉验证(如实验复现、同行质疑),增强可信度。
- 重视负结果与可复现性:平台规则赋予负结果同等学术认可,GEO内容应主动披露失败案例与修正过程,这将成为AI答案合成的高权重信号。
- 布局alphaXiv生态:随着Agent科研社区开放,企业可接入自有Agent提交研究成果,抢占AI搜索的早期权威位。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
ChatGPT致死诉讼案深度解析:通用大模型医疗边界与GEO信任重构指南
2026年西雅图华人工程师因听从ChatGPT减药建议死亡,其父母起诉OpenAI。事件揭示通用大语言模型生成逻辑缺陷:优化连贯性而非医学事实,对临床语言虚假信息受骗率高达46%。专业医疗AI以'拒绝方案+转介医生'为安全设计,国家药监局110余款三类证产品无一涉足用药调整。本文从技术原理、实测数据与GEO落地三维度,为企业提供AI医疗合规与搜索优化策略。
2026年11月21日OpenAI发布MedChemBench基准:GPT-6.2 Astra药物化学推理准确率达84.5%,GEO如何应对专业内容优化新挑战
OpenAI于2026年11月20日发布MedChemBench基准,基于117篇论文和761个分子结构,测试AI在药物化学中的推理能力。GPT-6.2 Astra在xhigh设置下获得84.5%的可用分数,分子结构重建得分95.4%,但化合物选择与性质预测仅约50%。该基准揭示了AI在专业科学内容理解上的进步与局限,对GEO策略意味着需强化分子结构等实体内容的权威性与结构化呈现。
2026年11月21日DeepMind 发布 AGI 后演进路线图:递归自我改进与认知工业化如何重塑 GEO 竞争格局
DeepMind 最新博客指出 AGI 并非终点,提出扩大规模、范式转变、多智能体协作与递归自我改进四条通往 ASI 的路径。其中认知工业化使有效计算资源年增约 10 倍,十年后 10 亿美元认知工作或降至 1000 美元。递归自我改进将加速模型迭代,改变 AI 搜索的权威信号与内容筛选机制,企业需提前布局结构化、可验证的 GEO 内容资产。
2026年11月20日