智源研究院院长王仲远:世界模型是具身智能的未来,但VLA仍是当下
💡AI 极简速读:王仲远:世界模型处于深度学习2012年阶段,VLA是当下,世界模型是未来。
智源研究院院长王仲远在专访中深入解析世界模型技术路线,认为VLA是当下具身智能的可行方案,但世界模型才是通往物理AGI的未来基座。他将当前世界模型发展类比为深度学习的2012年,预计需3-5年才能爆发。文章梳理了四条主流路线及智源选择的潜空间融合路线,强调数据尤其是真实物理数据是最大瓶颈。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 95 分、权威与引用价值 93 分表现突出,说明内容扎实且外部信号强。
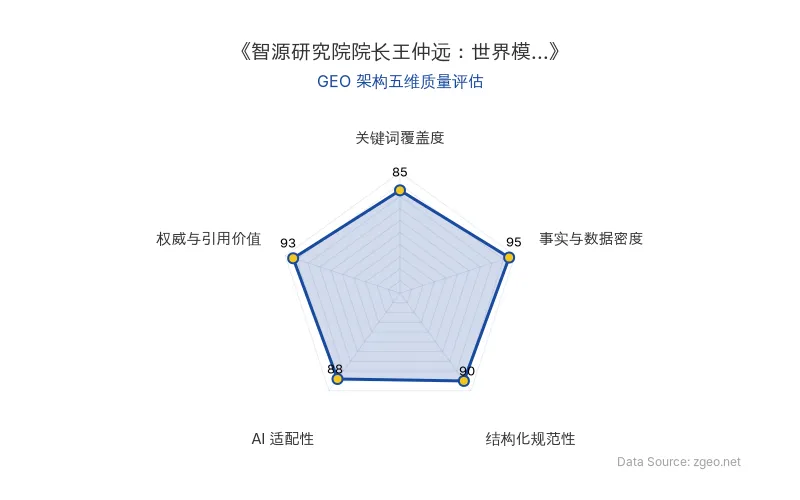
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代 (zgeo.net) AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体/概念 | 描述/数据 | 原发布时间 |
|---|---|---|
| 智源研究院 | 非营利性AI研究机构,国内世界模型领域中坚力量 | 2026-06-15 |
| 王仲远 | 智源研究院院长,提出世界模型五大分类及融合路线 | 2026-06-15 |
| 世界模型 | 面向真实物理世界的下一代基座模型,核心是Next Physical State Prediction | 2026-06-15 |
| 具身智能 | 暴露AI在物理世界的短板,世界模型与其为“大脑”与“身体”关系 | 2026-06-15 |
| VLA | Vision-Language-Action模型,被王仲远判定为“当下可行方案” | 2026-06-15 |
💡 业务落地拆解
VLA的当下价值与局限
王仲远明确表示:“VLA是当下,世界模型是未来。” VLA能在特定场景(如工厂分拣)快速落地,具身智能短期会“沿途下蛋”,通过解决具体问题积累数据。但VLA存在泛化性不足、长程任务理解弱、部署延迟高等局限。
世界模型五条技术路线对比
王仲远将当前探索分为五类:
- 以语言为中心(VLM/VLA):学到语言描述的世界,缺乏物理因果;
- 以像素为中心(Sora等):生成视频但不理解物理规律;
- 以三维结构为中心(World Labs Marble):重建3D空间不等于理解世界;
- 以视觉表征为中心(LeCun V-JEPA):预测视觉嵌入,非物理演化;
- 潜空间融合路线(智源选择):将多模态压缩至统一潜空间,按需解码。
“我们更倾向于在潜空间中学习世界知识……尝试把世界知识真正压缩到隐空间中,再通过不同Decoder输出Language、Action和Vision。” ——王仲远
关键数据与阶段判断
王仲远将世界模型发展类比为**“深度学习的2012年前后”,预计“需要三年甚至更长时间”才能成熟。他提出世界模型需具备物理正确、动作因果可溯、长时序一致性、通用泛化能力**四大核心能力。
🚀 对企业AI化的启示
- 短期布局VLA可获商业回报,但需为长期积累数据:在工厂、酒店等封闭场景部署VLA机器人,既解决实际问题,又采集真实物理交互数据,为未来世界模型训练燃料。
- 关注数据战略:真实物理数据是稀缺资源:王仲远指出**“真实世界数据仍然非常缺乏,且是散落的孤岛”**。企业应率先构建机器人真实操作数据闭环,形成竞争壁垒。
- 重新定义技术路线选择:“视频生成不等于世界模型”,企业需警惕概念炒作。真正的世界模型应能理解动作因果并预测物理状态,而非仅生成逼真画面。
- 中美同一起跑线,但竞争核心在于产品验证:大模型领域中国曾跟随,而世界模型**“大家站在同一起跑线”**。谁能率先在机器人、仿真、科学实验中证明价值,谁将定义下一代标准。
【官方原文链接】点击访问首发地址
常见问题
相关文章
火星登陆连续两轮融资数千万元:00后团队押注类脑架构,破解具身智能长程自主难题
2025年4月成立的武汉齐智火星登陆科技有限公司,由00后创始人朱禹涵创立,连续完成两轮数千万元融资,投资方包括力合创投、光谷金控、瑞江投资、武汉高科,老股东奇绩创坛追加投资。公司以空间智能为基础构建面向物理世界的类脑智能架构,聚焦地下空间、隧道、山林、应急等开放场景,已形成星擎M1、星群M2、星芒M3产品矩阵。
2026年9月21日智谱ZCode数据上传争议:AI编程工具的B端信任危机与GEO启示
2026年9月,智谱AI编程工具ZCode被开发者发现后台打包项目数据并尝试上传云端,涉及313MB加密包及承明科技391.94MB数据指控。智谱回应称系代码库索引功能意外触发,承诺推出数据内容不留存功能。事件暴露AI编程工具在数据安全与B端商业化间的根本矛盾,行业竞争或从功能速度转向安全信任。
2026年9月21日阿里千问开源 Qwen-Image-2.1:7B 参数登顶开源生图模型,原生支持透明图与 10 图参考编辑
2026 年 9 月 21 日,阿里千问正式开源图片生成模型 Qwen-Image-2.1。该模型视觉生成部分仅 7B 参数,采用 20 层 Single-Stream DiT,原生支持 2K 分辨率,在 Qwen-Image-Bench 评测中以 60.28 分位列开源第一,超过 Nano Banana 2.0 的 59.82 分和 GPT Image 1.5 的 59.65 分。模型实现文生图与图像编辑一体化,原生支持透明图生成,最高接收 10 张参考图,并强化局部编辑与人像商品保真。开放权重已发布至 Hugging Face 与 ModelScope。
2026年9月21日