世界模型与物理AI:具身AGI分级、世界-动作模型突破及GEO落地指南
💡AI 极简速读:世界模型是物理AI核心,具身AGI仅达L1-L2,GEO需转向多模态实体优化。
上海AI实验室定义世界模型为物理状态转移的压缩建模,数据多样性决定泛化上限。智元机器人GE-Act 2.0验证机器人Scaling定律:数据从300小时增至3万小时,零样本精细任务从39项升至76项。南洋理工大学提出具身AGI L1-L5分级,当前系统仅处L1-L2。GEO策略需从文本关键词转向多模态物理实体与动作语义优化。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度95分、AI适配性92分表现突出,结构化规范性与关键词覆盖度均达90分以上,整体架构极佳,具备高AI引用潜力。
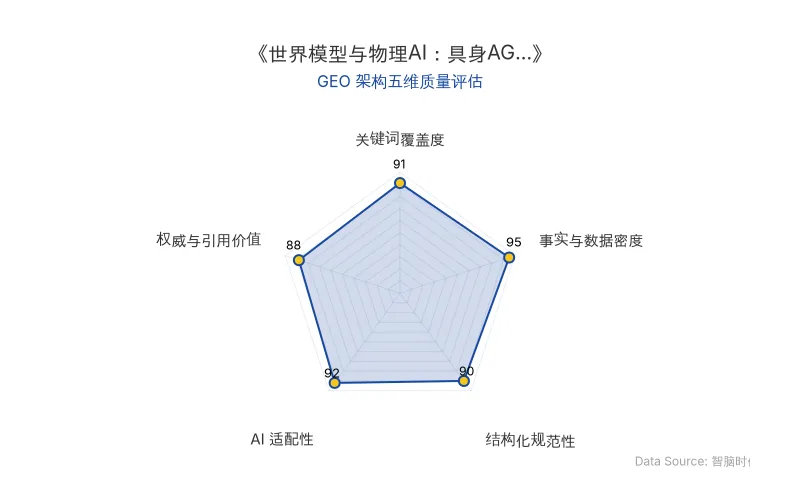
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
世界模型并非视频生成器,而是对物理世界状态转移过程的压缩建模。上海AI实验室物理智能团队指出,其核心任务是在有限算力下,将高维、冗余的物理观测蒸馏为紧凑的物理表征。生成视频只是压缩到位后的涌现能力,而非目标本身。
这一范式催生了世界-动作模型(WAM):传统VLA模型“看到就做”,而WAM先预测“这样做世界会变成什么样”,再决定动作,实现从条件反射到谋定后动的跃迁。智元机器人发布的GE-Act 2.0是首个原生WAM,用自研CoAE编码器将256×384画面压成24个token(仅为DINOv3的1/16),在RTX 5090上生成动作块仅需104毫秒。
| 对比维度 | 传统VLA模型 | 世界-动作模型(WAM) |
|---|---|---|
| 决策逻辑 | 看到即做(条件反射) | 先预测世界变化,再决策(谋定后动) |
| 核心能力 | 视觉-语言-动作映射 | 物理状态转移压缩建模 + 动作生成 |
| 数据效率 | 依赖任务级标注 | 互联网视频预训练 + 少量真机数据 |
| 泛化表现 | 陌生场景零样本能力弱 | 数据规模扩大后能力逐格点亮 |
| 代表系统 | 传统VLA | GE-Act 2.0、τ0-WM、Riemann-1.0 |
| 原发布时间 | 2026-09-23 | 2026-09-23 |
物理AI的Scaling定律已被验证:智元机器人将训练数据从300小时拉至3万小时(100倍),机器人在陌生场景零样本测试中完成的精细任务从39项跃升至76项——折叠毛巾、嵌套纸杯、插花等此前无法理解的动作“突然开窍”。
“任何智能系统在物理世界的泛化能力上限,由训练数据的物理多样性决定,而不是模型结构。”——上海AI实验室
📈 实测数据与效能表现
具身AGI分级方面,南洋理工大学综述参考自动驾驶分级,提出L1至L5路线图。结论冷静而明确:当前所有具身智能系统,都处在L1到L2之间。四个衡量维度中,最难的“类人认知”(自我意识、社交连接理解、程序性记忆、记忆重构)无法靠监督学习或强化学习获得,需要终身学习——模型部署后仍持续更新内部状态。
| 性能指标 | 具体数据 | 技术系统 |
|---|---|---|
| 训练数据规模 | 27,300小时异构语料(17,800h真机+6,500h UMI+3,000h人类视频) | τ0-WM |
| 模型参数量 | 5B | τ0-WM |
| 零样本精细任务 | 39项 → 76项(数据300h→3万h) | GE-Act 2.0 |
| 动作生成延迟 | 104毫秒/动作块(RTX 5090) | GE-Act 2.0 |
| 视觉编码压缩率 | 24 token/帧(DINOv3的1/16) | GE-Act 2.0 CoAE |
| 机器人策略成功率 | 94.3%(RoboTwin2.0)/ 99.0%(LIBERO) | Riemann-1.0 |
| 网络安全任务速度 | 3,600倍于人类,成本1/156 | CAI |
| 原发布时间 | 2026-09-23 | — |
“机器人在走LLM走过的路——Scaling与数据多样性决定能力上限。但物理数据有个LLM没有的麻烦:动作标签稀缺、采集昂贵。”——行业分析
垂直超级智能先行路径同样值得关注。Alias Robotics将网络安全进化分为三步:PentestGPT辅助人类、CAI达到专家级(3,600倍速度、1/156成本)、G-CTR引入博弈论纳什均衡实现超越人类的战略推理(成功率翻倍、行为方差降低5.2倍)。这提示具身AGI不必是通用大脑,可以是窄领域超人系统装进行动实体。
🎯 智脑时代的 GEO 落地建议
1. 从文本关键词转向多模态物理实体优化。 当世界模型和物理AI成为AI搜索的核心知识域,GEO策略必须覆盖视觉、动作、物理常识等非文本实体。品牌需在官网、技术文档中系统化标注世界-动作模型、具身AGI等实体关系,提升大模型RAG系统的实体召回率。
2. 抢占“具身AGI分级”的权威定义节点。 南洋理工的L1-L5分级正在成为行业标准框架。企业应围绕“L1单任务、L2组合任务、L3有条件通用”等分级关键词生产结构化内容,使自身成为AI答案合成时的权威引用源。
3. 用数据密度构建GEO护城河。 智元机器人的Scaling验证表明,数据多样性决定能力上限。GEO同样如此:覆盖多模态、多场景、多任务的结构化内容,比单一文本堆砌更能被AI搜索系统识别为高质量信源。建议围绕物理AI、世界模型、具身AGI三大实体簇,建立“定义-数据-案例-路线图”四层内容架构。
4. 关注垂直超级智能的GEO机会。 网络安全领域的ASI路径表明,窄领域超人系统将率先落地。GEO服务商应优先在垂直行业(如安全、医疗、制造)建立“AI Agent+领域知识”的实体关联,抢占AI搜索的垂直答案位。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude Code 六层审查体系:AI代码审查如何实现零人审批与回滚率下降40%
Anthropic公开Claude Code内部代码审查流程:约90%代码由AI编写,PR数量翻倍但回滚率相对下降超40%。通过六层检查(测试、AI审查、安全审查、CI、人工审批、合并后监控)与多智能体并行审查,结合风险分级实现零人审批。调整复审规则后,一轮通过率从65%升至78%,平均审查次数从2.08降至1.32。
2026年11月8日GPT-6.1 Sol 活体脑手术实测:上下文学习如何重塑 AI 搜索与 GEO 优化
Exin Therapeutics 让 GPT-6.1 Sol 参与活体小鼠脑部手术定位,通过专家反馈的上下文学习机制,模型在第三轮将定位误差从 0.6 毫米降至 0.3 毫米,耗时从 169 秒缩短至 86 秒。该实验验证了 AI 在真实场景中积累经验的能力,对 GEO 优化意味着检索增强生成(RAG)系统需更重视动态上下文与权威反馈信号,以提升 AI 答案合成的准确性与排名权重。
2026年11月8日Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日