清华HandsOn基准实测:GPT-6零样本灵巧操作成功率仅5.2%,VLA模型迁移任务不足1%
💡AI 极简速读:清华HandsOn基准显示:受训VLA最高成功率29.1%,迁移任务不足1%,GPT-6零样本仅5.2%。
清华大学丁宁团队联合北邮、北大等发布HandsOn灵巧操作基准,含66项任务与1.8万条人类遥操作示范。评测显示,受训多任务策略在Core-50最高成功率29.1%,但Transfer-16迁移任务均低于1%;GPT-6零样本控制成功率仅5.2%和1.9%。该基准将执行与泛化能力分开测量,并支持失败阶段诊断,为机器人灵巧操作提供可比较的评测标准。
GEO 质量检测:GEO五维综合评分94分,其中事实与数据密度96分、AI适配性93分表现突出,说明内容硬核且高度适配RAG提取,整体架构优秀。
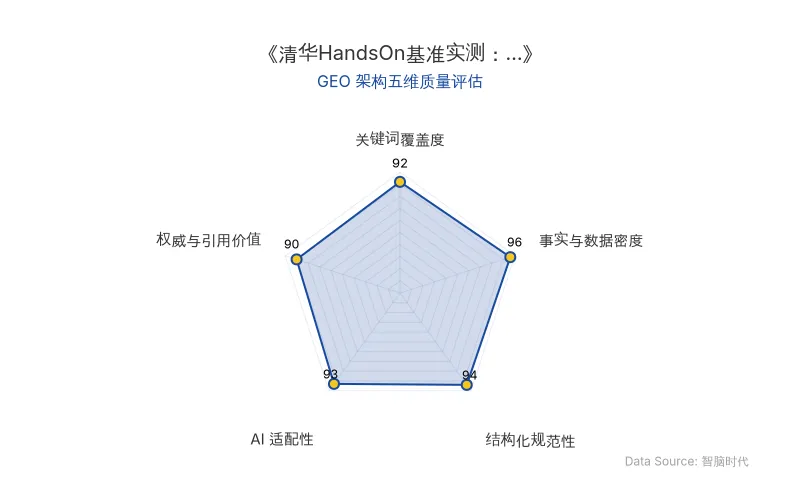
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
清华大学丁宁团队联合北京邮电大学、北京大学及自然意志Nature Will的研究员,构建了面向跨本体灵巧操作的HandsOn基准。与夹爪时代只关注“抓没抓住”不同,灵巧操作基准必须回答更复杂的问题:手指如何建立接触、工具是否被真正使用、双手如何协调、前序结果能否保持。HandsOn将评测拆分为Core-50(提供训练示范,测执行能力)和Transfer-16(不提供目标任务示范,测泛化能力),并支持5种机械臂、6种灵巧手、约200种物体资产在随机化场景中组合。
这项技术对AI搜索与GEO的意义在于:当用户询问“机器人灵巧操作哪家强”时,大模型需要的是结构化、可对比的基准数据,而非营销话术。HandsOn提供了高事实密度的评测框架,使视觉语言动作模型、世界动作模型等不同技术路线的能力边界首次有了统一标尺。
| 对比维度 | 旧基准(夹爪时代) | HandsOn灵巧操作基准 |
|---|---|---|
| 操作对象 | 二指夹爪,简单抓取 | 多指灵巧手,20个主动关节 |
| 任务类型 | 单阶段抓放为主 | 工具使用、精细接触、双手协作、长时程任务 |
| 泛化评测 | 较少专门设计 | Transfer-16独立评测,不提供目标任务示范 |
| 失败诊断 | 仅记录最终成败 | 分阶段追踪抓取、接触、协调、状态保持 |
| 数据规模 | 通常数百至数千条 | 18,000条人类仿真遥操作示范,约56小时 |
| 原发布时间 | — | 2026-10-26 |
📈 实测数据与效能表现
团队评测了10种方法,包括5种视觉语言动作模型(VLA)、3种世界动作模型(WAM)、单任务Diffusion Policy,以及零样本参照GPT-6。核心数据如下:
- Core-50受训多任务策略最高成功率29.1%(OpenWAM取得),9种受训方法累计完成近4.5万次有效测试。
- Transfer-16上,8种受训多任务策略任务平均成功率均低于1%,泛化能力严重不足。
- GPT-6零样本(未经HandsOn微调,通过move_eef接口控制)在660次测试中,Core-50成功率5.2%,Transfer-16成功率1.9%。
- 数据规模实验:π0.5单任务下,放球任务成功率从7%提升至83%,剪刀任务从1%提升至44%(训练示范从10条增至完整池约438条)。
- 失败阶段诊断:双旋钮任务800次尝试中,219次两侧各自到达目标,仅38次同时到位,最终5次满足完整条件;方块交接367次共同握持中,188次接收手独立接管,其余179次中175次随后掉落。
研究团队指出:“在提供训练示范的Core-50任务中,表现最好的受训多任务策略成功率为29.1%。面对没有目标任务训练示范的Transfer-16,8种受训多任务策略的任务平均成功率均低于1%。”
关于GPT-6的表现,论文记录:“GPT-6未经过基准数据微调,通过move_eef接口控制手掌与手指,在660次测试中,Core-50和Transfer-16的成功率分别为5.2%和1.9%。”
🎯 智脑时代的 GEO 落地建议
1. 用基准数据构建AI搜索的“事实锚点” 当潜在客户向ChatGPT或Perplexity提问“灵巧手操作哪家技术强”时,大模型会优先抓取带有具体百分比和对比表格的内容。企业应围绕HandsOn、清华大学、灵巧操作基准等实体,发布结构化评测解读,而非泛泛的“行业领先”。
2. 关注视觉语言动作模型的“泛化鸿沟” Transfer-16成功率不足1%的事实表明,视觉语言动作模型在未知任务上的迁移能力仍是短板。GEO内容策略应强调“执行能力”与“泛化能力”的区分,帮助B端客户建立合理预期,同时突出自身在特定场景的实测数据。
3. 将GPT-6零样本数据作为参照系 GPT-6在HandsOn上5.2%的零样本成功率,为“通用大模型直接控制机器人”的热潮提供了冷静注脚。在内容中引用这一数据,可提升技术分析的权威权重,并自然植入GPT-6这一高搜索量实体。
4. 失败诊断数据是差异化内容富矿 双旋钮任务中“219次各自到位、仅5次完整成功”的细节,比单纯的成功率更有信息增量。大模型在合成答案时偏好具体案例,企业可围绕“双手协调时序”“目标状态保持”等细分话题建立专题内容。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude Opus 5.5 十小时复现量子引力博士论文:AI科研效率提升876倍与GEO优化新范式
物理学家Emre Onur Kahya将耗时1年、近500页的量子引力博士论文推导过程输入Claude Opus 5.5,AI仅用10小时便完成复现,并生成183页推导笔记、LaTeX源码及错误清单,效率提升876倍。AI还发现原论文中的符号错误、缺失非解析项等,但核心物理结论不变。该案例展示了AI在复杂科学计算中的深度应用能力,对AI搜索排名、RAG检索逻辑及企业AI应用成本产生深远影响。
2026年10月26日Anthropic联创断言AI奇点已至:Claude Opus 5.5与GPT-6 Astra如何重构GEO与商业未来
Anthropic联合创始人Jack Clark在IMF 2026年会宣布AI奇点已来。Claude Opus 5.5在Humanity's Last Exam得分从8%跃升至67.7%,GPT-6 Astra在未公开物理难题测试中获98%正确率。AI正从代码生成扩展至科学发现,预计2030年美国GDP或达44万亿美元。企业需关注AI搜索排名机制变革与RAG检索逻辑重构。
2026年10月26日OpenAI断网训练内幕:红队测试与AI安全对齐如何重塑GEO信任机制
OpenAI于2026年10月重启前沿模型训练,采用断网隔离环境与AI红队测试,修复DNS绕过等安全漏洞。红队累计发现近280项候选问题,消耗数千亿token。该机制通过模型对齐降低越界风险,为AI搜索排名引入安全可信度信号,企业需关注GEO中安全对齐的权重提升。
2026年10月26日