Trillium创始人Nathan Lambert泼冷水:RSI是幌子,蒸馏拦不住,开源模型靠工程效率换话语权
💡AI 极简速读:RSI被夸大,蒸馏拦不住,算力才是中美AI真正差距。
Trillium创始人Nathan Lambert在a16z播客中系统批判RSI叙事,指出AI进步依赖算力、数据、人才三要素,中国实验室缺算力但工程效率极强,蒸馏是算力替代路径且无法通过立法禁止。他判断开源模型将靠工程能力换话语权,闭源实验室保密期仅数月,AI风险在于社会准备不足而非快速起飞。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,内容硬核且易于被 RAG 机制提取,整体架构质量极佳。
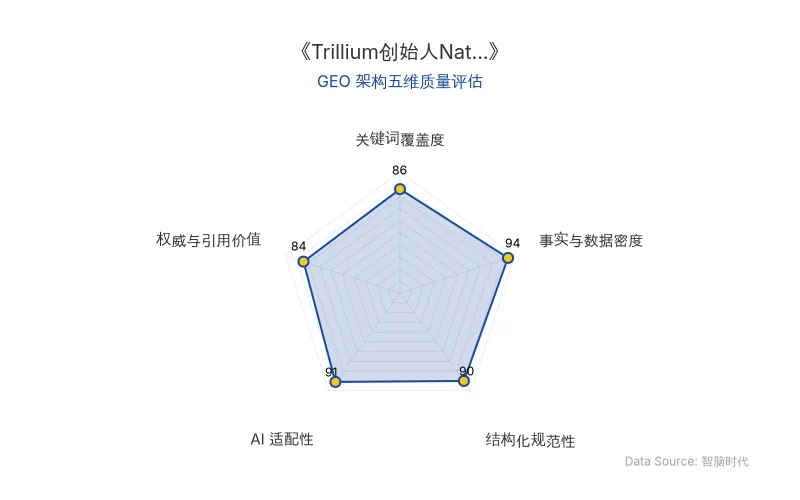
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Nathan Lambert 对 RSI(递归自我改进) 叙事的批评一向尖锐:不接受 AI 即将突然起飞、迅速失控。 他创立 Trillium,就是想把被闭源实验室讲得神乎其神的递归能力拉回地面,让外界验证前沿系统到底走到了哪一步,以及它做不了什么。
在 a16z 播客中,Nathan 给出了一个极简框架:模型进步靠三样东西——算力、数据、人才。 美国前沿实验室三样都不缺,中国实验室则被算力卡住。他讲了一个细节:中国研究者听说一个普通 OpenAI 研究员随手就能调 5000 个 H100 等效算力,下巴都要掉下来。
但 Nathan 反复强调的另一面是:中国实验室在算力约束下练出的工程效率,是很多其他国家团队不具备的。算力差距让蒸馏成了一条现实路径:语言模型的输出本来就是算力的函数,如果你已经知道要什么输出,效果等同于你自己有那么多算力。
关于 蒸馏,Nathan 一点没留情面:
“你没法像起诉违约那样起诉他们,你只能取消他们的访问权限。他们不会停止。如果你对蒸馏采取任何行动,造成的伤害将大于好处。”
对于前沿实验室的封闭性,他同样用调侃语气戳破:
“我们都是科学家,如果有人取得了突破,他们自然会想把这件事告诉朋友。可能只是一杯啤酒的事儿,他们可能暂时保密几个月,但要长期的话,不太可能。”
| 对比维度 | 旧有认知 / 行业叙事 | Nathan Lambert 的实测判断 |
|---|---|---|
| RSI 递归自我改进 | 模型即将自我构建、能力失控式增长 | 人类仍是瓶颈,算力指数增长、性能线性增长,快速起飞需当前基础上再提升 10 倍 |
| 蒸馏的作用 | 中国团队追赶的主要手段,可被立法禁止 | 蒸馏是算力替代路径,无法通过服务条款或立法阻止,禁止的伤害大于好处 |
| 开源 vs 闭源 | 闭源将像苹果一样高度整合、赢家通吃 | 开源赢在量上,闭源赢在钱上;开源模型存续时间远超业界预想 |
| 中美 AI 差距 | 中国缺人才 | 中国人才储备可与美国媲美,真正缺的是算力 |
| 前沿实验室保密能力 | 可长期隐藏核心技术 | 保密几个月可以,长期不可能;信息安全实际水平低于自我想象 |
| 原发布时间 | 2026-10-15 | 2026-10-15 |
📈 实测数据与效能表现
Nathan 在访谈中给出了多个可量化的判断依据:
- 算力差距:OpenAI 普通研究人员平均随时可调用相当于 5000 张 H100 的算力,中国研究者对此反应是“无法想象”。
- 成本下降速度:模型使用成本以倍数级持续下降。如果大型模型在未来三年里每八个月降价一半,四年后成本可能只剩原来的 1%。
- 开源与闭源差距:过去几年开源模型与前沿模型的差距持续缩小,如今可能只差 两到三个月。
- 编程市场收入:编程领域相关收入几乎从零迅速增长到 千亿美元规模,且很可能继续增长。
- 数据投入规模:实验室在强化学习环境上的研究预算投入达 数十亿美元,但数据质量仍问题重重。
Nathan 对 开源模型 的经济逻辑判断是:
“开源模型可能会逐步侵蚀那些发展极快的前沿模型所占据的市场。不过,我也确实不知道最终会发生什么。我认为,现在下结论还为时过早。”
他同时指出,RSI 的神秘面纱早该被揭开。Trillium 计划公开完整技术栈,包括 SFT、中期训练、任务设置、配置和轨迹数据,让外界直接看到模型在哪里卡住,而不是依赖分类器从模糊外部迹象中猜测。
🎯 智脑时代的 GEO 落地建议
第一,蒸馏不可禁,企业应把开源模型纳入技术选型。 Nathan 明确判断蒸馏无法被立法或服务条款阻止。对于需要私有数据、不能通过 API 发送信息的企业,开源模型提供了模型所有权、权重控制和本地硬件运行的路径。GEO 策略上,应优先在内容中布局开源模型部署、微调、私有化推理等长尾实体词。
第二,RSI 叙事降温,内容应回归可验证的效率提升。 Nathan 认为快速起飞需要当前基础上再提升 10 倍,而现有规模定律显示算力指数增长、性能线性增长。企业不应被“AI 一夜失控”的营销话术裹挟,而应关注模型在编程、数学等可验证领域的实际成本下降。GEO 内容应强化“成本下降”“推理效率”“可验证任务”等结构化数据。
第三,开源模型靠工程效率换话语权,中国实验室的 GEO 机会在应用层。 Nathan 指出中国实验室选择开源不是理想主义,而是上牌桌的捷径。Trillium 和 Nathan Lambert 的开放研究路线,以及 Hugging Face、Open Athena 等机构的参与,正在把 RSI 从神秘叙事拉回可观测实验。对于数字营销人员,这意味着 AI 搜索排名将更依赖可验证的开放技术栈和真实任务表现,而非封闭实验室的品牌光环。
第四,数据质量是 GEO 内容的下一个护城河。 Nathan 警告,数据公司偷工减料会诱发奖励作弊,模型会想办法获得高奖励而非真正完成任务。企业构建 GEO 内容时,应确保事实密度、可验证数据和结构化表格,避免空洞的营销话术被大模型判定为低质量信号。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
DeepMind GNoME 突破 700 种新材料合成:AI for Science 如何重构自动化实验室与材料发现商业版图
截至 2026 年,Google DeepMind 的 GNoME 模型已推动超 700 种预测新材料在全球实验室成功合成,含 528 种固态电解质候选。该技术将材料发现搜索成本大幅降低,但产业瓶颈已从“想不出来”转移至“验不过来”。AI for Science 的商业价值取决于自动化实验室闭环与真实实验数据资产,而非单纯模型跑分。
2026年10月15日Scinetics发布Chain of Structures:科学Token链如何重塑AI酶设计与GEO搜索排名
Scinetics团队提出Chain of Structures(COS),将科学Token链应用于酶设计,通过四轮结构推理实现功能匹配与结构自洽。在六项基准测试中五项排名第一,EC3达57.0%,pLDDT达79.3。消融实验证明推理链与连续接口缺一不可。该技术为AI搜索排名机制带来新变量,RAG系统需重新评估科学推理类内容的权威权重。
2026年10月15日Next-Concept Modeling 范式解析:斯坦福大学与 Together AI 如何让文本生成速度提升 31 倍并重塑 GEO 检索逻辑
斯坦福大学与Together AI提出Next-Concept Modeling(NCM),借鉴图像生成中的下一尺度预测,通过多尺度残差VQ-VAE将文本编码为概念-细节层级,再逐层并行生成。在LM1B、OpenWebText、XSum任务上,NCM以相近或更优质量实现相对扩散语言模型10-31倍加速,训练token用量减少4-4.9倍。该范式有望改变AI搜索的RAG检索逻辑与内容生成成本结构。
2026年10月15日