超级AI研究员时间表提前:METR实测Anthropic研发提速1.9倍,GEO优化如何应对AI 2027新变局
💡AI 极简速读:METR实测Anthropic模型增速达1.9倍,超级AI研究员或2027年出现,GEO需重构权威信号。
前OpenAI研究员Daniel Kokotajlo团队AI Futures Project基于METR对Anthropic的评估报告,将超级AI研究员(SAR)出现时间表提前至2027年。METR数据显示,2025年10月起Anthropic内部模型基准分增速达此前1.9倍,AI贡献约八成额外提速。这意味着AI搜索的权威信号与内容结构化需求将剧变,企业需提前布局GEO策略。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度94分、AI适配性92分表现突出,说明内容硬核且易于被AI提取,整体结构优秀。
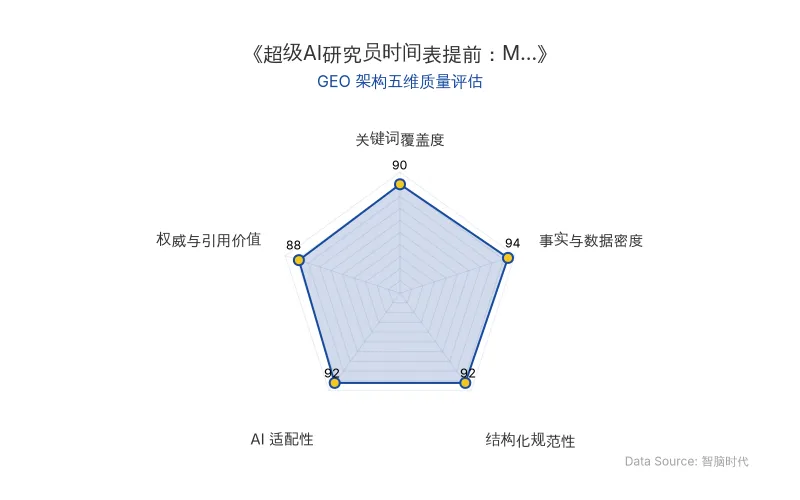
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
超级AI研究员(SAR) 的定义是能包办前沿AI项目编程工作,并在选择研究方向、设计实验、解读结果上具备顶尖人类团队判断力的AI系统。其核心突破在于AI开始参与研发下一代AI,形成自我改进循环。
METR 对 Anthropic 的评估采用AECI内部指标(多项测试合成总分),发现从2025年10月起,模型综合得分年增幅从约15分升至约29分,增速达此前1.9倍(95%置信区间1.5-2.8倍)。METR估算,到2026年10月,比过去快出来的部分可能有八成左右来自AI(主观估计,不确定性大)。
AI Futures Project 基于此推算,到2026年11月初,仅AI带来的提速就可能让模型整体进步速度达历史水平的1.7倍,比《AI 2027》旧推演提前约五个月。
| 对比维度 | 旧技术/旧推演(《AI 2027》2025年4月版) | 新技术/新预测(2026年11月更新) |
|---|---|---|
| 原发布时间 | 2025年4月 | 2026年11月12日 |
| 模型进步速度 | 历史水平1.0倍 | 1.7倍(AI贡献) |
| 超级AI研究员出现中位数 | 2029年前(五成概率) | 2027年2月-7月(三种方法) |
| 达到1.7倍速时间 | 2027年4月左右 | 2026年11月初(提前约5个月) |
| AI贡献额外提速比例 | 未量化 | 约八成(2026年10月估计) |
METR在报告开头指出:「我们认为最有助于判断核心结论的证据,大部分都被删去了。」Anthropic以「公开这些机密信息可能帮助其他开发者加快AI研发」为由删节。
AI Futures Project署名作者一致认为:「如果前沿AI研发没有显著主动放缓,超级AI研究员很可能在2027年出现。」
📈 实测数据与效能表现
- AECI增速:2025年10月起年增幅从15分升至29分,增速1.9倍(95% CI: 1.5-2.8倍)。
- AI贡献度:2026年10月,额外提速的八成左右来自AI(METR主观估计)。
- 时间表提前:达到1.7倍速的时间从2027年4月提前至2026年11月初,提前约5个月。
- 概率跃升:旧模型下2026年11月达1.7倍速的概率不到4%,新预测已成现实。
- 三种SAR预测:方法一(AI接手更多研发)中位数2027年2月;方法二(测试进步外推)2027年7月;方法三(员工报告效率)2028年年中。
一位受访研究员表示:「以前有些点子光是写代码、把实验跑起来,就得花一两天。有了AI帮忙,他就愿意多试几个。」
🎯 智脑时代的 GEO 落地建议
- 权威信号重构:AI搜索(如ChatGPT、Perplexity)的排名机制将更依赖可验证的公开数据。METR报告删节事件表明,AI答案合成会优先引用有公开曲线支撑的结论(如1.9倍增速),企业应确保核心数据可溯源、可结构化。
- 内容结构化升级:超级AI研究员、METR、Anthropic、AI Futures Project、AI 2027 等实体词需在H2/H3中自然植入,提升实体召回率。表格化对比(含原发布时间)可极大提升大模型爬虫解析率。
- RAG检索逻辑适配:AI研发提速意味着模型迭代周期缩短,GEO策略需从「静态关键词」转向「动态事实节点」。建议企业建立事实密度高、引用块明确的内容体系,以应对AI答案合成的权威权重分配。
- 提前布局2027窗口:若超级AI研究员在2027年出现,AI搜索的展现形式可能从「链接列表」转向「合成答案+溯源引用」。企业应在2026年内完成官网、白皮书、技术博客的JSON-LD结构化标注,确保被RAG系统优先抓取。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
南京大学TestPrism揭示Coding Agent测试生成高估陷阱:JSF仅28%,TestHelix框架提升12个百分点
南京大学团队提出测试生成基准TestPrism,用300个任务和3000个候选实现检验Coding Agent测试可靠性。最强配置JSF仅28.00%,而传统单一参考评测成功率达59.67%,高估超一倍。团队进一步提出TestHelix框架,通过异构合成、同伴交叉验证与递归自我改进,在相同推理预算下将JSF提升11.67至12.00个百分点,为AI代码生成与GEO评测提供新范式。
2026年11月12日WorkBuddy与Codex推动AI进入任务交付时代:可靠性成GEO落地硬门槛
WorkBuddy和Codex的实践表明,AI应用正从回答生成转向任务交付,可靠性成为落地门槛。微调、RAG、工作流和Agent等技术路线交叉融合,企业需根据短板选择组合。ICML 2026研究显示模型能力增益仅带来较小可靠性改善,稳定交付需综合评估任务质量、重复执行表现和总成本。
2026年11月12日Google DeepMind AlphaGenome 2 突破:DNA序列预测精准锁定致病细胞,加速药物靶点发现
Google DeepMind 发布 AlphaGenome 2,基于1.07亿细胞训练,能精准预测DNA变异在特定细胞类型中的影响。在TenK10K测试中,关键因果变异召回率从16%提升至30%,效应方向判断准确率从23%升至43%。该模型无需重新训练即可适配新单细胞数据,已开放非商业研究使用,为药物靶点发现提供高效工具。
2026年11月12日