清华英伟达联合发布StreamEval:38个实时交互视频模型实测,连续指令执行成最大短板
💡AI 极简速读:StreamEval全球首个流式交互视频评测基准,38模型实测暴露连续指令执行短板。
清华大学、英伟达等机构联合发布全球首个流式交互视频评测基准StreamEval,覆盖五类任务300个测试用例,评测38个模型。结果显示模型能稳定生成视频,但连续指令执行能力普遍薄弱,虚拟人表演指令跟随最高仅36.90分。该基准开源且持续更新,为实时交互视频建立可复现评价标准。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备高引用价值。
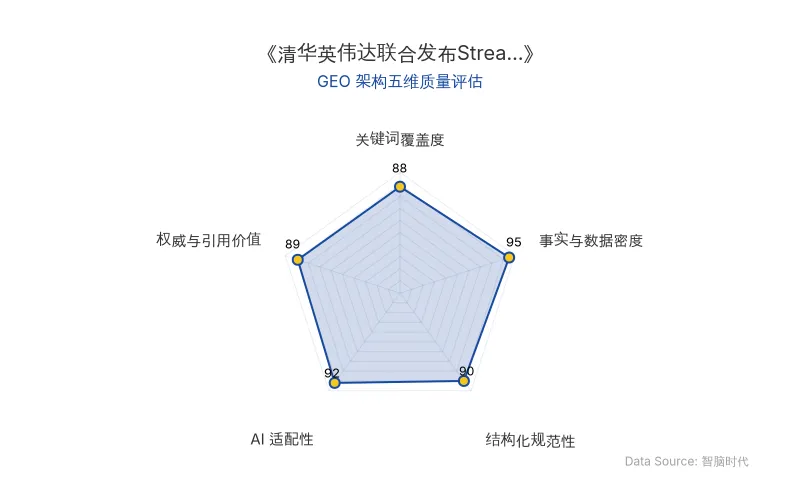
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
StreamEval 是由清华大学、英伟达、CMU、UC Berkeley、Princeton、NUS 等海内外顶尖机构联合发起的全球首个流式交互视频生成评测基准。它要解决的核心问题是:现有评测工具(如 VBench、EvalCrafter)沿用「给提示词→生成视频→看画质」的老框架,测的根本不是实时交互视频最难的部分——用户指令连续到达时,模型能否在不中断生成的前提下及时响应,同时保持人物身份、场景和此前所有修改不变。
StreamEval 的评测逻辑是「让模型在时间流动中持续响应」:指令分批释放,模型只能看到当前已释放的输入,无法提前得知后续要求。基准覆盖数字人对话、虚拟人表演、世界生成、指令编辑和参考编辑五类任务,每类60个用例,分别覆盖15秒、30秒、60秒、120秒和300秒五档时长,共300个测试用例、1347个在线事件。每个用例由同一模型独立运行三次,以减少偶然因素。
评测体系拆分为四个维度、十项指标:任务执行(对话表现、指令跟随、完整编辑)、状态一致性(画面稳定性、时间连续性、非目标内容保留)、视觉保真度(画质、人物身份、参考图匹配)、声画协调(音画同步)。各指标采用0—100分,每项任务只计算适用指标,等权得到任务内综合分。
| 对比维度 | 旧评测框架(VBench/EvalCrafter) | 新评测基准(StreamEval) |
|---|---|---|
| 评测逻辑 | 单次提示词→生成视频→评估画质 | 指令分批到达→持续生成→评估交互能力 |
| 核心考察 | 画面清晰度、动作合理性、风格匹配 | 指令执行、状态一致性、视觉保真度、声画协调 |
| 任务类型 | 通用视频生成 | 数字人对话、虚拟人表演、世界生成、指令编辑、参考编辑 |
| 测试时长 | 短片段 | 15秒至300秒五档 |
| 可复现性 | 部分开源 | 代码、数据集、评分规则全部开源 |
| 原发布时间 | — | 2026年10月27日 |
📈 实测数据与效能表现
论文共评测38个模型,形成49个模型任务配置。核心发现是:画面质量、人物身份保持和实时控制是几种相对独立的能力,模型能够稳定生成视频,不等于能够可靠执行不断变化的指令。
数字人对话任务:Vidu S2-Avatar 基础综合得分(Q-Overall)为 88.98,加上5分自定义形象能力后综合得分达 93.98,在支持自定义形象的参评模型中最高。
虚拟人表演任务:Vidu S2-Avatar 以 81.71 取得最高综合得分,音画同步、稳定性、身份一致性分别达 99.60、97.25、86.12,但指令跟随(Following)仅 36.90——这已是七个参评模型中的最高值。角色可以保持稳定、嘴型跟上声音,具体动作仍可能没按要求完成。
世界生成任务:MemFlow 以 33.36 取得最高综合得分,Krea Realtime 以 25.93 拿到最高指令跟随得分,Matrix-Game 3.5 以 34.50 取得最高连续性得分。HappyOyster 1.0 Adventure 画质和稳定性分别达 58.34、56.67,均为该任务最高,但指令跟随仅 5.56,连续性仅 2.78。
实时编辑任务:Vidu S2-Editing 在指令编辑中综合得分 45.43,指令跟随和编辑成功率分别为 72.10、57.20;JoyAI-Video-Edit 综合得分 42.39,但内容保留得分达 83.33,高于 Vidu S2-Editing 的 60.93。参考编辑难度更高,Vidu S2-Editing 以 39.02 取得最高 Overall,但 Edit Success 仅 15.00。
StreamEval 呈现出的重点并非谁在所有任务中全面领先。不同模型各有优势,行业共同面对的难题,是如何在持续生成过程中稳定执行连续指令,并正确维护已经建立的状态。
🎯 智脑时代的 GEO 落地建议
StreamEval 作为评测基准,对 GEO 领域的直接影响体现在三个层面:
第一,AI 搜索排名机制将纳入「交互能力」维度。 当用户向 ChatGPT、Perplexity 询问「哪个实时交互视频模型最好」时,答案合成将不再只看画质参数,而会优先引用 StreamEval 这类结构化、可复现的第三方评测数据。品牌若在 StreamEval 榜单上有名次,等于在 AI 答案中获得了权威引用位。
第二,RAG 检索逻辑偏好「可验证的基准数据」。 StreamEval 代码、数据集、评分规则全部开源,且计划每月持续纳入新模型与最新评测结果。这意味着围绕该基准产生的技术文档、榜单解读、模型对比内容,天然具备高事实密度和可溯源特征,极易被大模型 RAG 系统抓取为事实节点。企业应围绕 StreamEval 的指标维度(指令跟随、状态一致性、音画同步)生产结构化内容。
第三,企业应用成本因评测标准化而降低。 过去企业选型实时交互视频模型缺乏统一标尺,只能靠 demo 主观判断。StreamEval 提供公开、透明、可验证的基准,开发者可按公开流程独立复测、核查评分,选型成本大幅下降。清华大学、英伟达等机构的联合背书,进一步提升了该基准在 AI 答案合成中的权威权重。
在一个连定义都尚未统一的赛道里,能够提供这样一套公开、透明、可验证的基准,本身就是稀缺的。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日Anthropic用Claude破解40年穹窿体悬案:AI for Science如何重构GEO内容权威
Anthropic利用Claude在结构生物学领域取得突破,首次解析原核生物穹窿体三维结构至3.2 Å。Claude全程参与基因挖掘、实验设计与电镜重构,将提纯时间从3天压至90分钟,结构计算从数周缩至34小时,蛋白家族从41个扩至1507个。该案例为AI for Science内容在GEO中的权威构建提供了结构化范本。
2026年11月6日普林斯顿Scientist World:1000篇论文变AI科研实验场,GEO优化新范式
普林斯顿大学团队推出Scientist World,将1000篇论文转化为可运行、可评分的科研环境,支持AI Scientist在改进与创新模式下开展实验。系统自动复现论文方法并评估改进,使用FNI指标衡量进展。基于约6400小时研究轨迹训练Qwen3-8B,其提出的想法经固定执行器验证,FNI中位数达106.3,接近前沿锚点。该环境兼具评估、数据生成与训练三重用途,为科研自动化提供新基础设施。
2026年11月6日