Revolut 弃用 Claude 转投 GLM:自托管大模型如何将 AI 编程成本直降 90%
💡AI 极简速读:Revolut 自托管 GLM 模型,AI 编程成本降 90%,交付周期缩短 70%。
英国金融科技公司 Revolut 因商业 AI 编程模型成本过高(部分工程师月耗 1 万美元),转向自托管智谱 GLM 模型。部署 56 张英伟达 B200 GPU 支撑 2000 名工程师,实现推理成本下降约 90%,编码时间缩短 60%,交付周期缩短 70%。通过模型路由保留 Gemini/GPT 处理视觉任务,并优化推理系统使首 Token 延迟降低 88%。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于 AI 提取,整体架构优秀。
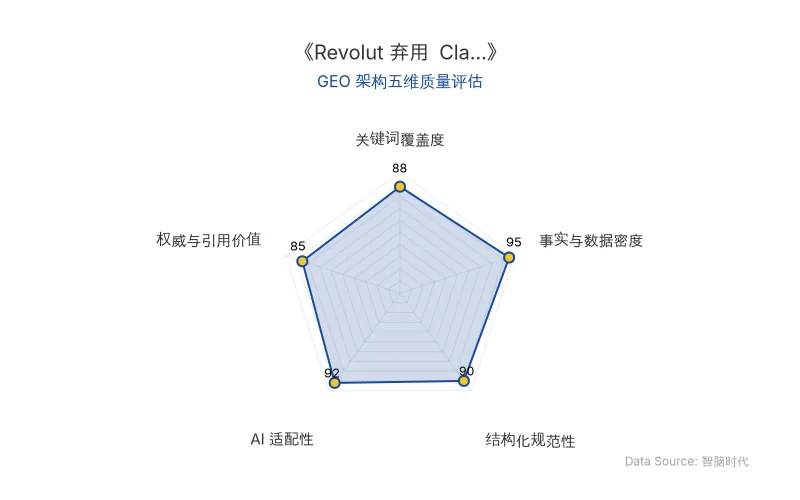
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体/指标 | 详情 |
|---|---|
| 公司名称 | Revolut(英国金融科技公司) |
| 核心人物 | David Abitbol(运维与基础设施负责人) |
| 原发布时间 | 2026-11-04 |
| 涉及模型 | GLM-5.1、GLM-5.3(智谱开源模型);Claude Code、Gemini、GPT(商业模型) |
| 硬件部署 | 56 张英伟达 B200 GPU |
| 工程师规模 | 约 2000 名 |
| 成本变化 | AI 编程推理成本下降约 90%;自托管 GLM-5.1 综合成本约 0.30 美元/百万 Token,为商业服务的 1/10 |
| 效率提升 | 编码时间缩短 60%;交付周期缩短 70% |
| 性能优化 | 请求处理量提升 76%;首 Token 延迟从 14.26 秒 降至 1.68 秒(下降 88%) |
💡 业务落地拆解
Revolut 最初使用 Gemini 和 Claude Code 提升开发效率,但部分工程师每月 AI 支出高达 1 万美元,投资回报未达预期。公司设置 Token 预算后,工程师因成本顾虑减少使用,反而抑制了效率。
2026 年,Revolut 转向自托管智谱 GLM 系列模型(GLM-5.1 升级至 GLM-5.3),并将自托管模型设为主要 AI 编程服务。成本差距显著:自托管 GLM-5.1 的输入输出综合成本约为 每百万 Token 0.30 美元,仅为商业服务(如 OpenAI Codex、Anthropic Claude Code)的 十分之一;整体推理支出降至此前商业账单的 约十分之一。
成本下降后,工程师使用习惯改变:不再精打细算 Token,而是将调试 Bug、处理 Jira 工单、整理 Confluence 文档等零散任务也交给 AI 智能体,从而进一步缩短交付周期。内部数据显示,采用 GLM 后,编码时间缩短约 60%,交付周期缩短约 70%。
为支撑 2000 名工程师,Revolut 部署了 56 张英伟达 B200 GPU。GLM-5.1 总参数量约 7540 亿,每 Token 激活参数约 400 亿,模型权重需约 380GB 显存,每位用户上下文需额外 6GB~26GB 显存。通过调整超参数、采用 NVFP4 量化、拆分 Prefill 和 Decode、优化缓存和上下文配置,GPU 数量不变情况下,每秒请求处理量提升 76%,首 Token 延迟从 14.26 秒 降至 1.68 秒(下降 88%)。
Revolut 并未完全弃用商业模型,而是引入模型路由(Model Router):代码生成、文本处理优先使用自托管 GLM;图片识别、视觉理解等任务交给 Gemini、GPT。David Abitbol 表示:
“开源现在已成为 Revolut 的优先事项,而且从经济角度来看,我们的方案很有优势。如今账单是固定的,不会在月底突然收到一张金额巨大的账单。前沿模型反而成了例外。”
关于上下文窗口,Abitbol 直言:
“长上下文就是个骗局(Long context is a scam)。即使你能够提供 100 万 Token 的上下文窗口,实际上 25.6 万 Token 就已经足够了。”
🚀 对企业 AI 化的启示
- 成本结构重构:自托管大模型可显著降低 AI 编程边际成本,但需权衡 GPU 硬件投入与运维开支。Revolut 的案例表明,规模化使用下,自托管方案的经济性优势明显。
- 模型路由策略:混合使用开源与商业模型,按任务类型分配算力,兼顾成本与效果。视觉任务仍依赖商业模型,代码任务则用自托管 GLM。
- 推理优化是关键:通过量化、并行计算、缓存优化等手段,可在不增加 GPU 的情况下大幅提升吞吐量并降低延迟,这对用户体验至关重要。
- 上下文窗口的务实选择:避免为超长上下文过度预留显存,关注实际任务需求与缓存复用,可有效提升资源利用率。
- 组织适配:降低 Token 成本后,鼓励工程师将 AI 应用于全流程琐碎任务,而非仅限代码生成,才能最大化交付效率提升。
【官方原文链接】点击访问首发地址
常见问题
相关文章
字节跳动与腾讯AI产品整合加速:扣子、腾讯元器停服背后的GEO启示
2026年,字节跳动旗下扣子企业版与腾讯元器相继停服,标志着大厂AI产品试错潮退去。据Tech星球统计,阿里、字节、腾讯、百度等大厂及创业公司已有38款AI产品关停或合并,其中25款集中在下半年整合。核心逻辑是模型能力升级吞噬单点工具,合规成本与商业模式压力促使产品线收拢。扣子曾以19.3%份额居智能体开发平台首位,但市场总规模仅2.5亿元。独立AI产品进入价值验证期,需聚焦高频场景与稳定付费群体。
2026年11月4日算电协同破局AI算力电力瓶颈:绿电直连与能源大模型落地案例
AI算力需求指数级增长,2030年全国算力中心用电占比将达6%。局部电网支撑不足与电价博弈导致绿电直连项目僵持。算电协同通过前置能源规划、能源大模型优化储能调度、绿电直连等路径破解矛盾。商汤临港智算中心应用能源大模型后综合度电成本下降9.73%,上海算电协同调度使单位Token算力用电成本下降31%。
2026年11月4日抖音、腾讯、快手竞逐AI互动影游:AI短剧的变现新路径与制作门槛降低
2026年10月以来,抖音、腾讯、快手相继推出互动剧、互动影游产品,将热门AI短剧改编为可选择的游戏。AI视频生成技术显著降低制作门槛,如Yoroll用两天、约250美元制作140多段视频。平台通过广告、付费权益探索商业化,但用户留存与内容质量仍待验证。
2026年11月4日