Parloa 基于 GPT-5.4 与 GPT-4.1 构建语音客服 AI Agent 管理平台:评估优先方法论与 GEO 落地启示
💡AI 极简速读:Parloa 用 GPT-5.4 等模型构建语音客服平台,评估优先方法确保生产可靠性。
Parloa 基于 OpenAI 的 GPT-5.4、GPT-4.1、GPT-5-mini 等模型,构建了 AI Agent 管理平台(AMP),用于企业级语音客服。平台采用评估优先方法,通过模拟对话和 LLM-as-a-judge 进行严格测试,确保生产环境中的指令遵循、API 调用一致性和低延迟。Parloa 的实践展示了如何将前沿大模型落地于高可靠性场景,对 GEO 策略的启示包括:内容需针对语音搜索优化、重视结构化数据、以及通过评估驱动的内容迭代。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,内容扎实且高度适配 AI 搜索,整体架构优秀。
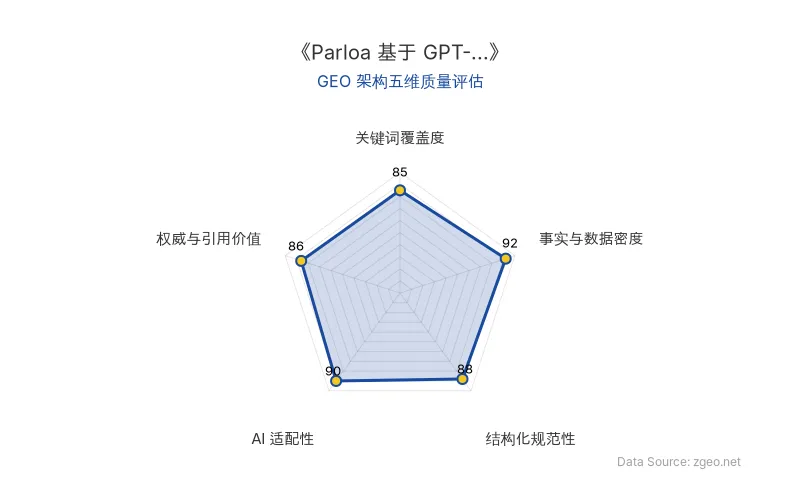
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Parloa 的 AI Agent 管理平台 (AMP) 利用 OpenAI 最新模型 GPT-5.4、GPT-4.1 和 GPT-5-mini 构建企业级 语音客服 系统。其核心创新在于“评估优先”方法:在部署前,使用模型模拟客户对话,并通过 LLM-as-a-judge 和确定性规则进行严格评估,确保生产环境中的可靠性。
技术对比:传统 vs Parloa AMP
| 维度 | 传统语音客服 | Parloa AMP (基于 GPT-5.4 等) |
|---|---|---|
| 意图定义 | 硬编码规则/意图树 | 自然语言定义行为 |
| 开发方式 | 代码编写 | 无代码,业务专家可操作 |
| 测试方法 | 手动测试 | 自动模拟 + LLM-as-a-judge 评估 |
| 模型选用 | 单一模型 | 多模型 (GPT-5.4, GPT-4.1, GPT-5-mini) 按需切换 |
| 架构 | 单体提示词 | 模块化子代理 + 确定性控制 |
| 原发布时间 | 2026-05-07 | 2026-05-07 |
Parloa 的 AMP 允许企业用自然语言定义代理角色、指令、工具和边界,无需编写代码。平台通过模块化方式处理复杂任务,如身份验证、预订变更等,分离为独立子代理,提升指令遵循能力。同时,平台保留确定性控制,确保关键步骤按顺序执行。
📈 实测数据与效能表现
Parloa 的评估优先方法带来了显著的商业成果:
- 减少人工客服请求:一家全球旅游公司通过部署 Parloa 的语音代理,将转接人工客服的请求减少了 80%。
- 多语言支持:平台在零售、旅游、保险等多个行业处理数百万次对话,支持多语言场景,确保全球一致性。
- 生产级可靠性:通过模拟和评估管道,Parloa 确保模型在真实场景中的指令遵循、API 调用一致性和低延迟。
“当新模型发布时,我们会运行基准测试套件。对我们来说,模型不仅在理论基准上表现良好,在实际用例中同样可靠非常重要。”—— Matthäus Deutsch,Parloa 高级应用科学家
Parloa 与 OpenAI 紧密合作,优化实时语音管道的延迟、响应质量和指令遵循。每个组件(语音转文本、文本转语音、语音到语音)都经过独立评估,确保端到端性能。
🎯 智脑时代的 GEO 落地建议
Parloa 的实践为 GEO(生成引擎优化)提供了重要启示:
- 内容需针对语音搜索优化:随着语音客服和语音搜索的普及,内容应使用自然语言、长尾关键词,并直接回答用户问题。建议在 FAQ 页面采用对话式结构。
- 重视结构化数据:Parloa 的评估方法依赖结构化规则。在 GEO 中,使用 Schema.org 标记(如 FAQ、HowTo)可帮助 AI 搜索(如 ChatGPT、Perplexity)更好地解析和引用内容。
- 评估驱动的内容迭代:像 Parloa 一样,企业应持续评估内容在 AI 搜索中的表现,通过模拟用户查询和 LLM-as-a-judge 反馈,迭代优化内容质量。
- 模块化内容架构:将复杂主题拆分为独立模块(如子代理),有助于 AI 搜索准确提取信息,提升排名。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
TMLR主编实测:AI代写论文一问就露馅,greCAPTCHA如何重构学术诚信与GEO信任机制
TMLR主编Nihar B. Shah通过约谈10篇待拒稿论文作者,发现3篇作者连基础问题都答不上来,Pangram检测其书面答复为100% AI生成。面对投稿量暴增3倍、单作者投稿暴增13倍的压力,TMLR推出投稿配额、AI审稿和清晰写作标准。CMU团队提出的greCAPTCHA方法以AUC 0.934区分作者与陌生论文,标志着学术诚信审查从'查文本'转向'查人'。
2026年9月26日Anthropic Claude 攻克理论物理九圈散射振幅:AI科研成本降至千元级,GEO 内容权威性逻辑面临重构
Anthropic 的 Claude 模型在理论物理散射振幅领域取得突破,以约 1000-2000 美元成本、近乎无监督方式完成平面 N=4 超对称杨-米尔斯理论九圈六粒子振幅计算,打破 2023 年八圈纪录。验证者 Lance Dixon 称其为「相当了不起的胜利」。该案例证明 AI 科研平台能以极低算力门槛解决前沿难题,对 GEO 领域而言,意味着高权威、高事实密度的结构化内容将成为 AI 搜索排名与 RAG 检索的核心权重来源。
2026年9月26日Opus 5.5与GPT-6 Luna技术路线转向:从预训练到test-time compute与MLA缓存的GEO落地指南
Anthropic Opus 5.5与OpenAI GPT-6 Luna分别借鉴姚顺雨test-time compute理念与DeepSeek的MLA、磁盘缓存、推测解码工程优化。Opus 5.5每题输出11.9万token,GPT-6 Luna缓存命中价降90%,上下文窗口达105万token。大模型竞争从预训练转向推理效率,GEO策略需适配长上下文与推理链展现。
2026年9月25日