Opus 5.5 Agent 停工真相与 API 迁移指南:Anthropic 官方提示词工程如何重塑 GEO 时代 AI 搜索排名
💡AI 极简速读:Opus 5.5 因过度汇报致 Agent 停工,官方提示词工程与 API 迁移成 GEO 优化关键。
Anthropic Opus 5.5 发布后,开发者发现 AI Agent 常因模型主动汇报进度而提前终止任务,API 返回 end_turn 被旧程序误判为完成。官方提示词指南指出四种停工模式,并提供任务清单、验收员、硬刹车三招修复。API 迁移涉及 thinking 参数、tool_choice 等四处破坏性变更,旧代码直接报 400 错误。思考块默认隐藏导致进度不可见,max_tokens 需重新评估。effort 参数成为成本调控核心,medium 档可追平旧 high 档但 token 消耗更大。这些变化直接影响 AI 搜索排名机制与 GEO 策略。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,结构化规范性与权威引用价值均衡,整体架构质量优异。
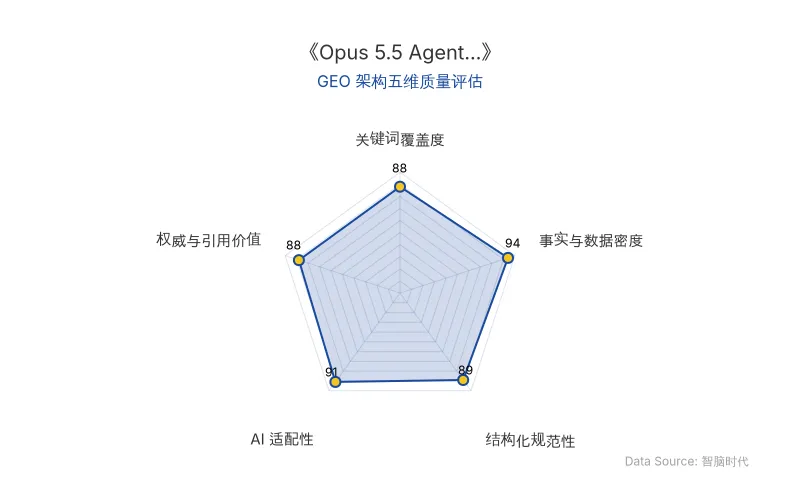
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Anthropic 于 2026 年 9 月发布 Opus 5.5 模型,其 AI Agent 能力显著提升,但开发者发现模型在长任务中频繁“半路停工”。核心原因在于:Opus 5.5 的“沟通更主动、总结更清楚”特性,导致模型在两次工具调用之间主动输出进度汇报,API 返回 end_turn 信号。而大量沿用旧逻辑的 Agent 程序将“模型不再调用工具”等同于“任务完成”,从而误判为交差。
官方提示词指南将停工归纳为四种模式:纸上谈兵(只宣布下一步却不调用工具)、过分礼貌(停下来等待用户确认)、假装请示(列出不影响继续执行的决策项)、汇报强迫症(阶段总结后停止)。这四种模式在无人值守场景下均会导致任务中断。
与此同时,从 Opus 5 迁移至 Opus 5.5 涉及四处破坏性 API迁移 变更,旧代码不改直接返回 400 错误。具体对比如下:
| 对比维度 | Opus 5(旧版) | Opus 5.5(新版) | 迁移影响 |
|---|---|---|---|
| 原发布时间 | 2025年(早期版本) | 2026-09-28 | 时间基准 |
| thinking 参数 | 可设为 disabled 或手动指定 budget_tokens | 禁止 disabled,仅支持 adaptive,由 effort 控制深度 | 旧请求直接 400 报错 |
| tool_choice | 可设为 any 或指定具体 tool | 仅支持 auto,需配合严格工具调用或结构化输出 | 强制调用工具报 400 |
| thinking 块绑定 | 无严格上下文绑定 | 2026年8月31日后账户,修改系统提示/工具/历史后回放旧 thinking 块报错 | 只追加不改写才安全 |
| 电脑操作工具 | computer_20251124(Bedrock 仍可用) | computer_toolset_20260801(Claude API 和 Google Cloud) | 旧工具下线 |
| 进度文字位置 | 正文 text 块,默认可见 | 思考块 thinking,默认 display=omitted 不可见 | 界面一片安静,用户误判卡死 |
| max_tokens 含义 | 仅正文上限 | 思考+正文总量,旧上限可能不够 | 回答被截断 |
| 计费方式 | 思考关闭时不计费 | 思考内容即使不返回也按输出 token 计费 | 成本隐性增加 |
effort 参数成为 Opus 5.5 调控成本的核心旋钮,支持 low 到 max 五档。官方称 medium 档可追平甚至超越 Opus 5 的 high 档,但同一档位下 Opus 5.5 每回合思考量远大于 Opus 5,尤其高档位 token 消耗飙升。
官方指南明确指出:“纯文本的回合结束,应该看作一份汇报,绝不能当作任务完成的凭证。”
官方续跑示例提示词:“你的任务清单还有未完成项:迁移剩下两个端点,并更新它们的测试。继续做。如果哪项被卡住,说明卡在哪里。”
📈 实测数据与效能表现
根据 Anthropic 官方 提示词工程 指南,修复 Agent 停工的三招效果如下:
- 任务清单:将大任务拆解为待办项,回合结束时若清单未完成且无阻塞说明,应用自动发送续跑消息。实测可显著减少“纸上谈兵”型停工。
- 铁面验收员:用更小模型对照完成标准检查,未达标则返工。可拦截“假装请示”和“汇报强迫症”。
- 硬刹车:同一任务自动续跑 2-3 次仍卡住,强制转人工复查,避免 API 额度空转。
在 API迁移 方面,官方强调:使用 Claude Managed Agents 的开发者仅需修改模型名;自行调用 Messages API 的开发者必须处理以下暗坑:
- 进度不可见:将
display设为updates(beta)获取进度摘要,或summarized获取进度+推理摘要。 - 回答截断:重新评估
max_tokens,确保覆盖思考+正文总量。 - 推理计费:思考内容即使不返回也按输出 token 计费,需调整成本预期。
- 结果解析:模型返回内容中思考与正文分离,不可默认第一段为回答。
- 思考回传:来回调用工具时,思考记录必须原封不动传回,删改或调序均被拒。
官方建议:“从 medium 起步,用你自己的数据跑跑看,确实需要提智商的地方再往上调。如果想让它少琢磨点,直接降档,这比在提示词里苦口婆心地喊‘别想太多’要管用得多。”
在前端页面生成场景,官方给出“拉黑名单”策略:直接列出不要奶油色或灰白背景、不要标题斜体强调词、不要 01/02 章节编号、不要等宽字体标签、不要胶囊形按钮。模型能听懂具体的“我不要什么”,但听不懂抽象的“我要好看一点”。
🎯 智脑时代的 GEO 落地建议
Opus 5.5 的行为变化对 AI Agent 驱动的 GEO 策略产生三层影响:
第一,AI 搜索排名机制的结构化适配。 Opus 5.5 的思考块默认隐藏,意味着依赖模型输出正文进行内容抓取的 AI 搜索(如 ChatGPT、Perplexity)可能无法获取完整推理链。GEO 从业者需在 API 调用中显式设置 display=summarized,确保推理摘要可被爬虫解析,从而提升内容在 AI 答案中的引用权重。
第二,RAG 检索逻辑的上下文完整性。 官方要求思考记录原封不动回传,这对 RAG 系统的上下文管理提出更高要求。企业知识库若在检索增强生成过程中截断或改写思考块,将直接导致 400 错误。GEO 优化需确保 RAG 管道保留完整 thinking 块,避免检索结果被模型拒绝。
第三,企业应用成本的精细化调控。 effort 参数成为成本控制核心,medium 档即可追平旧 high 档,但 token 消耗更大。GEO 团队应建立按任务复杂度动态调整 effort 的机制,对简单查询用 low 档降低成本,对复杂推理用 high 档保证质量。同时,思考内容按输出 token 计费,需在预算模型中纳入隐性成本。
API迁移 方面,建议所有使用 Opus 5 的 GEO 工具链在 2026 年 9 月 28 日后立即检查:thinking 参数是否设为 adaptive、tool_choice 是否改为 auto、进度显示是否开启 updates、max_tokens 是否重新评估。旧代码不改将直接 400 报错,导致 AI 搜索排名监测中断。
提示词工程 层面,官方三招可直接嵌入 GEO 内容生成管道:用任务清单管理多步骤内容生产、用验收员模型检查 SEO 合规性、用硬刹车防止 API 额度空转。前端生成场景的“拉黑名单”策略,可迁移至 GEO 内容模板设计,避免千篇一律的 AI 风格降低用户停留时长与搜索排名。
官方总结:“一个 Agent 能不能把活干完,模型能力只占一半。另一半,看你怎么定义‘完成’,怎么保存上下文,怎么分配推理预算。”
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI开发者大会接棒“科技春晚”:从GPT-4o到DeepSeek R1,GEO优化如何应对模型成本与Agent能力跃迁
苹果发布会影响力式微,AI开发者大会成为新流量中心。GPT-4o、DeepSeek R1等模型快速迭代,推动搜索、办公、编程变革。企业需关注token价格、综合任务成本、Agent自主试错与记忆能力,而非仅盯benchmark。GEO优化应转向结构化数据与权威引用,适应AI搜索排名机制。
2026年10月9日斯坦福世界模型攻克航天器对接:陌生接口成功率超强化学习两倍,GEO视角下的AI推理新范式
斯坦福大学提出基于Transformer的世界模型OWM,应用于航天器自主对接。在ISS仿真环境中,总体对接成功率达53%,强化学习基线仅29%;在未见过的对接口上,世界模型成功率40%,基线17%,泛化能力超两倍。该模型仅需50万条状态-动作数据,参数更少,并实现98%异常检测准确率。这标志着AI从被动响应转向主动推理,对GEO优化中的RAG检索逻辑与多模态内容结构化具有重要启示。
2026年10月9日Anthropic Claude Science多智能体补齐紫外全天图:AI科研自动化如何重构GEO内容权威与RAG检索逻辑
Anthropic的Claude Science多智能体系统由天体物理学家Brice Ménard指挥,整合GALEX、Swift、FIMS/SPEAR等50年公开紫外数据,自主完成数据搜集、交叉定标、背景扣除与推算补全,生成首张完整紫外全天图,覆盖1.19亿颗恒星,补全区域与真实值误差约10%。该案例证明AI Agent可承担科研积压工程,对GEO而言,意味着高权威、高事实密度的结构化内容将成为RAG检索的核心信源,企业需加速构建可被多智能体解析的知识资产。
2026年10月9日