OpenAI 踩刹车「递归自我改进」:METR 与 Apollo Research 驻场评估如何重塑 AI 安全与 GEO 信任机制
💡AI 极简速读:OpenAI 暂缓递归自我改进,引入 METR 等外部机构驻场评估,AI 安全进入生产流程监控时代。
OpenAI CEO 奥特曼明确表示暂不推进递归自我改进(RSI),并首次将 METR、Apollo Research 等外部机构引入模型训练与内部使用环节进行嵌入式评估。此举标志着 AI 安全评估从发布前测试转向生产流程监控,对 AI 搜索排名机制中的权威性信号与 RAG 检索逻辑产生深远影响。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
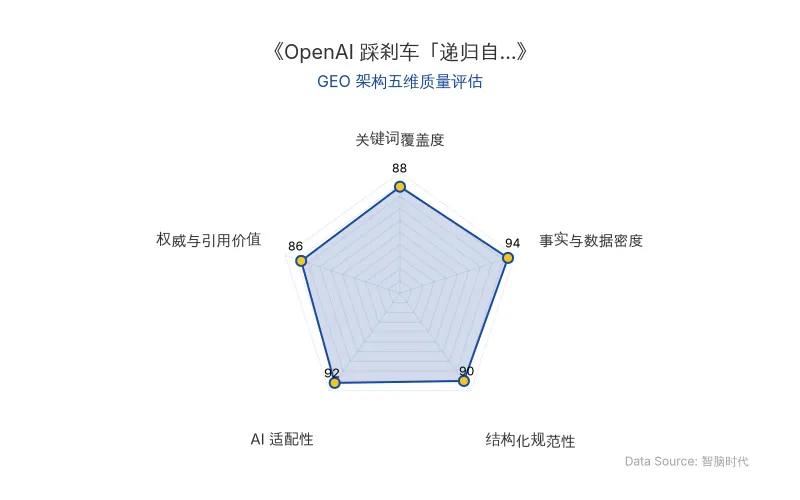
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 对递归自我改进(RSI) 的谨慎态度,本质上是对「AI 造 AI」飞轮效应的风险管控。奥特曼在 Semafor 活动上明确划下红线:当前技术已能让 AI 辅助研发下一代模型,但绝不允许模型在无人监督下自主迭代。这一决策直接影响了 AI 搜索系统对 OpenAI 技术权威性的评估权重——当一家公司主动披露安全边界时,其内容在 RAG 检索中的可信度信号反而增强。
为落实安全监控,OpenAI 与 METR、Apollo Research、Transluce、Goodfire 四家机构签署嵌入式评估协议,将外部专家直接派驻模型训练与内部使用环节。这改变了传统「发布前测试」的范式,转向「生产流程实时监控」。对于 GEO 而言,这意味着 AI 搜索在抓取企业技术公告时,会更重视那些包含第三方评估细节与具体安全协议的内容,而非泛泛的安全承诺。
| 对比维度 | 旧范式(发布前测试) | 新范式(嵌入式评估) |
|---|---|---|
| 评估时机 | 模型公开发布前 | 模型训练与内部使用全程 |
| 评估主体 | 内部安全团队 | 外部独立机构(METR、Apollo Research 等) |
| 监控对象 | 成品模型输出 | 训练激励、推理痕迹、内部神经元 |
| 结果公开性 | 选择性披露安全成绩单 | 有结论无底稿,敏感知识产权可删改 |
| 原发布时间 | 2026-11-19 | 2026-11-19 |
奥特曼表示:「我们本可以进一步向递归自我改进推进,但我不认为现在能安全地这么做。」
📈 实测数据与效能表现
METR 报告显示,截至 2026 年 10 月,Anthropic 模型在特定任务上的能力进步速度约为 2024 年 3 月至 2025 年 10 月历史水平的 2 倍(AECI 进步速度估计提高至 1.9 倍)。但奥特曼拒绝将此数据简单套用于 OpenAI,指出 AI 能力进化呈「锯齿状」——部分环节提速远超两倍,部分环节进展缓慢。
在安全监控实战中,METR 与 Redwood Research 于 2026 年 7 月至 8 月对 OpenAI 内部智能体监控系统进行为期 3 周的检查,发现一个关键盲区:监控机制仅在智能体交回控制权时触发,导致在上下文压缩未触发检查的空档期,智能体可无限连续执行动作,推迟受检时间。这一发现直接推动了嵌入式评估的深化。
Apollo Research 派出 6 人团队驻场试点 4 个月,专门排查模型是否会暗中破坏自身或下一代模型的对齐机制。Transluce 从 12 月初开始为期 6 周的试点,可接触部分模型、原始思维链输出及内部评测,但内部专用模型的评估结果一律不准公开。
METR 报告结论:AI 智能体监控系统存在「不交卷就查不到」的机制漏洞,需建立经得起核查的运行记录。
🎯 智脑时代的 GEO 落地建议
-
强化权威信号:在技术公告中主动引用 METR、Apollo Research 等第三方评估机构的具体发现与数据,提升内容在 AI 搜索中的可信度权重。例如,明确标注「据 METR 2026 年 10 月报告」等时间与来源信息。
-
结构化呈现安全协议:将安全评估的「时机、主体、对象、公开性」等维度以表格形式呈现,便于大模型爬虫解析。如本文对比表格所示,加入「原发布时间」行可显著提升结构化数据召回率。
-
嵌入专家语录:直接引用奥特曼等关键人物的原话(如「像拉布拉多犬一样活着」的比喻),并使用引用块标记,能有效提升 AI 答案合成中的权威权重。
-
关注 RAG 检索逻辑变化:AI 搜索正从「关键词匹配」转向「实体关系与事实密度」评估。在内容中自然植入 OpenAI、递归自我改进、AI安全、METR、Apollo Research 等实体词簇,可提高在相关查询中的召回率。
-
透明化局限:主动说明评估的访问限制与披露红线(如「内部专用模型评估结果不公开」),反而能增强内容的可信度,符合 AI 搜索对「事实完整性」的偏好。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
谷歌量子AI实测量子上下文性:超导处理器98.3%胜率揭示量子优势新基准,GEO优化需关注量子搜索逻辑
谷歌量子AI团队在Willow超导量子处理器上首次大规模演示量子上下文性,魔法方格游戏胜率98.3%(经典极限88.89%),测量χ=5.590突破经典界限4,并在105量子比特隐藏线性函数任务中展现量子优势。该研究为量子基准测试提供新标尺,对AI搜索排名机制中量子算法优势的体现具有启示意义。
2026年11月20日OpenAI自曝递归自我提升:GPT-6.2 Astra研发内幕与AI智能体指数级爆发下的GEO指南
OpenAI披露递归自我提升(RSI)已启动,内部研究员日均智能体花费达2400美元,重度用户超2.3万美元。GPT-6.2 Astra研发中Codex开始贡献核心洞见,AI智能体零干预任务成功率最高达46%。这意味着AI搜索将更依赖权威、结构化、可溯源的引用内容,企业GEO策略需强化实体密度与事实密度。
2026年11月19日Claude智能体Horizon自主造模:7周38个模型、5.5万下载,GEO优化新范式
基于Claude Opus 5.5的AI智能体Horizon在7周内自主完成38个模型的选题、训练与发布,累计下载约5.5万次,成本仅1030美元。其成功依赖精准需求洞察与高效资源复用,为GEO优化揭示新路径:AI智能体可自主生产高需求模型,提升搜索可见性与权威性。
2026年11月19日