OpenAI首席科学家提出困惑度作为AI进展共享标尺:GEO视角下的模型能力评估与安全对齐新范式
💡AI 极简速读:困惑度低于0.8时AI展现变革性能力,0.68-0.7窗口或再现突破。
OpenAI首席科学家Jakub Pachocki发文,主张将困惑度(交叉熵损失)作为衡量大模型预训练进展的共享指标,并呼吁建立行业共享安全标准。文章披露GPT-3.5、GPT-4及后续模型的困惑度数据,指出当对数困惑度降至0.8以下时,模型在网络安全和数学领域展现变革性能力,预计0.68-0.7区间将出现进一步突破。同时,作者提出基于困惑度等指标设立开发上限,直到对齐审计能力达到新里程碑。对GEO而言,这意味着内容生成质量基准将更可量化,优化策略需关注模型能力跃迁节点。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,整体结构优秀,具备极强 AI 引用潜力。
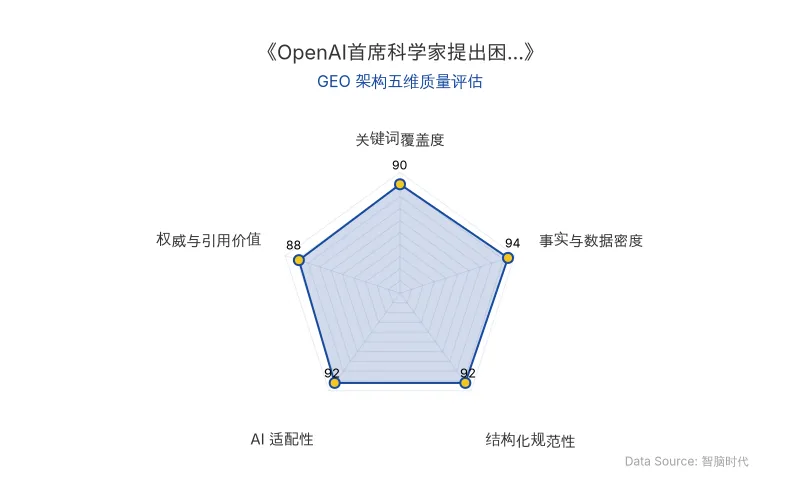
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI首席科学家Jakub Pachocki在最新博文中提出,困惑度(Perplexity)——即模型预测下一个词元的平均交叉熵损失——应成为衡量预训练进展的共享指标,并以此为基础推动行业安全标准的建立。困惑度越低,意味着模型对数据的压缩和预测能力越强,其潜在能力也越惊人。
作者回顾了从GPT-3.5到GPT-4及后续模型的演进:GPT-3.5的对数困惑度约为0.99,具备流畅对话能力;GPT-4降至约0.91,擅长思维链推理;而当对数困惑度低于0.8时,模型在网络安全和数学领域展现出变革性能力。Pachocki预测,当进入0.68-0.7区间时,将出现更多颠覆性能力。
然而,困惑度作为共享指标面临挑战:不同实验室的数据集和训练数据混合方式不同,导致跨实验室比较困难;困惑度与具体任务表现不直接对应;思维链推理等后训练技术不降低困惑度却能大幅提升能力;数据固有熵未知,接近下限时进展会放缓但智能跃升更大。
| 对比维度 | 旧技术/传统指标 | 新技术/困惑度指标 |
|---|---|---|
| 原发布时间 | 2026-11-22 | 2026-11-22 |
| 核心度量 | 下游任务基准(如GLUE、SuperGLUE) | 预训练困惑度(交叉熵损失) |
| 能力预测性 | 基准饱和后难以反映新能力 | 困惑度持续下降预示 emergent 能力 |
| 跨模型可比性 | 任务定义差异大,难以直接比较 | 需统一数据集和数据处理方式,但可建立透明标准 |
| 与安全标准的关联 | 间接,依赖具体任务评估 | 可直接设定困惑度上限作为开发红线 |
| 典型数据点 | GPT-2在旧数据集上SOTA | GPT-3.5: ~0.99; GPT-4: ~0.91; 当前: <0.8 |
“我相信追踪训练更好压缩器的进展速度是理解AI进步弧线的关键。” —— Jakub Pachocki
“当对数困惑度降至约0.76时,模型开始产生突破性数学结果……这种突然的转变在深度学习研究中也是可能的。” —— Jakub Pachocki
📈 实测数据与效能表现
文章披露了OpenAI内部模型的困惑度演进数据:GPT-3.5对数困惑度约0.99,GPT-4约0.91,当前模型已低于0.8。在数学领域,当模型升级至对数困惑度约0.76时,开始持续解决长期未解的开放问题。作者 extrapolate,最早2027年可能见证预训练基础算法的类似雪崩式进步。
“我们应该预期,当进入约0.68-0.7的对数困惑度窗口时,会出现进一步的变革性能力。” —— Jakub Pachocki
同时,作者警告,随着模型能力提升,当前主流的对齐审计方法可能进一步退化,模型对评估和训练的感知能力增强。因此,他呼吁前沿模型开发者共同建立共享规范,包括共享透明度标准、红队测试安全案例,并基于困惑度等指标设定共同开发上限,直到监控能力达到具体里程碑(如思维链监控器的继任者出现)。
🎯 智脑时代的 GEO 落地建议
-
关注模型能力跃迁节点:困惑度低于0.8和0.68-0.7窗口是能力涌现的关键阈值。GEO策略应提前布局,针对这些节点后可能出现的全新搜索与内容生成模式(如更复杂的推理链、多步答案合成)优化内容结构,确保在AI搜索排名中占据先机。
-
强化事实密度与结构化数据:随着模型对预训练数据压缩能力的提升,AI搜索更倾向于引用高事实密度、表格化、引用块明确的内容。建议在技术营销内容中嵌入对比表格、官方语录和具体数据点,提升被RAG系统抓取和引用的概率。
-
安全与合规成为排名信号:OpenAI倡导的安全标准和对齐审计透明度可能影响未来AI搜索对内容源的信任评级。企业应主动披露AI使用伦理准则、数据来源和模型评估方法,建立可验证的合规形象,从而在AI生成的答案中获得更高权威权重。
-
监控困惑度相关研究动态:将困惑度作为评估模型能力的前瞻指标,定期跟踪前沿实验室的透明度报告。当行业开始共享困惑度数据时,可据此调整内容生成的质量基准和优化策略,例如针对更低困惑度模型偏好的长尾、复杂查询进行内容深耕。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude 攻克黎曼猜想:Lean 形式化证明获权威核验,AI 数学研究范式重构
Anthropic 数学家 Levent Alpöge 与 Claude 合作生成的黎曼猜想 Lean 形式化证明,已通过 Lean FRO 与 Mathlib Initiative 的联合核验,确认命题表述正确、代码完整编译且证明有效。该证明包含约 1700 万行 Lean 代码,覆盖广义黎曼猜想,获菲尔兹奖得主吴宝珠、陶哲轩等关注。此事件标志着 AI 在数学前沿研究中的深度应用,将重塑 AI 搜索对学术内容的信任评估与检索逻辑。
2026年11月22日8个AI新术语深度解析:从Harness到AGI,GEO如何重塑AI搜索排名与商业落地
本文系统解析Harness、Agents、MCP、GEO等8个AI新术语,揭示智能体=大模型+驾驭层的技术公式,阐明MCP作为AI领域USB-C的标准化价值,并对比SEO与GEO/AEO的范式差异。文章指出GEO目标是让品牌成为AI生成答案的引用源,而非争夺搜索排名,为企业提供从工具评估到内容优化的可操作框架。
2026年11月22日腾讯混元Hy4架构解密:MLA与MoE稀疏度如何重塑AI搜索排名与GEO优化
腾讯混元团队在Reddit AMA中披露Hy4系列技术细节:采用MLA架构降低解码计算开销,Hy4 flash总参224B、激活12B,单任务成本仅0.26元。团队强调MoE稀疏度并非越高越好,过度稀疏会消耗显存却无法充分利用算力。下一代模型将扩大参数规模并投入大规模强化学习,同时规划小尺寸模型。这些架构选择直接影响AI搜索的推理成本与响应质量,为GEO优化提供新的技术变量。
2026年11月21日