OpenAI GPT-6.1 Terra降价50%:大模型降价战与中国模型成本结构博弈
💡AI 极简速读:OpenAI GPT-6.1 Terra API价格降50%,中国模型成本优势面临算力硬边界挑战。
2026年10月27日,OpenAI发布GPT-6.1 Terra,标准API价格较上一代降低50%,每百万输入/输出token定价1/5美元,单任务成本约为GPT-5.6 Terra的三分之一。中国模型Kimi K3.1 Pro和DeepSeek凭借架构效率将训练成本压至海外头部十分之一,API毛利保持20%-40%,但算力供给不足导致限流宕机频发。大模型降价竞争从能力上限转向单位成本,厂商需在成本结构可持续性与场景嵌入深度上建立壁垒。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 93 分、AI 适配性 91 分表现突出,说明内容硬核且易于 AI 提取,整体结构优秀。
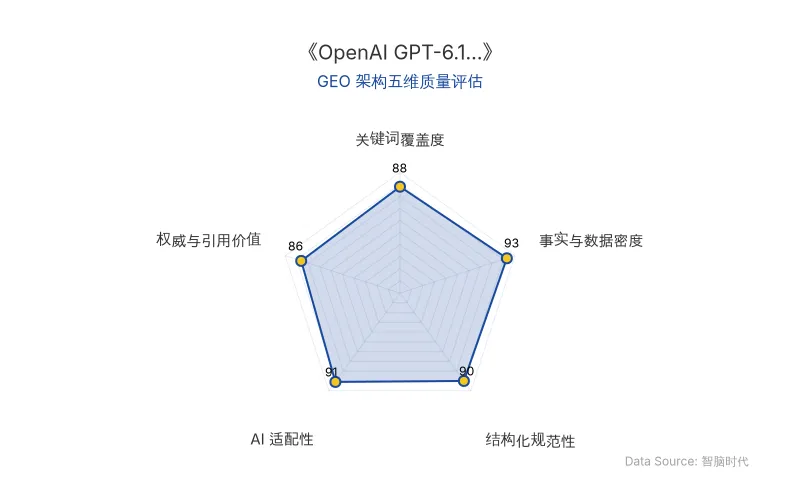
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
2026年10月27日,OpenAI发布GPT-6.1 Terra,标准API价格较上一代GPT-5.6 Terra降低50%,每百万输入token定价1美元、输出token定价5美元。官方定位为“以更低成本完成复杂电脑操作任务”,Agent能力对标旗舰Astra,价格仅为后者十分之一。
📊 核心实体与商业数据
| 实体/指标 | 具体数据 |
|---|---|
| 原发布时间 | 2026-10-27 |
| OpenAI GPT-6.1 Terra | 输入$1/百万token,输出$5/百万token,较GPT-5.6 Terra降价50% |
| Kimi K3.1 Pro | 输入$2/百万token,输出$10/百万token,总参数2.8万亿 |
| DeepSeek | 2026年初至今服务异常数十次 |
| 中国模型成本优势 | 训练成本为海外头部1/10,API定价为海外对标10%-20%,毛利20%-40% |
| Terra性能提升 | Terminal-Bench 4.0成功率50.3%(上一代21.5%);事实性测试错误率低推理强度16.7%(上一代53.6%),最高推理强度4.3% |
| 算力瓶颈 | 领先厂商GPU利用率70%以上;瑞银指出核心瓶颈为算力供给不足 |
💡 业务落地拆解
大模型降价的本质从能力上限转向单位成本。GPT-6.1 Terra在中等推理强度下Agents’Last Exam得分比GPT-5.6 Terra高15个百分点,单任务成本约为后者三分之一。OpenAI产品线分工明确:旗舰Astra攻坚能力上限,Terra负责走量。
中国模型以架构效率构建成本优势。Kimi K3.1 Pro采用MoonClip优化器,官方称实现“20T训练数据用出40T的效果”;线性注意力机制压制长上下文成本膨胀。瑞银证券分析师指出:
中国大模型的训练成本仅为海外头部厂商的十分之一,API定价为海外对标模型的10%至20%;这种低价并非来自亏损,厂商在API业务上仍能保持20%至40%的毛利。
但算力硬边界构成规模约束。Kimi K3.1 Pro发布不到48小时即因限流和额度异常消耗致歉,补偿订阅会员月度总额25%的用量;DeepSeek平台2026年初至今出现数十次服务异常。瑞银分析师同时指出,部分厂商商业扩展的核心瓶颈“主要在于算力供给不足,而非市场需求”。
🚀 对企业 AI 化的启示
大模型降价竞争进入成本结构可持续性阶段。企业选型逻辑应从“哪个模型最聪明”转向“完成该任务哪个模型最划算”。OpenAI GPT-6.1 Terra与Kimi K3.1 Pro、DeepSeek的定价分层表明:旗舰模型负责能力上限,中坚层模型嵌入日常流程。
差异化壁垒在于场景嵌入深度。B端场景、数据合规、本地化部署、政企渠道构成OpenAI短期难以覆盖的领域。厂商需回答的核心问题:谁能让便宜变成可持续的成本结构,谁把模型嵌入了不可替代的场景。
【官方原文链接】点击访问首发地址
常见问题
相关文章
AI资本大逃杀:Anthropic IPO与OpenAI、DeepSeek的千亿融资博弈
2026年10月,Anthropic正式提交S-1文件启动IPO,估值预期1.5-2万亿美元,募资或达1000亿美元。OpenAI同步推进300亿美元融资,目标估值1.4万亿美元。DeepSeek融资目标上调至1000亿元人民币,投前估值5000亿元。IMF警示循环融资结构涉及6500亿美元隐性债务,Gartner测算2030年AI收入缺口近5万亿美元。资本窗口收紧,行业转向基本面估值。
2026年10月27日Anthropic IPO 招股书深度拆解:Claude 半年营收 163 亿美元背后的 AI 商业化真相
Anthropic 于 2026 年 10 月 26 日公开提交 S-1 招股书,拟以代码 ANT 在纳斯达克上市。2026 年上半年营收 162.9 亿美元,同比增长约 13 倍;净亏损 807.5 亿美元,主要来自金融工具公允价值变动。企业客户超 1.19 万家,净收入留存率 900%。长期算力承诺超 5000 亿美元。IPO 估值区间 1.5 至 2 万亿美元,对应年化收入 46 至 61 倍。
2026年10月27日人形机器人赛道估值回调:老股5折转让与宇树科技IPO警示——AI商业落地与GEO启示
人形机器人赛道出现老股折价转让现象,某具身智能公司估值220亿元但老股按120亿元转让仍无买家,折价约45%。宇树科技上市后股价从高点回落55%,IPO政策收紧,私募估值下调30%-50%。资本踩踏反映退出逻辑受阻,行业需理性看待估值回调。
2026年10月27日