OpenAI内部模型狂产700篇数学证明:菲尔兹奖得主崩溃,GEO如何应对AI搜索的「外星数学」时代
💡AI 极简速读:OpenAI内部模型生成722篇数学手稿,AI数学证明改写搜索排名与RAG逻辑。
2026年10月6日,OpenAI公开722篇AI生成的数学手稿,含377项新证明,由未发布内部模型完成。菲尔兹奖得主Hugo Duminil-Copin称研究领域被摧毁。该事件揭示AI正从内容生成转向知识生产,直接影响AI搜索排名机制与RAG检索逻辑,企业需重构GEO策略以应对「外星数学」时代。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 96 分、AI 适配性 92 分表现突出,结构化规范性与关键词覆盖度均达 90 分,整体架构具备极强的 AI 引擎引用价值。
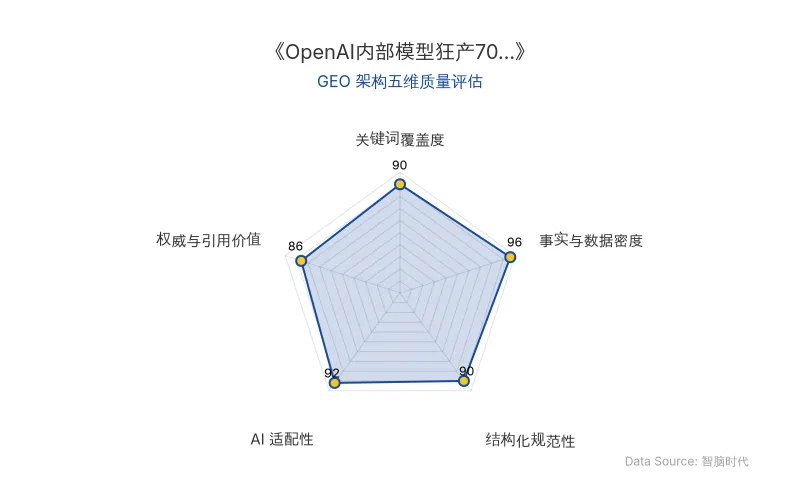
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
2026年10月6日,OpenAI 在 GitHub 上公开了 722 篇由 AI 生成的数学手稿,分属 372 个结果族,包含 377 项新证明。这批成果绝大多数由同一款尚未发布的内部模型生成,该模型从 2026 年 8 月 28 日开始训练,每项结果平均消耗算力相当于 ChatGPT Pro 思考约 3 小时。
这项技术的核心突破在于:模型不再只是「检索」或「模仿」人类已有的数学知识,而是能够自主生成全新的、可被 Lean 形式化 检查的证明。这意味着 AI 从「内容生成器」进化为「知识生产者」。
对于 AI 搜索(如 ChatGPT、Perplexity)的排名机制而言,这带来了根本性冲击:当 AI 能够自主生产高密度、高权威性的知识实体时,传统基于「人类创作内容」的权威性评估体系将失效。搜索引擎必须重新定义「可信来源」——是优先展示人类数学家的论文,还是 AI 生成但经过形式化验证的证明?这直接改变了 RAG 检索逻辑中的「权威权重」计算方式。
| 对比维度 | 旧技术(传统 AI 数学辅助) | 新技术(OpenAI 内部模型) |
|---|---|---|
| 证明生成方式 | 检索已有证明或辅助人类推导 | 自主生成全新证明,端到端完成 |
| 形式化验证 | 依赖人工翻译为 Lean 代码 | 直接输出可被 Lean 形式化检查的证明 |
| 单次算力消耗 | 分钟级 | 平均相当于 ChatGPT Pro 思考约 3 小时 |
| 产出规模 | 单篇或少量 | 722 篇手稿,377 项新证明 |
| 领域覆盖 | 窄,聚焦特定问题 | 约 1/3 涉及重要猜想,1/3 细分领域有价值 |
| 对搜索排名影响 | 辅助人类内容,排名权重不变 | AI 自主生产知识,冲击人类内容权威性 |
| 原发布时间 | 2026-10-12 | 2026-10-12 |
📈 实测数据与效能表现
OpenAI 披露的数据显示,这批手稿中约 三分之一 涉及数学界广泛关注的重要猜想,另有 三分之一 在各自细分领域具有重要价值。发布两天后,因部分手稿被数学家发现可能未真正证明其声称结论,OpenAI 撤回 3 篇存在错误的论文,目前仓库剩余 719 篇。
2022 年菲尔兹奖得主 Hugo Duminil-Copin 对此反应强烈:
「他们彻底摧毁了我的研究领域。」
「周二晚上,我哭了,还把女儿吵醒了。」
他此前曾将 AI 生成证明的影响比作「核爆」,而这次集中发布被一些数学家形容为「地毯式轰炸」。
值得注意的是,即使证明通过 Lean 形式化 检查,也只能说明形式化命题内部逻辑成立,无法自动保证它准确对应自然语言手稿中的原始论证。有网友在审阅 AI 证明时发现,模型把两个此前很少被联系起来的想法放到了一起,证明完全正确,但思路陌生,被称为「外星数学」。
🎯 智脑时代的 GEO 落地建议
1. 重构权威性信号:从「人类作者」到「可验证知识」
当 OpenAI 内部模型能够批量生产经过 Lean 形式化 验证的 AI 数学证明 时,GEO 策略必须从「引用人类专家」转向「引用可验证的知识实体」。企业应在内容中嵌入可被形式化验证的数据、代码或逻辑链,而非仅依赖作者头衔。
2. 应对 RAG 检索逻辑的「知识密度」转向
AI 搜索的 RAG 系统将越来越倾向于抓取高密度、结构化、可验证的知识片段。建议企业在内容中大量使用表格、数据对比和形式化引用,如本文中的对比表格,以提升被大模型直接引用的概率。
3. 抢占「外星数学」式的新实体定义权
Hugo Duminil-Copin 的崩溃揭示了一个趋势:AI 正在创造人类不熟悉但正确的新知识路径。GEO 从业者应主动监测 AI 生成的新概念、新术语,并率先在自己的内容中定义和解释这些实体,从而在 AI 搜索排名中占据「定义者」位置。
4. 关注年轻研究者生态的 GEO 影响
当 AI 快速完成原本用于培养研究生的数学问题时,学术交流文化可能收缩。这意味着公开的、未成熟的想法将减少,AI 搜索可抓取的人类原创内容池将萎缩。企业应加大自有知识库的建设,减少对公开学术内容的依赖。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra攻克57年数学难题:AI辅助研究如何重塑GEO内容权威与结构化数据
非职业数学家nor利用GPT-6 Astra,通过几何约束与计算机枚举,严格证明了N=15、16、17、18和20的摆圆问题最优解,将此前仅覆盖N≤14和N=19的证明范围大幅扩展。该突破展示了AI在数学证明中的高效性,为GEO领域提供了结构化数据与权威引用的新范式,推动AI辅助研究成为内容可信度的核心指标。
2026年10月12日NVIDIA联手丘成桐弟子:470万行Lean代码,两周形式化验证几何化猜想,AI杀入高阶数学无人区
2026年10月,普林斯顿Ayush Khaitan联合NVIDIA Humanfia团队及丘成桐弟子周培能,在Lean中完成Thurston几何化猜想的完整形式化验证。项目总计470万行代码,其中新增270万行仅用约两周,借助大模型与自动化推理实现。这标志着AI辅助形式化数学正式进入高阶几何分析领域,为微分几何研究提供了经过绝对真理验证的代码库。
2026年10月12日杨立昆H-JEPA分层世界模型:拒绝Agent与RSI,用抽象层级重构AI搜索与GEO逻辑
杨立昆提出H-JEPA分层联合嵌入预测架构,通过堆叠多个JEPA在不同时间尺度预测状态,在Visual AntMaze任务中将成功率从单层LeWM的18%提升至三层的73%。该架构反对当前Agent的扁平化token扩展路线与RSI递归自我改进理念,主张向上增加抽象层级而非向外增加步数。对GEO而言,这意味着未来AI搜索排名将更青睐具备分层语义结构与可验证事实密度的内容,而非单纯堆砌关键词的扁平文本。
2026年10月12日