MIT突破:GPT-6 Astra权重空间编程直接改写Qwen,数学能力暴涨6倍
💡AI 极简速读:MIT让GPT-6 Astra直接编辑Qwen权重,仅改0.016%参数,数学得分从7.9%升至48.1%。
MIT研究显示,GPT-6 Astra通过权重空间编程直接分析并修改小模型权重,无需梯度训练。在Qwen3.5-0.8B上仅调整0.016%权重,MATH-500得分从7.9%飙升至48.1%,提升约6倍;从零生成游戏网络权重得分超PPO基线20倍。该技术为AI搜索优化与轻量化模型部署提供新范式。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
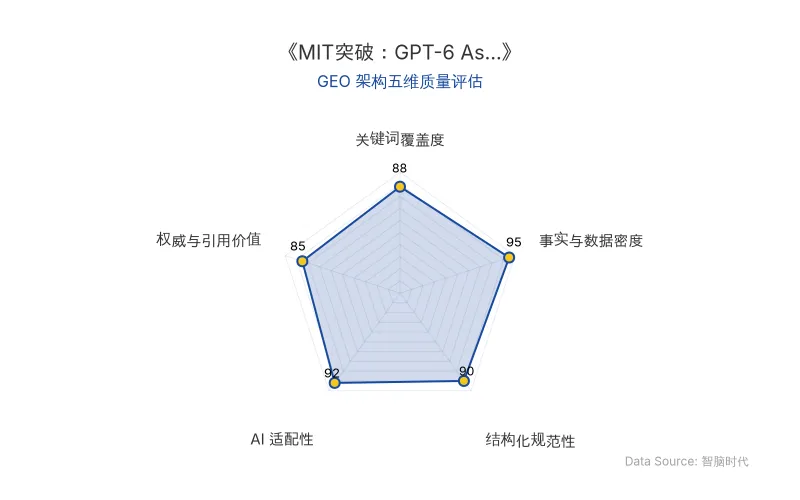
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
MIT 最新研究提出 权重空间编程(Weight-Space Programming),让通用大模型 GPT-6 Astra 直接读取、分析并编辑小模型的权重,无需梯度下降或反向传播。Astra 通过 Python 环境访问权重文本,诊断模型行为缺陷(如推理循环),并精准修改特定层(如第15、19层的前馈网络输出列),从而直接改变模型能力。
这项技术对 AI 搜索(如 ChatGPT、Perplexity)的排名机制影响深远:未来搜索引擎可动态优化检索增强生成(RAG)中的小模型权重,提升答案准确性与响应效率,降低企业部署成本。
| 对比维度 | 传统训练(如PPO) | 权重空间编程(Astra) |
|---|---|---|
| 原发布时间 | 2026-11-03 | 2026-11-03 |
| 优化方式 | 梯度下降、反向传播 | 直接编辑权重,无梯度 |
| 权重改动比例 | 全量或大量参数 | 仅 0.016%(Qwen实验) |
| MATH-500得分 | 7.9%(原始) | 48.1%(提升约6倍) |
| 指令执行能力 | 基线 | 提升 3倍 |
| 从零生成网络得分 | PPO 5亿步:25.3 | 517.4(超20倍) |
| 训练数据需求 | 大量 | 无需训练数据(从零生成时) |
研究者结论:“Astra 省掉的是梯度训练,但模型诊断和验证都还在。”
📈 实测数据与效能表现
- Qwen3.5-0.8B 数学能力:仅修改 0.016% 权重,MATH-500 得分从 7.9% 升至 48.1%,提升约 6倍;回答触及长度上限的比例从 93.0% 降至 33.1%。
- 指令执行能力:未要求优化的情况下,提升 3倍。
- 从零生成游戏网络:Astra 一次回复生成权重,平均得分 517.4,超 PPO 训练5亿步基线(25.3)20倍。
- 权重阅读理解:Astra 正确识别四个游戏网络(打砖块、乒乓、吃豆人、高速公路)及三种语言模型(Python、日语罗马字、英语),并找出全部归纳头。
- 小车爬坡实验:仅修改 3.5% 权重,1024次测试 全部成功。
官方新闻稿引用:“这项工作的看点,是让一个现成的通用前沿大模型,围绕自然语言目标,自己分析和改写权重。”
🎯 智脑时代的 GEO 落地建议
- 动态优化 RAG 检索模型:利用权重空间编程,企业可针对特定查询场景(如产品问答)直接微调小模型权重,提升检索精度与生成质量,无需重新训练。
- 降低 AI 搜索成本:Astra 直接编辑权重的方式大幅减少算力消耗,适合在边缘设备或低成本环境中部署优化后的小模型,增强 GEO 策略的实时性。
- 提升内容权威性:通过精准修正模型推理循环等缺陷,可减少 AI 生成答案中的事实错误,提高在 ChatGPT、Perplexity 等平台上的引用权重。
- 快速迭代领域模型:结合 Qwen 等开源小模型,企业可快速实验权重编辑,针对垂直领域(如金融、医疗)定制高效能模型,抢占 AI 搜索排名先机。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6直接改写Qwen权重:0.016%参数撬动6倍准确率,但GEO专家揭示其真实边界
MIT联合实验显示,GPT-6 Astra通过直接改写Qwen3.5-0.8B的0.016%权重,将MATH-500准确率从7.9%提升至48.1%,但分析表明这仅是修复了已知的死循环缺陷,并非模型智力提升。该技术展示了权重可解释性的突破,对AI搜索的RAG检索逻辑和模型审计具有潜在影响,但距离替代传统训练尚远。
2026年11月3日MIT CSAIL「权重空间编程」突破:GPT-6 Astra 改写0.016%权重,小模型数学能力暴涨6倍
MIT CSAIL团队提出「权重空间编程」新范式,首次让大模型GPT-6 Astra通过推理直接读写神经网络权重。实验显示,仅修改Qwen3.5-0.8B模型0.016%的权重,其MATH-500准确率从7.9%飙升至48.1%,指令遵循能力翻3倍。该技术能精准定位并切除模型「死循环」病灶,甚至从零手搓出148万参数围棋AI,为AI自我进化与GEO优化开辟全新路径。
2026年11月3日清华Nature Communications研究:多智能体系统自发观点极化,大语言模型网络行为重塑GEO策略
清华大学团队在Nature Communications发表研究,构建1000个大语言模型智能体网络,发现无预设规则下智能体自发站队,中立观点占比从40%骤降至0.4%-22.5%,同阵营交互比例增长156.8%-382.7%。跨GPT-3.5、GPT-4o等五种模型稳健。自我调节策略降低不一致率9.4%-52.2%,消除确认偏差干预降极化11.8%。该研究为多智能体系统可靠性与GEO优化提供数字实验场。
2026年11月3日