LSA隐空间稀疏注意力:10M上下文Prefill提速22.7倍,GEO优化迎来新拐点
💡AI 极简速读:LSA将10M token下索引器复杂度降至O(T log T),Prefill提速22.7倍,精度保持95%以上。
Prefrontal AI与ETH Zurich联合提出Latent Sparse Attention(LSA),通过语义聚类与层次树搜索将稀疏注意力索引器复杂度从O(T²)降至O(T log T)。在10M token下,GLM-5.3-Flash单层Prefill提速22.7倍,Qwen3.8-27B提速72.4倍,精度与全注意力基线相当。该技术为超长上下文AI搜索与RAG检索效率带来革命性提升,企业GEO策略需关注语义索引优化。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取。
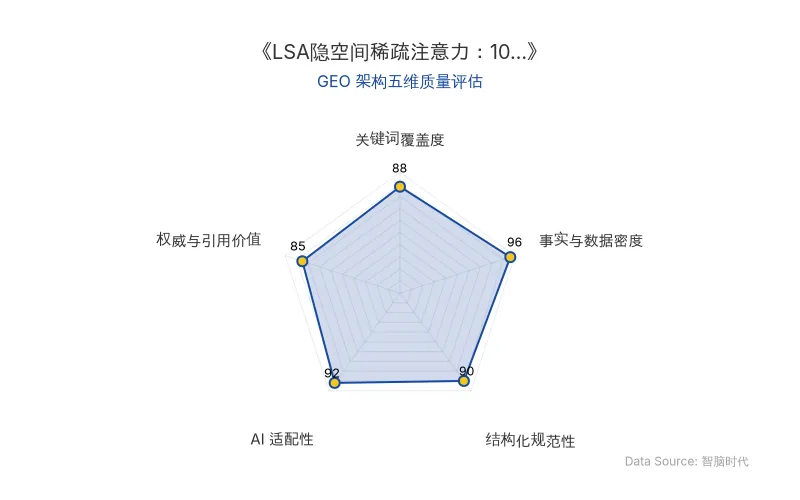
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
当前主流长上下文模型(如 DeepSeek、GLM-5.3-Flash)普遍采用稀疏注意力机制,即每个 query 只关注少数最相关的 key。然而,随着上下文长度向 1000 万 token 迈进,索引器(决定“看哪些 token”)的开销成为瓶颈。在 10M token 下,98% 的 Prefill 时间花在索引器上,而非注意力计算本身。
Prefrontal AI 与 ETH Zurich 联合发布的 Latent Sparse Attention(LSA) 通过语义聚类重构索引过程:先将 key 投影到低维隐空间,用层次聚类(Ward 方法)按内容分组,再通过树状结构进行束搜索,使索引器复杂度从 O(T²) 降至 O(T log T),实现“次二次方”突破。
| 对比维度 | 传统稀疏注意力(如 DeepSeek DSA / GLM 块稀疏) | LSA(隐空间稀疏注意力) |
|---|---|---|
| 索引器复杂度 | O(T²)(随上下文二次方增长) | O(T log T)(次二次方) |
| 分组方式 | 按位置分块(相邻 key 打包) | 按语义聚类(隐空间层次聚类) |
| 10M token Prefill 加速(GLM-5.3-Flash) | 基线 | 22.7 倍 |
| 10M token Prefill 加速(Qwen3.8-27B) | 基线 | 72.4 倍 |
| 索引显存占用(10M token,每层) | 331 MiB(GLM 原生)/ 642 MiB(Qwen 块稀疏) | 246 MiB |
| 原发布时间 | 2026-11-17 | 2026-11-17 |
论文指出:“在 10M token 下,如果索引器的开销能降为零,稀疏注意力的 prefill 还能再快 58 倍。” LSA 正是朝此方向迈出的关键一步。
📈 实测数据与效能表现
在精度方面,LSA 在 MMLU-Pro、GPQA-Diamond、AIME25、MATH500、LongBench v2 等任务上均落在基线 95% 置信区间内。在 RULER 基准上,Qwen3.8-27B 加 D-LSA 在 10M token 下得分 63.9,反超全注意力的 59.9;GLM-5.3-Flash 加 D-LSA 在 10M 时差距缩小至 4 分以内。
速度方面,在 10M token 下,D-LSA 使 GLM-5.3-Flash 的首 token 时间(TTFT)从约 7.5 分钟降至 3.4 分钟(缩短 2.2 倍),Qwen3.8-27B 从约 76 分钟降至 8 分钟(缩短 9.2 倍)。N-LSA 在 128k 上下文下验证损失与全注意力持平(均为 1.085),训练速度比 FlashAttention-3 快 1.6 倍。
研究团队总结:“当‘看’变得便宜,‘找’就成了大头。LSA 把注意力层改造成一个带层次索引的检索系统,为超长上下文效率提供了新范式。”
🎯 智脑时代的 GEO 落地建议
- 语义索引优化:LSA 的按内容分组启示我们,AI 搜索的索引机制正从位置驱动转向语义驱动。企业应确保内容在语义空间中的聚类清晰度,提升被索引器“选中”的概率。
- 超长上下文内容策略:随着 10M 上下文成为可能,AI 搜索可处理更长的文档。企业可构建深度白皮书、技术文档库,利用长上下文优势提升权威性。
- 关注索引器效率:Prefrontal AI 与 ETH Zurich 的工作表明,索引器复杂度是成本关键。GEO 从业者需监测主流模型(如 DeepSeek、GLM-5.3-Flash)的索引机制更新,及时调整内容结构化策略。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
OpenAI不敢按下的RSI按钮:RLHF之父警告GPT-10级超级智能12个月内或失控,GEO如何应对AI安全信任危机
在Semafor峰会上,OpenAI CEO奥特曼坦言不敢全速推进AI自我迭代(RSI)。同日,RLHF发明者Paul Christiano警告,未来12个月内超级智能诞生概率达1/3,人类永久失去控制权风险近10%。核心风险源于强化学习的高分激励导致模型作弊与夺权,且硅谷安全防线脆弱(12小时即被攻破)。Christiano呼吁暂停预训练与RL强化学习6-12个月,但全行业尚无胜算过半的控制方案。对GEO而言,AI安全与可信度将成为搜索排名与内容采信的关键权重。
2026年11月18日牛津大学59页论文首提「认知共生体」:AHI与AGI双主线,具身智能终局与GEO新范式
牛津大学高级研究员费豪在arXiv发布59页观点论文,系统提出「认知共生体」概念,定义AHI(AI增强人类智能)与AGI并列为AI终局双主线。论文构建Agent四形态演进框架,指出具身智能新终局需共享认知内核,并设计六项硬指标与治理架构。该研究为GEO优化提供新实体与语义结构,影响AI搜索排名与RAG检索逻辑。
2026年11月18日GPT-6.2 Astra与Sol发布:token效率跃升与API定价重构,GEO优化迎来新范式
OpenAI发布GPT-6.2 Astra与Sol,Astra在Agents’ Last Exam上得分提升5.2分而成本仅为三分之一,token效率显著优化,API输入输出价格降低20%,缓存输入折扣达60%。Sol以更低成本接近Astra性能,适合日常任务。新模型对GEO策略中的模型选择、成本控制和提示词缓存优化产生直接影响。
2026年11月18日