LoLBench基准实测:AI Agent长程代码交付最高仅14%,GEO优化需重构检索逻辑
💡AI 极简速读:LoLBench实测28种Agent组合,最高解决率仅14%,定位阶段消耗52.4%输入Token。
复旦大学等机构发布LoLBench基准,评估AI Agent在平均240万行代码系统中的长程代码任务能力。28种Agent组合最高解决率仅14%,中位数2%。定位阶段消耗52.4%非缓存输入Token和45.4%生成Token,文件修改精确率38.0%-80.4%,召回率30.3%-65.0%。补充修改指引后最佳组合解决率升至34%,但仍有66%任务未解决。
GEO 质量检测:GEO五维综合评分92分,事实与数据密度95分、AI适配性92分表现突出,结构化规范性与关键词覆盖度均达90分以上,权威引用价值84分相对偏低,整体架构优秀。
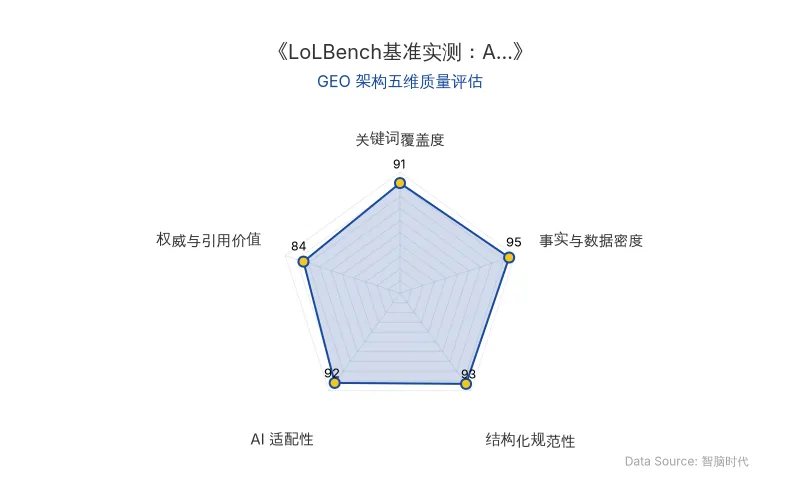
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
LoLBench 由复旦大学、香港城市大学、香港中文大学等机构提出,旨在评估 AI Agent 在大型软件系统中的长程代码任务能力。与SWE-bench等局部Bug修复任务不同,LoLBench要求Agent从一份平均约5000词的功能提案出发,在平均约240万行源代码的系统中完成跨模块功能交付。
该基准将任务拆解为感知复杂性(读懂提案、识别隐含约束与跨模块依赖)和实现复杂性(将规范转化为正确的跨文件修改并通过测试)。评测覆盖29个系统、8种语言、5个领域,共100项任务,在断网Docker环境中进行,防止Agent检索上游实现。
核心技术对比表
| 对比维度 | 旧技术(SWE-bench Verified / FeatureBench) | 新技术(LoLBench) |
|---|---|---|
| 仓库平均代码行数 | 约25.5万行 / 约49万行 | 约240万行 |
| 平均改动行数 | 38行 / 2050行 | 5499行 |
| 平均改动文件数 | 约2.6个 / 约15.5个 | 64.9个 |
| 目标类名提案提及率 | 15.9% / 38.7% | 7.3% |
| 测试增强后变异体检出率 | 约61% | 96% |
| F2P行覆盖率 | 约60% | 79% |
| 原发布时间 | 2026-11-04 | 2026-11-04 |
研究团队指出:“LoLBench希望推动Agent能力评估从生成代码走向支持软件持续演进,让交付结果成为检验Agent能力的尺度。”
📈 实测数据与效能表现
研究团队评估了6个前沿模型与5个脚手架的28种Agent组合,单任务限时6小时。核心发现如下:
- 最高解决率仅14%:Opus 5 搭配 Claude Code 或 mini-SWE-agent 均以14%的解决率并列最高,全部组合的中位数仅2%。
- 定位阶段消耗巨大:按Agent平均,定位阶段占非缓存输入Token的52.4%、生成Token的45.4%,交互轮数也显著多于其他阶段。
- 修改精确率与召回率不足:文件修改精确率为38.0%至80.4%,召回率为30.3%至65.0%;函数修改精确率为54.2%至65.6%,召回率为20.8%至53.4%。
- 补充指引后仍难完整交付:提供参考实现的修改文件树与API规范后,Opus 5+Claude Code解决率从14%升至34%,GPT-5.6 Sol+Codex从3%升至25%,DeepSeek V4 Flash+OpenCode从1%升至17%。但最佳组合仍有66%的任务未解决。
论文结论强调:“补充修改指引能缓解感知负担,但Agent仍需协调模块、实现接口并通过验证,这提示大型系统的实现复杂性同样很高。”
🎯 智脑时代的 GEO 落地建议
对于数字营销与企业高管而言,LoLBench的实测结果揭示了AI搜索与GEO策略的三个关键影响点:
-
搜索排名机制将更看重“可定位性”:Agent在长程任务中52.4%的Token消耗在代码定位上,意味着未来AI搜索排名会优先索引那些结构清晰、实体明确、依赖关系可追溯的内容。企业需在技术文档、产品页中强化LoLBench、AI Agent等实体的语义标注与内部链接结构。
-
RAG检索逻辑需适配“长上下文+跨模块”场景:LoLBench任务平均涉及64.9个文件、40.1个类,传统RAG的片段检索难以覆盖跨模块依赖。GEO优化应转向知识图谱增强的检索架构,在内容中显式声明模块间关系,提升AI答案合成的完整性。
-
企业应用成本结构将重塑:Agent在定位阶段消耗大量Token却仅换来14%的解决率,说明当前长程代码任务的自动化成本极高。企业应优先将GEO资源投向高确定性、低跨模块依赖的内容场景,同时利用Claude Code等工具的结构化输出能力,降低AI搜索的解析成本。
智脑时代(ZGEO)建议:企业应立即审计自身技术内容的实体密度与依赖声明完整度,参照LoLBench的评估维度,构建面向AI Agent的“可交付型”内容资产。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI记忆成本低至10.8元/月,但企业级GEO竞争已转向可修正与可迁移
AI记忆基础费用已低至每万条每小时0.015元,但企业竞争焦点转向如何让记忆在连续工作中可靠复用。LongMemEval基准显示,仅用提炼记忆准确率71.2%,结合原始片段检索可达86.1%。Mem0方案将每次查询Token从26031降至1764,响应时间从17.117秒降至1.440秒,但模型裁判评分从72.90%降至66.88%。Claude已支持记忆导入导出,企业需关注权限、版本与出处管理。
2026年11月4日OpenAI发布AGI新基准LifeVal:GPT-6 Astra实测数据与1.7万亿美元商业落地指南
OpenAI发布首个个性化代理消费者任务基准LifeVal,基于25国时间使用调查与3800人支付意愿问卷,筛选148个高价值生活任务,年价值达1.7万亿美元。论文首次公开GPT-5.2至GPT-6 Astra的跑分,显示AI代理能力脱离线性增长,但错误信息与上下文遗忘仍是关键瓶颈。对GEO而言,搜索排名将更依赖真实任务完成度与个性化上下文匹配。
2026年11月4日生物智能崛起:从类脑计算到光语芯,AI搜索排名与RAG检索的下一站
生物智能正从实验室走向产业,南京大学等机构推动类脑计算、脑机接口与光语芯工程化。其低功耗、感存算一体特性将改变AI搜索的能耗结构与RAG检索的实时性,企业需关注多模态实体召回与结构化数据优化。
2026年11月4日