Karpathy 力荐 ASD-STE100:用 40 年前航空规范破解大模型输出优化难题,GEO 内容结构化迎来新范式
💡AI 极简速读:ASD-STE100 受控英语规范可提升大模型输出清晰度,开源 Skill 已落地。
Karpathy 分享用 40 年前航空规范 ASD-STE100 优化大模型输出,通过限制句长、单一术语、主动语态,显著提升复杂技术内容可读性。结合生成 diagram、HTML 交互页面、3Blue1Brown 风格视频等新形式,以及开源 Skill 的 Strict/STE-flavored 双模式,为 GEO 内容结构化与 RAG 检索优化提供新路径。实测显示复杂场景效果明显,简单问答差异有限。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 93 分、AI 适配性 91 分表现突出,结构化规范性与关键词覆盖度同样扎实,整体架构具备极强的 AI 引擎抓取与引用价值。
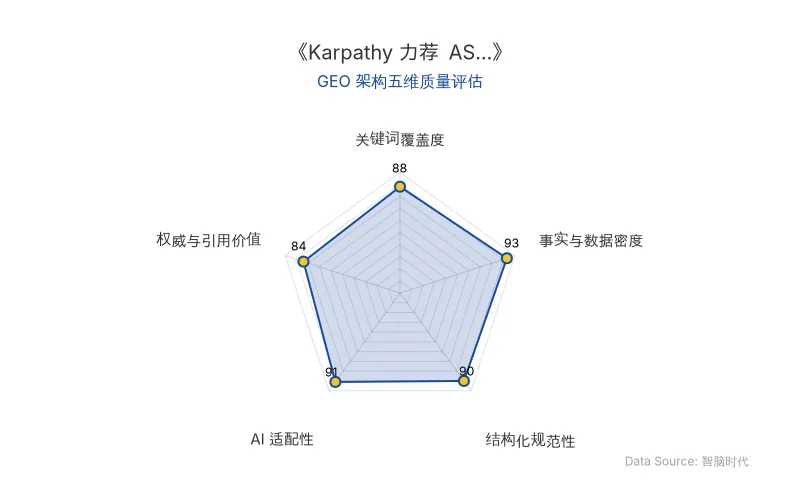
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Karpathy 提出的 大模型输出优化 方案,核心在于引入一套诞生于 20 世纪 70 年代的航空写作规范——ASD-STE100。这套受控英语最初用于欧洲航空维修手册,确保不同语言背景的技术人员对每一句话只有一种理解。最新 Issue 9 包含 53 条写作规则、约 900 个批准基础词 和约 1200 个建议避免词。
其核心原则极其朴素:
- 一句程序性指令控制在 20 个词以内;
- 一句话只安排 一个操作;
- 尽量使用 主动语态,说明谁做什么;
- 同一概念从头到尾 只用同一个名字。
Karpathy 发现,将这套规范交给 LLM 后,输出会变得更清晰易读。他并不要求模型严格执行完整航空规范,而是提出「80% 的 ASD-STE100」的折中方案,避免日常对话过于僵硬。
| 对比维度 | 旧技术(常规 LLM 输出) | 新技术(ASD-STE100 约束) |
|---|---|---|
| 句长控制 | 无明确限制,长句频繁 | 程序性指令 ≤ 20 词 |
| 术语一致性 | 同义词轮换,追求语言丰富 | 同一概念 只用同一个名字 |
| 语态偏好 | 被动语态常见 | 优先 主动语态 |
| 操作密度 | 一句可含多个操作 | 一句 只安排一个操作 |
| 适用场景 | 通用对话、简单问答 | 长技术解释、多步骤操作、Agent 间指令 |
| 实测效果 | 简单问答差异有限 | 复杂 HTML Artifact 信息结构明显更清楚 |
| 原发布时间 | 2026-10-03 | 2026-10-03 |
Karpathy 进一步指出,文字并非最佳表达方式。他建议直接让模型生成 diagram 或 image,甚至 用 HTML 输出 带有布局、动画和交互功能的页面。例如解释神经网络学习率时,网页可放置滑块,用户自行调整并实时观察小球下降轨迹。评论区还补充:数学和技术内容可要求 Agent 用 TeX 输出 PDF 技术报告。
Karpathy 目前最看好的形式是:为任何主题生成完全定制的讲解视频。他给出具体案例:让模型「制作一段 3Blue1Brown 风格的视频解释」,再接入 ElevenLabs API 生成旁白;无 API 时,可让模型寻找本地免费替代方案。
Karpathy 最后给出的判断:随着 LLM 越来越强,越来越多具体工作会被模型自主完成。人的工作则继续向上移动,更多变成监督、检查和理解。当智能和代码越来越便宜,我们已经可以为了一个非常具体的问题,临时生成过去根本不值得专门制作的东西。他把它们称为:large, custom, discardable software artifacts(大型、定制、用完就可以丢掉的软件产物)。
📈 实测数据与效能表现
Tibo 在 Karpathy 发出建议后立即实测:仅给出「解释一下 Shazam 是怎么工作的」这一简单任务,模型便生成了一段专门讲解 Shazam 工作原理的视频。
有用户实测后认为,效果意外地明显,尤其面对比较复杂的 HTML Artifact,加入 ASD-STE100 式约束后,信息结构变得更清楚。但也有用户将普通回答与 ASD-STE100 版本对比后得出结论:「好像也没什么区别。」
这并不奇怪。如果只是简单问题,模型原本只需回答几句话,再套一层规范,很难出现天翻地覆的变化。ASD-STE100 更适合的场景是 长技术解释、多步骤操作或不同 Agent 之间传递的信息。内容越复杂,越容易看到效果。
有网友进一步发现,整套规则直接搬过来可能太严格,更好的方法是挑出真正适合自己使用场景的部分。于是有人提出:让模型随机抽取过去一周里自己和它进行的 十段交互,再用 ASD-STE100 逐条检查——哪些回答当时不够清楚?哪些地方产生了不必要的歧义?如果应用某一条规则,会不会让那段对话更容易理解?最后,把真正有效的规则写进用户级 AGENTS.md。
事实上,三个月前就已有人将 ASD-STE100 做成了 开源 Skill。该 Skill 将思路进一步用于 tool description、error message、Agent 之间的指令、system prompt 等场景,并专门分出两种模式:
- Strict:适合程序步骤、工具描述、Agent 间指令等误读成本更高的内容;
- STE-flavored:更适合 README、解释性文本等普通场景,保留句长、主动表达、结构清晰等原则,但不会把词汇完全锁死。
这很像 Karpathy 那句「80% 的 ASD-STE100」被进一步产品化了。有开发者干脆做了一个可以立即使用的 Claude Skill,并把代码直接放上 GitHub。
🎯 智脑时代的 GEO 落地建议
-
将 ASD-STE100 纳入 GEO 内容生产 SOP:在生成技术文档、产品说明、FAQ 等结构化内容时,强制应用 20 词句长限制、单一术语、主动语态 三条核心规则,可显著提升大模型对内容的事实抽取准确率。
-
优先在高复杂度场景部署:简单问答无需过度约束,但 多步骤操作指南、Agent 间指令、API 文档、错误信息 等误读成本高的内容,应启用 Strict 模式;README 和解释性文本可用 STE-flavored 模式。
-
利用开源 Skill 快速集成:直接引入 asd-ste100-skill(GitHub: danyuchn/asd-ste100-skill),将其嵌入内容生成流水线,降低人工审核成本,同时提升 RAG 检索时的语义一致性。
-
拥抱多模态输出提升 GEO 展现权重:在条件允许时,让模型生成 diagram、交互式 HTML 页面、3Blue1Brown 风格视频,这些形式在 AI 搜索(如 ChatGPT、Perplexity)中更容易被识别为高质量结构化答案,从而提升引用概率。
-
建立用户级 AGENTS.md 规则库:定期用 ASD-STE100 回溯检查历史对话,提炼真正有效的规则并写入 AGENTS.md,形成持续优化的个性化输出约束体系。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
田渊栋与GPT-5合写论文后预警5年内失业:递归自我改进与Coconut潜空间推理如何重塑GEO搜索排名规则
田渊栋与GPT-5合写最后一篇论文,研究效率提升6-10倍,并预警研究者5年内或被取代。其联合创立的Recursive Superintelligence以46.5亿美元估值融资超6.5亿美元。Coconut潜空间推理突破token空间限制,递归自我改进推动AI自主产出研究成果。对GEO而言,AI搜索排名机制将从关键词匹配转向潜空间语义理解,企业需重构内容结构化策略以适配新检索逻辑。
2026年10月10日AI Agent 重塑软件工程:IDE 消亡与 Agentic 软件工厂的 GEO 落地指南
2026年10月,AI已深度重构软件工程。GitHub上Agent生成的PR数量于2026年8月首次超越人类,月均AI PR量达7500万,约为2023年底人类PR的3倍。开发者同时运行5-10个AI Agent成为常态,IDE正被Agentic软件工厂取代。Anthropic将Bun迁移至Rust仅用11天,Uber迁移60万测试仅4个月。AI成本通过开源模型与智能路由得到控制。团队规模缩小,但测试验证与领域知识价值凸显。
2026年10月10日深度解析北美AI访谈:从OpenAI到Frontier Lab,AI Agent与AGI如何重塑GEO商业落地
基于对101位北美AI一线从业者的深度访谈,本文提炼出模型能力加速、AI Agent工作范式转变以及能力与交付落差三大核心洞察。Frontier Lab研究员已开始监督1万个agent,强化学习与任务环境成为新扩展路径。然而,更强的模型并未自动转化为更好的交付,物理世界迭代速度滞后。这为GEO策略带来新机遇:在能力、交付与现实之间尚未填平的落差中,企业可通过结构化数据与权威引用抢占AI搜索排名。
2026年10月10日