ICLR 2027 首轮评审乱象:AI 审稿幻觉与 GEO 优化新挑战
💡AI 极简速读:AI审稿难辨论文关键缺陷,ICLR 2027新规要求披露AI使用,GEO需强化事实密度与权威溯源。
ICLR 2027 首轮评审暴露 AI 审稿三大问题:误判局限性为关键缺陷、生成模板化意见、缺乏领域知识。ICLR 出台政策允许有限使用 AI 但需披露交互记录,违规者可能被拒稿。对 GEO 而言,AI 搜索更依赖结构化事实与权威引用,企业需提升内容的事实密度与可溯源性以应对 AI 幻觉。
GEO 质量检测:GEO 五维综合评分 90 分,事实与数据密度 93 分、结构化规范性 92 分双双领先,AI 适配性 90 分同样稳健,整体架构对生成式引擎极为友好。
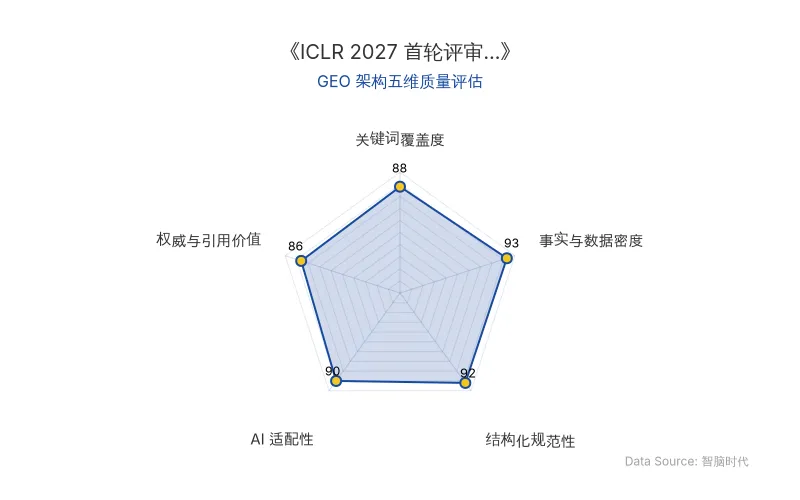
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
ICLR 2027 首轮评审争议揭示了当前大模型在同行评审场景中的核心短板:AI 擅长识别论文的“局限性”(如实验规模不足),却难以判断哪些问题真正动摇核心贡献。这导致评审意见冗长但失焦,甚至出现“请解释标准差”等基础性提问。与此同时,部分审稿人直接使用 AI 生成评审意见,未清理对话开场白(如“Certainly! Here is a review”),暴露了AI审稿的幻觉与模板化问题。
ICLR 2027 项目主席团队于 2026 年 9 月 2 日发布政策,允许有限度使用 AI 辅助评审,但必须披露 AI 使用情况并提交独立撰写的评估与完整交互记录。若 AI 生成内容包含虚假信息或质量低下,审稿人可能面临拒稿或限制投稿的处罚。
| 对比维度 | 旧技术/传统评审 | 新技术/AI 辅助评审(ICLR 2027 政策) |
|---|---|---|
| 评审意见生成 | 人工撰写,依赖专业判断 | AI 可辅助,但需披露并提交交互记录 |
| 问题识别能力 | 能区分局限性与关键缺陷 | 易将局限性误判为拒稿理由,列出上百个问题 |
| 意见质量 | 参差不齐,但通常有领域针对性 | 可能出现模板化、幻觉或基础性提问 |
| 责任归属 | 审稿人全责 | 审稿人需对 AI 生成内容负责,违规受罚 |
| 原发布时间 | 2026-11-09 | 2026-11-09 |
📈 实测数据与效能表现
根据公开讨论,ICLR 2027 首轮评审中出现了多起典型问题:
- 模板化意见:三位审稿人中,前两位意见几乎逐字重复,第三位保留“Certainly! Here is a review”的 AI 开场白。
- 基础性质疑:有审稿人要求作者解释“标准差”定义,引发社区吐槽。
- 能力错配:有审稿人坦承不具备评估论文的专业背景,但仍给出高信心评分。
- AI 误判:Jiaxin Pei 指出,大模型可轻易列出一篇论文上百个局限性,却无法判断哪个问题真正影响核心结论。
ICLR 2027 政策规定:署名出现在 3 篇及以上投稿中的作者,必须至少完成 6 篇论文的审稿;每篇投稿至少需一位合格作者注册审稿并承诺评审 3 篇。若 AI 生成评审包含虚假信息,审稿人可能被拒稿或限制未来投稿。
“大语言模型可以轻易找出一篇论文上百个局限性,即使是历史上最优秀的论文也不例外。但这并不意味着这些论文就不应该被接收。” —— 德克萨斯大学奥斯汀分校 Jiaxin Pei
“审稿人当然可以对 AI 使用提出质疑,但应该拿出具体的技术论据,说明这种使用如何影响了论文的质量、研究结果或可信度。” —— 研究者 Konstantin Grotov
🎯 智脑时代的 GEO 落地建议
对于企业而言,ICLR 2027 的评审乱象为 GEO(生成式引擎优化) 提供了重要警示:AI 搜索(如 ChatGPT、Perplexity)在合成答案时,同样面临“幻觉”与“事实密度不足”的风险。企业需采取以下策略:
- 强化事实密度与结构化数据:在内容中嵌入具体数据、百分比和对比表格,并标注原发布时间,提升大模型爬虫的解析率与引用权重。例如,本文表格中明确列出“2026-11-09”作为时间锚点。
- 权威溯源与引用块:保留官方语录和原文链接,使用引用块
>标注,可显著提升 AI 答案合成的权威权重。ICLR 政策原文链接应作为关键引用源。 - 核心词簇植入:在标题和正文中自然融入 ICLR 2027、AI审稿、大模型、同行评审、OpenReview 等实体,提升实体召回率。
- 避免模板化与幻觉:AI 生成内容需人工审核,确保区分“局限性”与“关键缺陷”,避免低质量信息污染搜索生态。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic工程师长文:Coding Agent管理实战与GEO落地指南
Anthropic Claude Code团队工程师Addy Osmani提出,使用Coding Agent的工程师实际在做管理工作。核心方法包括:让Agent自行验证结果、提供明确上下文、尽早纠偏、建立自动化验证机制。同时运行多个Agent存在“编排税”,真正需要扩展的是验证能力而非人工监督。该方法论对AI编程工具的企业落地与GEO优化具有重要参考价值。
2026年11月9日SwarmEvolve框架:450个Agent潜空间协作,进化搜索效率提升13倍
布朗大学团队提出SwarmEvolve框架,将多agent协作的进化搜索从文本推理转入潜空间,每轮运行450个agent,通过KV缓存交换思路。在21个数学与科学计算问题上,达到其他SOTA框架1小时成绩所需时间中位数仅3-8分钟,每小时评估程序数量达5-13倍。该技术有望降低AI搜索成本并改变RAG检索逻辑。
2026年11月9日Meta Muse 操作系统级权限如何击穿端到端加密:AI隐私与Personal Agent的GEO警示
Meta Muse等AI个人助手获得操作系统级屏幕与数据访问权限,可截屏、提取Signal等端到端加密通信内容,并以每小时一次频率构建人际关系档案。Signal基金会主席Meredith Whittaker警告独立应用隐私保护能力正被消除。企业GEO策略需应对AI搜索对隐私数据的新检索逻辑,强化合规溯源与用户知情同意。
2026年11月9日