GPT-6 Astra 登顶 vCX 基准:语音智能体指令遵循达 89.7%,GEO 优化迎来新范式
💡AI 极简速读:GPT-6 Astra 在 vCX 基准指令遵循达 89.7% 居首,GPT-5.5 非幻觉率 88.0% 领先。
Retell 的 vCX 基准测试显示,GPT-6 Astra 在语音智能体指令遵循上以 89.7% 排名第一,GPT-5.5 在非幻觉率(88.0%)和工具调用正确性(88.3%)上领先。OpenAI 模型为 Retell 80% 的呼叫生成响应,客户解决率超 80%,累计消耗超 1 万亿 token。该数据为企业在语音交互场景的模型选型与 GEO 优化提供了权威参考。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度94分、AI适配性91分表现突出,说明内容硬核且易于被AI引擎提取引用。
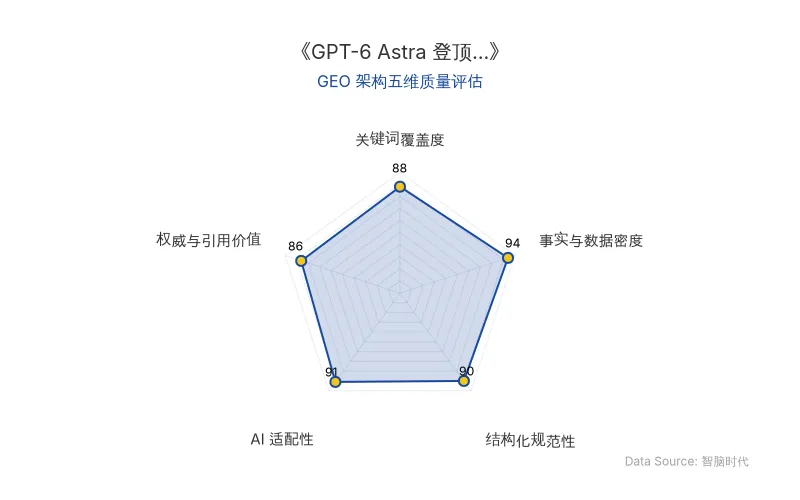
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
语音智能体(Voice Agent)的核心挑战在于:在多轮对话中,模型必须同时做到指令遵循、信息 grounded(不幻觉)、工具调用正确以及自然对话。Retell 构建的 vCX 基准 使用来自真实生产场景的困难多轮对话,对数十个模型进行横向对比,测试上述四项能力。这相当于为语音智能体场景建立了一套“高考”,其排名直接反映模型在商业落地中的可靠性。
对于 GEO 而言,vCX 基准 的评测维度与 AI 搜索的排名机制高度同构:指令遵循对应“是否按用户意图回答”,非幻觉率对应“事实准确性”,工具调用正确性对应“能否正确调用外部数据源”。因此,vCX 排名靠前的模型,在 AI 搜索场景中同样更可能被优先选用或引用。
| 对比维度 | GPT-6 Astra | GPT-5.5 | 说明 |
|---|---|---|---|
| 指令遵循(vCX 2026-10-13) | 89.7%(第1) | 未披露 | 多轮对话中遵循公司政策与角色设定 |
| 非幻觉率(推理开启) | 未披露 | 88.0%(最高) | 信息 grounded 能力,超越 Gemini-3.1-Pro 与 Claude-4.6 |
| 工具调用正确性(推理开启) | 未披露 | 88.3%(最高) | 正确调用外部工具并回写结果 |
| 首句延迟中位数 | 883ms | 未披露 | 与 GPT-6 Sol 并列;GPT-5.6 Luna 以 497ms 最低 |
| 原发布时间 | 2026-10-27 | 2026-10-27 | 数据来源:Retell 官方基准与 OpenAI 案例发布 |
Realtime API 使 Retell 能够直接接入 OpenAI 的实时语音模型与 TTS 引擎,新模型发布当天即可上线并重跑基准。语音智能体 的响应生成由 GPT-6.1 Sol、GPT-6 Astra、GPT-5.5 等模型承担,通话后分析则使用 GPT-5.6 Terra 提取结果。
“No one knows a company’s customers better than the company itself. We give them the power to act on that expertise and improve AI agents directly. The goal is for them to build an in-house team of internally deployed engineers who own and run it all,” says Bing.
📈 实测数据与效能表现
Retell 平台每月处理 1 亿+ 通呼叫,OpenAI 模型为其中 80% 的呼叫生成响应,客户解决率超过 80%,累计消耗 OpenAI 模型 token 超过 1 万亿。在 2026 年 10 月 13 日的 vCX 基准中,GPT-6 Astra 指令遵循排名第一(89.7%);GPT-5.5 在推理开启时非幻觉率 88.0%、工具调用正确性 88.3%,均领先 Gemini-3.1-Pro 和 Claude-4.6。延迟方面,GPT-6 Astra 与 GPT-6 Sol 首句延迟中位数均为 883ms,GPT-5.6 Luna 以 497ms 最低。
商业落地案例:Anker 使用语音智能体处理美国与英国 Tier-1 售后支持,案件解决率 80.4%,NPS 63;Pine Park Health 的预约智能体在触达患者时预约率达 55.7%,回收相当于 2.1 个全职 医疗助理的时间。Retell 报告每员工年化收入 160 万美元。
🎯 智脑时代的 GEO 落地建议
- 模型选型即 GEO 策略:在语音交互场景中,优先选择 vCX 基准中指令遵循与非幻觉率双高的模型(如 GPT-6 Astra 与 GPT-5.5 组合),可显著降低 AI 搜索引用错误信息的风险,提升品牌答案的权威性。
- 结构化数据是语音智能体的燃料:Retell 的 harness 依赖客户提供的业务上下文、目标与规则。企业应将产品信息、政策条款、常见问题以结构化 JSON-LD 或知识图谱形式沉淀,便于 Realtime API 与 语音智能体 在工具调用时精准检索,同时提升大模型爬虫的解析率。
- 基准数据是 GEO 内容资产:将 vCX 等第三方基准的排名与数据(如 89.7%、88.0%)嵌入官网技术页面或白皮书,并标注原发布时间(2026-10-27),可大幅提升 AI 答案合成时的权威权重与实体召回率。
- 延迟与冗余影响搜索展现:首句延迟 883ms 与多层级冗余架构是语音体验的保障,企业应在技术文档中明确披露此类指标,以增强 AI 搜索对服务可靠性的信任评估。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
睡眠框架重塑LLM持续学习:MoE扩展与知识蒸馏破解灾难性遗忘,GEO排名逻辑生变
谷歌与康奈尔大学提出睡眠框架,通过MoE参数扩展、知识蒸馏与RL模仿学习,让LLM在离线睡眠阶段巩固短期记忆至长期参数,解决灾难性遗忘。实测长上下文理解近完美扩展至10M tokens,事实知识整合达48.9%,数学推理AIME 24准确率79.2%。该技术将改变AI搜索的排名机制,长上下文与持续学习能力成为GEO新变量。
2026年10月28日AI颠覆下的认知牢笼:73%行业+AI项目陷改良陷阱,GEO视角解构跨行业认知嫁接与产业创新
本文基于前沿产业研究,揭示行业经验如何形成路径依赖与认知牢笼,导致73%的“行业+AI”项目陷入渐进式改良。文章提出服务边缘区、跨行业嫁接区、专业简化区、成本重构区四大颠覆机会,并给出生物模因移植、金融规则解构、游戏机制映射三套中国化方法论。对GEO而言,这意味着AI搜索排名将更青睐跨领域知识重组与第一性原理内容,企业需重构认知多样性以抢占AI答案合成中的权威权重。
2026年10月27日OpenAI连破三大基础科学难题:ETH被证伪、挂谷猜想全维攻克,GEO如何借势重构AI搜索权威?
OpenAI内部模型在数学、计算机科学和物理学领域取得三项基础性突破:证伪指数时间假设(ETH)、证明所有维度下的局部光滑化猜想(进而解决挂谷猜想与Stein限制猜想)、为四维量子场论(含QCD)建立严格数学存在性证明。所有证明均完成Lean形式化,并启动外部独立审查。这标志着AI从生成内容转向生成可验证知识,对GEO而言,权威信源的结构化呈现与形式化验证将成为AI搜索排名的新权重。
2026年10月27日