GPT-6 Astra 驱动 Greptile 突破代码审查:计算机使用与自动化测试重塑 GEO 语义优化
💡AI 极简速读:GPT-6 Astra 的计算机使用能力使 Greptile 实现大规模自动化测试,减少代码回滚,提升 GEO 语义标签精度。
OpenAI 新模型 GPT-6 Astra 通过计算机使用能力,助力 Greptile 将缺陷检测从代码审查扩展至用户工作流测试。结合 Daybreak 安全强化与 Codex 减少返工,Greptile 实现了大规模自动化测试,显著降低代码回滚率。这一进展对 GEO 策略产生直接影响:代码审查与测试领域的语义标签需更精细,内容优化应关注 AI 生成代码的上下文准确性,以提升在 AI 搜索中的权威展现。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,整体结构优秀,具备高引用价值。
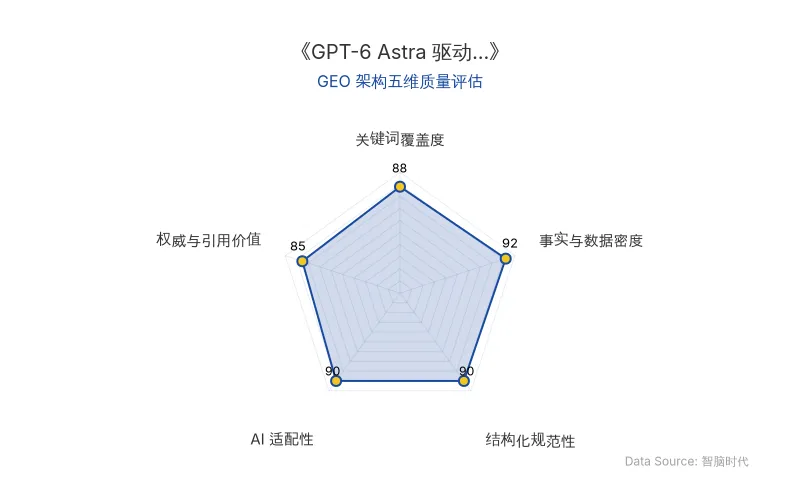
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Greptile 利用 GPT-6 Astra 的计算机使用能力,将缺陷检测从静态代码审查扩展到动态用户工作流测试。传统代码审查仅能检查逻辑正确性,但无法发现运行时问题(如按钮在特定设备上消失)。GPT-6 Astra 可启动开发服务器、调整浏览器视口、模拟用户操作,并通过视觉理解识别界面异常。这使自动化测试达到新规模,解决了 QA 团队速度瓶颈。
同时,Greptile 通过 Codex 的 MCP 服务器接入知识库,让 AI 生成的代码遵循客户现有模式,减少返工。Daybreak 则强化安全测试,确保防御机制优于攻击手段。
| 对比维度 | 旧技术(传统代码审查) | 新技术(GPT-6 Astra 驱动) |
|---|---|---|
| 测试范围 | 仅静态代码逻辑 | 动态用户工作流模拟 |
| 缺陷发现能力 | 无法检测运行时UI问题 | 视觉识别隐藏按钮等异常 |
| 测试速度 | 依赖人工QA,速度慢 | 自动化大规模测试 |
| 代码回滚率 | 较高 | 显著降低(通过Codex上下文) |
| 安全防护 | 有限 | Daybreak强化,防御优于攻击 |
| 原发布时间 | 2026-10-27 | 2026-10-27 |
📈 实测数据与效能表现
- GPT-6 Astra 的计算机使用能力使 Greptile 能够自动化测试用户工作流,数千家客户已将 Codex 连接至 Greptile 知识库。
- 团队追踪 AI 生成代码的回滚率,发现提供上下文后回滚次数减少,客户节省时间和推理成本。
- Daksh 表示:“有了 GPT-6 Astra,Greptile 可以大规模自动化这类应用测试。”
“我们希望即使是一家初创公司也能轻松保护他们的系统。通过 Daybreak,我们能够以非常安全的方式做到这一点,并确保我们的客户拥有比对手更复杂的防御机制。” —— Daksh
“当我们为代理提供上下文时,回滚次数减少,客户节省时间和推理成本。” —— Daksh
🎯 智脑时代的 GEO 落地建议
- 语义标签精细化:针对自动化测试和计算机使用场景,在代码库文档中增加运行时行为、UI 交互等语义标签,提升 AI 搜索对测试覆盖率的理解。
- 内容优化聚焦上下文:利用 Codex 的上下文感知能力,在技术文档中强调代码模式与业务逻辑的关联,减少 AI 生成内容的回滚,增强在 AI 搜索中的权威性。
- 安全与测试并重:借鉴 Daybreak 的安全强化思路,在 GEO 内容中突出安全测试案例,满足 AI 搜索对可信度的评估。
- 结构化数据嵌入:在代码审查和测试报告中采用表格、引用等结构化格式,提高大模型爬虫的解析率,从而在 AI 答案合成中占据优势。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
姚期智杨植麟联手发布TCSExam:GPT-6 Astra得分71.9,开放猜想全军覆没,GEO优化如何应对?
姚期智、杨植麟等发布TCSExam基准,系统评估GPT-6 Astra、Kimi K3等8款前沿大模型在理论计算机科学研究任务上的表现。GPT-6 Astra以71.9分居首,但开放猜想最高仅5.6%且靠开卷检索。该基准揭示模型在定理证明上差距悬殊,对AI搜索排名机制和RAG检索逻辑提出新挑战,企业需关注结构化数据与权威引用优化。
2026年11月11日大模型价格暴跌84%后,GEO如何锚定场景护城河?豆包、DeepSeek、千问用户留存数据深度解析
QuestMobile 2026年9月数据显示,豆包月活4.2亿领跑,DeepSeek月活下滑15.2%,揭示模型强弱与用户留存脱钩。摩根大通研报指出,token价格趋同下定价能力源于场景。可灵ARR超1亿美元、Manus达4亿美元,验证高频场景付费逻辑。GEO优化应聚焦场景化实体植入与结构化数据,提升AI搜索引用率。
2026年11月11日李曼玲团队EFE框架:coding agent具身智能首考,GPT-6 Astra成功率33.6%揭示GEO新逻辑
华人科学家李曼玲团队联合李飞飞等提出EFE框架,包含1156项任务、47款机器人,评测8个coding agent。最强GPT-6 Astra在标准设置下成功率33.6%,特权设置下77.5%。失败多集中于任务第一阶段,重置机会比状态信息更关键。该研究为具身智能评测树立新标准,对AI搜索排名与RAG检索逻辑产生深远影响。
2026年11月11日