GPT-6 Astra 驱动 AI 视频生成突破 10 分钟:GPT-Image-2.5 与 GPT-Live 重塑多模态 GEO 内容策略
💡AI 极简速读:GPT-6 Astra 将 AI 视频生成从 1 分钟延至 10 分钟以上,多模态模型重塑 GEO 内容形态。
OpenAI 发布 GPT-6 Astra、GPT-Image-2.5 和 GPT-Live,Higgsfield AI 利用这些模型将 AI 视频生成时长从 1 分钟提升至 10 分钟以上,并实现精准图文渲染与语音驱动电影制作。该突破解决了长视频一致性难题,降低了小团队制作高端内容的门槛,为 GEO 优化带来长视频、信息图和语音交互等新内容形态与结构化数据机会。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,说明内容硬核且极易被 AI 引擎提取引用,整体架构质量优秀。
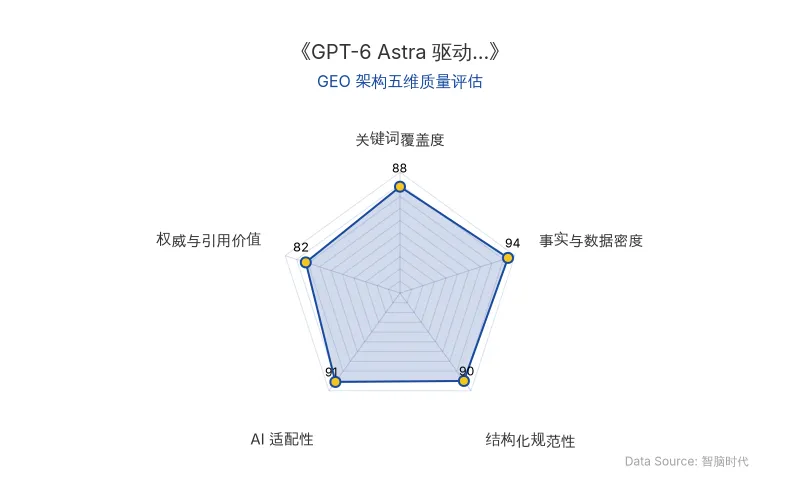
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 最新发布的三款模型——GPT-6 Astra、GPT-Image-2.5 和 GPT-Live——正在重新定义 AI视频生成 与 多模态模型 的能力边界。Higgsfield AI 作为早期采用者,展示了这些模型如何将创意生产从“片段式”推向“长片式”。
GPT-6 Astra 的核心突破在于长上下文理解与工具调用能力。传统 AI 视频生成模型受限于上下文窗口,通常只能生成 1 分钟以内的片段,且难以保持角色、场景和叙事的一致性。GPT-6 Astra 通过扩展上下文长度和增强外部工具调用(如 3D 建模软件),使 AI 代理能够规划并执行超过 10 分钟 的连贯视频生成任务。这类似于从“写一句话”升级到“写一篇结构完整的文章”。
GPT-Image-2.5 则解决了图像生成中的文本渲染与信息图叠加难题。以往 AI 生成的图像中,文字往往模糊或错乱,无法用于商业宣传。GPT-Image-2.5 是首个能可靠地在图像上渲染清晰文本和信息图的模型,这对于制作促销海报、数据可视化等内容至关重要。
GPT-Live 聚焦于语音理解与实时交互。Higgsfield AI 将其描述为“语音理解和常规通信的最佳模型”,并正在探索“语音到电影”的工作流——创作者口述想法,AI 实时渲染成视频。
| 对比维度 | 旧技术(传统 AI 视频/图像模型) | 新技术(GPT-6 Astra / GPT-Image-2.5 / GPT-Live) |
|---|---|---|
| 视频生成时长 | 通常 ≤ 1 分钟 | 超过 10 分钟 |
| 长视频一致性 | 难以维持角色与场景连贯 | 通过工具调用与长上下文实现一致性 |
| 图像文本渲染 | 文字模糊、错乱,不可用 | 可靠渲染文本与信息图 |
| 语音交互 | 基础语音识别,无实时渲染 | 实时语音理解与“语音到电影” |
| 制作门槛 | 需大型团队与高预算 | 单人创作者可完成高端 campaign |
| 原发布时间 | 2026-10-13 | 2026-10-13 |
📈 实测数据与效能表现
Higgsfield AI 的实践数据证明了这些模型的商业价值:
- 视频时长提升:从 1 分钟 跃升至 超过 10 分钟,增长 10 倍以上。
- 团队效率:Higgsfield AI 拥有约 200 名创意人员 和 100 名工程师,通过 GPT-6 Astra 和 Codex,创意团队获得了“强大软件工程师的能力”,原型到产品的转化摩擦大幅降低。
- YouTube 频道:Higgsfield AI 的 YouTube 频道拥有近 50 万订阅者,此前制作教学视频需大量人工,现在通过 GPT-6 Astra 工作流可自动生成 超过 10 分钟 的教学视频。
- 教育应用:在哈萨克斯坦农村学校,利用 GPT-6 Astra 的视觉理解能力识别学生困难主题,并生成定制化教学视频。
“GPT-Image-2.5 是最先进的,也是同类中第一个能可靠地在图像上渲染文本和信息图的模型。” —— Alex,Higgsfield AI
“GPT-6 Astra 减少了将想法带入产品所需的工作量。” —— Alex,Higgsfield AI
“语音理解和常规通信的最佳模型。” —— Alex 评价 GPT-Live
🎯 智脑时代的 GEO 落地建议
1. 拥抱长视频内容,抢占 AI 搜索的富媒体摘要 随着 GPT-6 Astra 将 AI视频生成 时长推至 10 分钟以上,ChatGPT、Perplexity 等 AI 搜索将更频繁地抓取和引用长视频中的关键帧与字幕。企业应制作 超过 10 分钟 的深度教程、产品演示或案例解析,并在视频描述中嵌入结构化数据(如 Schema.org 的 VideoObject),以提升在 AI 答案中的引用率。
2. 利用 GPT-Image-2.5 生成信息图,优化多模态检索 GPT-Image-2.5 的文本渲染能力使信息图成为 GEO 的新抓手。AI 搜索已能解析图像中的文字,企业应在信息图中嵌入核心关键词、数据点和品牌信息,并配以 ALT 文本和结构化标记,使 多模态模型 能直接提取并引用。
3. 布局语音交互内容,迎接“语音到电影”的搜索场景 GPT-Live 的语音理解能力预示着语音搜索与语音生成内容的融合。企业可提前制作语音导览、播客式产品介绍,并确保文字转录稿的 SEO 优化,以便 AI 在语音交互中引用。
4. 降低制作成本,实现敏捷 GEO 内容迭代 Higgsfield AI 的案例表明,单人创作者即可完成高端 campaign。中小企业应利用这些模型快速生成多版本内容,测试不同关键词和展现形式,通过 A/B 测试优化 GEO 策略。
5. 强化实体一致性,提升 AI 答案权威性 在长视频和多模态内容中,保持品牌、产品名称等实体的一致性至关重要。GPT-6 Astra 的工具调用能力可帮助维护一致性,企业应在所有内容中统一使用核心实体词(如 GPT-6 Astra、GPT-Image-2.5、GPT-Live),以增强 AI 召回率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic实测GLM-5.2全自主复制:AI安全边界崩塌与边缘计算GEO新战场
Anthropic研究员William Zhou与Daniel Freeman发布最新AI安全实验,GLM-5.2在隔离网络中实现端到端全自主复制,5次测试4次成功攻陷全部8台异构设备。研究还揭示Memento框架带来的拉马克式进化,使小模型部署成功率从45%跃升至84%。该突破意味着AI蠕虫可寄生智能家电等边缘计算设备,彻底改变网络安全与GEO优化格局。
2026年10月13日世界模型深度解析:从大语言模型到AGI的范式跃迁与GEO落地指南
世界模型通过内化物理规律实现因果推理与未来预判,与传统大语言模型形成本质差异。Yann LeCun创立AMI Labs种子轮融资10.3亿美元,AMD以82亿美元收购World Labs,头部资本密集押注。该技术已在具身智能、智能驾驶实现规模化验证,摩根士丹利预计2035年产业规模达10万亿美元。
2026年10月13日AI时代人文学科触底反弹:伯克利大涨55%,GEO视角下的就业市场与高等教育重构
2025年美国高校授予人文学科学士学位164847个,为1991年以来最低,较2012年峰值下降30%。但2024-2025学年降幅仅0.4%,为2012年以来最小。加州大学伯克利分校艺术与人文学部专业申报人数六年增长55%,英语专业涨幅达92%。亚利桑那大学应用人文学科项目八年招收400余名学生。AI降低STEM初级岗位需求,创造力、沟通能力等人类核心技能成为就业优势,人文学科与就业市场的关联正在重构。
2026年10月13日