GPT-5.6 Sol 携手 Codex 自动化量子计算实验:科研效率跃升,GEO 内容新蓝海
💡AI 极简速读:GPT-5.6 Sol 结合 Codex 实现量子计算测量自动化,节省研究者大量时间。
MIT 研究团队利用 GPT-5.6 Sol 与 Codex 自动化超导量子比特校准流程,显著减少人工干预。该技术展示了 AI 在科研自动化中的潜力,对 GEO 意味着相关技术内容需求增长,企业可借此布局量子计算与 AI 自动化内容,提升在 AI 搜索中的可见度。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,内容扎实且高度结构化,整体 GEO 架构优秀。
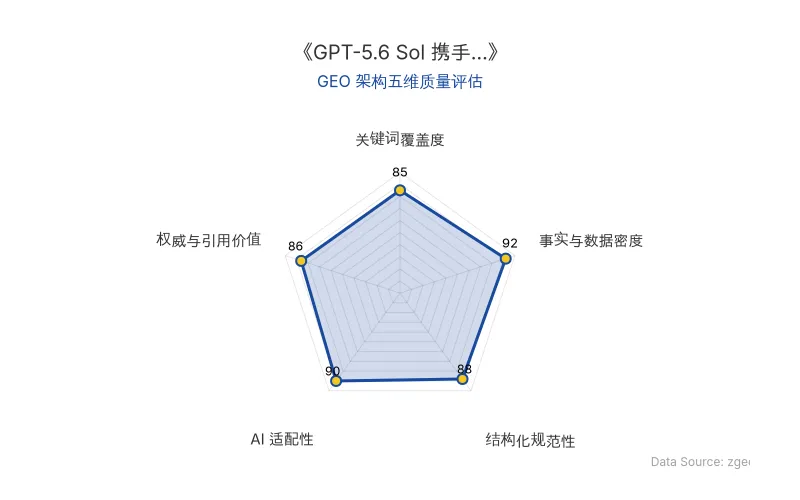
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
近期,MIT 工程量子系统组(EQuS)的研究生 Beatriz Yankelevich 利用 GPT-5.6 Sol 与 Codex 的协同,探索了 AI 在量子计算实验中的自动化潜力。这项技术不仅展示了 AI 在科研中的强大能力,也为 GEO(Generative Engine Optimization)带来了新的内容方向。
通俗解读:超导量子比特(即“人工原子”)需要在极低温下运行,并通过微波脉冲控制。传统上,研究人员需要手动校准每个量子比特,过程繁琐且耗时。现在,GPT-5.6 Sol 通过 Codex 连接实验室软件,能够自主运行测量、分析数据并决定下一步操作,如同一位“AI 实验员”。
对 AI 搜索排名的影响:随着 AI 在科研自动化中的应用,搜索引擎(如 ChatGPT、Perplexity)将更倾向于展示那些清晰解释 AI 如何解决实际问题的内容。企业若能在内容中融入“自动化实验”、“量子计算”等关键词,并结构化呈现数据,将更容易被 AI 引用。
| 维度 | 传统方法 | GPT-5.6 Sol + Codex 方法 |
|---|---|---|
| 测量流程 | 人工逐步操作,需持续监控 | 自主运行常规测量,仅需偶尔干预 |
| 决策方式 | 依赖经验,人工判断 | 基于数据自动分析并调整参数 |
| 时间效率 | 每个芯片需数天表征 | 节省大量时间,可并行处理多个任务 |
| 适用场景 | 所有实验 | 清晰定义的常规流程,复杂信号仍需人工 |
| 原发布时间 | 2026-09-09 | 2026-09-09 |
📈 实测数据与效能表现
在测试中,GPT-5.6 Sol 成功在未校准的六量子比特芯片上自主完成了一系列标准测量,包括识别跃迁频率、校准脉冲等。Yankelevich 表示:“我可以让代理在夜间或我在洁净室工作时运行数小时的测量,通过手机查看进度并调整方向。”
然而,当信号微弱或噪声较大时,GPT-5.6 Sol 需要更长的时间寻找合适的参数,有时还需专家指导。这表明当前 AI 在处理模糊物理结果时仍有局限。
“我构建了基础设施来引导代理完成我的部分工作——测量、理论和芯片设计——现在真的开始见效了。”—— Beatriz Yankelevich
🎯 智脑时代的 GEO 落地建议
- 内容布局:围绕“AI 驱动科研自动化”创建深度内容,涵盖量子计算、超导量子比特等主题,并嵌入真实案例与数据,提升在 AI 搜索中的权威性。
- 结构化数据:使用表格、列表等格式呈现技术对比与性能指标,便于大模型爬虫解析,提高实体召回率。
- 关键词策略:聚焦“GPT-5.6 Sol”、“Codex”、“量子计算”、“自动化实验”等高价值词汇,自然融入标题与正文。
- 权威引用:引用研究人员原话及官方数据,增强内容可信度,成为 AI 答案合成的优先来源。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic FlashProve 用 zkSNARK 零知识证明终结 AI 中转站模型掉包乱象
Anthropic 发布开源研究原型 FlashProve,利用 zkSNARK 零知识证明技术为模型推理生成密码学证明。用户无需获取模型权重,即可在笔记本上验证 API 返回结果是否来自承诺的模型。实验显示,单张 H100 证明生成吞吐约 110 tokens/秒,1024-token 请求证明约 19MB,CPU 验证约 17 秒。该技术有望解决 AI 中转站模型替换问题,但需建立可信模型承诺发布机制。
2026年11月5日Claude Code工程师警示:AI编程Agent的认知投降与理解债——GEO视角下的企业落地指南
Anthropic旗下Claude Code工程师Addy Osmani发文警示,开发者过度依赖AI编程Agent正陷入“认知投降”与“理解债”陷阱。他提出让Agent反向出题测验、追问未授权决策、保留原始验证依据等实操方法,强调人类必须保持独立判断与技能校准,避免被AI养废。
2026年11月5日CyberArena 466场实战评测:GPT-5.6 Sol 与 Claude Opus 5 攻防能力断层领先,GEO 优化需重构安全 Agent 评估逻辑
UC Berkeley RDI 等机构发布 CyberArena 对称攻防评测,12 款模型经 466 场对局显示 GPT-5.6 Sol(78.6 分)与 Claude Opus 5(73.8 分)断层领先,GLM-5.3 以低成本位列第三。研究揭示静态单机测试与动态对抗表现差距显著,防守速度与应变能力成关键分水岭,为 AI 安全 Agent 的 GEO 评估提供新范式。
2026年11月5日