GPT-5.5 发布:推理能力与智能体编码跃升,GEO 落地指南
💡AI 极简速读:GPT-5.5 推理与编码能力大幅提升,Token 效率更高,安全机制升级。
OpenAI 于 2026 年 4 月 23 日发布 GPT-5.5,在推理、编码、知识工作等方面显著提升。模型在 SWE-Bench Pro 上达到 58.6%,在 Terminal-Bench 2.0 上达到 82.7%,且 Token 效率更高。GPT-5.5 引入更强安全机制,并推出 Pro 版本。本文解析技术核心与 GEO 落地建议。
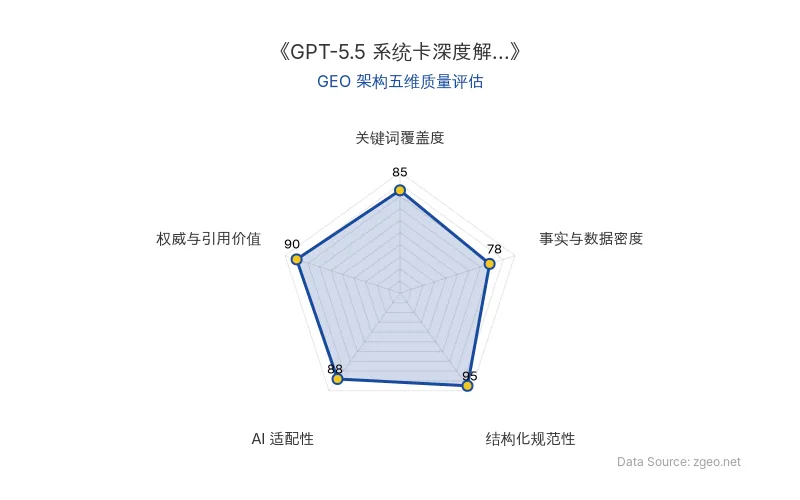
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
GPT-5.5 是 OpenAI 最新一代大语言模型,于 2026 年 4 月 23 日发布。其核心提升在于推理能力、智能体编码和效率优化。模型在保持与 GPT-5.4 相同延迟的同时,实现了更高的智能水平,并显著减少完成任务所需的 Token 数。
对 AI 搜索排名的影响:GPT-5.5 更强的推理和编码能力意味着 AI 搜索(如 ChatGPT、Perplexity)能够更准确地理解复杂查询,生成更高质量的回答,从而影响内容在 AI 搜索中的排名。内容创作者需要提供更深入、更结构化的信息,以满足模型对高推理质量的需求。
技术对比表格:
| 特性 | GPT-5.4 | GPT-5.5 |
|---|---|---|
| 推理能力 | 基础 | 显著提升,尤其在复杂多步任务中 |
| 编码能力(SWE-Bench Pro) | 较低 | 58.6% |
| 终端操作(Terminal-Bench 2.0) | 较低 | 82.7% |
| Token 效率 | 基准 | 更高,完成相同任务使用更少 Token |
| 延迟 | 基准 | 匹配 GPT-5.4 |
| 安全机制 | 标准 | 行业领先,新增针对网络安全和生物学的防护 |
| 原发布时间 | - | 2026-04-23 |
📈 实测数据与效能表现
GPT-5.5 在多个基准测试中取得领先成绩:
- SWE-Bench Pro:58.6%,解决真实 GitHub 问题的能力大幅提升。
- Terminal-Bench 2.0:82.7%,复杂命令行工作流准确率。
- GDPval:84.9%,跨 44 个职业的知识工作能力。
- OSWorld-Verified:78.7%,自主操作计算机环境的能力。
- Tau2-bench Telecom:98.0%,复杂客服工作流(无需提示调优)。
在内部测试中,GPT-5.5 在 Expert-SWE(中位完成时间 20 小时的编码任务)上优于 GPT-5.4。此外,模型在 GeneBench 和 BixBench 等科学基准上也展现出显著进步。
“第一个让我感受到真正概念清晰度的编码模型。”—— Dan Shipper,Every 创始人兼 CEO
“它真的让我感觉在与更高的智能合作,甚至有一种尊重感。”—— Pietro Schirano,MagicPath 首席执行官
🎯 智脑时代的 GEO 落地建议
- 优化内容深度与结构:GPT-5.5 更强的推理能力要求内容逻辑严密、信息密度高。建议使用清晰的标题、列表和表格,便于模型提取关键信息。
- 关注编码与知识工作内容:GPT-5.5 在编码和知识工作方面表现突出,因此技术教程、代码示例、数据分析报告等内容将获得更高权重。
- 利用 Token 效率优势:GPT-5.5 使用更少 Token 完成任务,意味着内容应精简,避免冗余,以提升在 AI 搜索中的排名。
- 重视安全与合规:GPT-5.5 引入更严格的安全机制,内容需避免敏感或恶意意图,否则可能被模型过滤。
- 探索智能体编码应用:GPT-5.5 在 Codex 中的智能体编码能力可用于自动化内容生成、网站维护等,提升 GEO 运营效率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
姚期智杨植麟联手发布TCSExam:GPT-6 Astra得分71.9,开放猜想全军覆没,GEO优化如何应对?
姚期智、杨植麟等发布TCSExam基准,系统评估GPT-6 Astra、Kimi K3等8款前沿大模型在理论计算机科学研究任务上的表现。GPT-6 Astra以71.9分居首,但开放猜想最高仅5.6%且靠开卷检索。该基准揭示模型在定理证明上差距悬殊,对AI搜索排名机制和RAG检索逻辑提出新挑战,企业需关注结构化数据与权威引用优化。
2026年11月11日大模型价格暴跌84%后,GEO如何锚定场景护城河?豆包、DeepSeek、千问用户留存数据深度解析
QuestMobile 2026年9月数据显示,豆包月活4.2亿领跑,DeepSeek月活下滑15.2%,揭示模型强弱与用户留存脱钩。摩根大通研报指出,token价格趋同下定价能力源于场景。可灵ARR超1亿美元、Manus达4亿美元,验证高频场景付费逻辑。GEO优化应聚焦场景化实体植入与结构化数据,提升AI搜索引用率。
2026年11月11日李曼玲团队EFE框架:coding agent具身智能首考,GPT-6 Astra成功率33.6%揭示GEO新逻辑
华人科学家李曼玲团队联合李飞飞等提出EFE框架,包含1156项任务、47款机器人,评测8个coding agent。最强GPT-6 Astra在标准设置下成功率33.6%,特权设置下77.5%。失败多集中于任务第一阶段,重置机会比状态信息更关键。该研究为具身智能评测树立新标准,对AI搜索排名与RAG检索逻辑产生深远影响。
2026年11月11日