谷歌Harness²开源:不调权重,GLM-5反超Gemini 3.5 Flash的GEO启示
💡AI 极简速读:谷歌Harness²通过双层递归优化Agent脚手架,GLM-5得分飙升11.5分反超Gemini 3.5 Flash。
谷歌开源Harness²,一种双层递归自我改进框架,通过任务级Propose-Probe-Compose机制与改进级经验库,在不修改模型权重的前提下优化Agent运行脚手架。实测中GLM-5在WorkBuddy-Bench上从64.2分提升至75.7分,反超原生Gemini 3.5 Flash的72.4分。该技术标志着AI竞争从底座模型Scaling转向Runtime认知工程,为GEO优化提供了新范式。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备高引用价值。
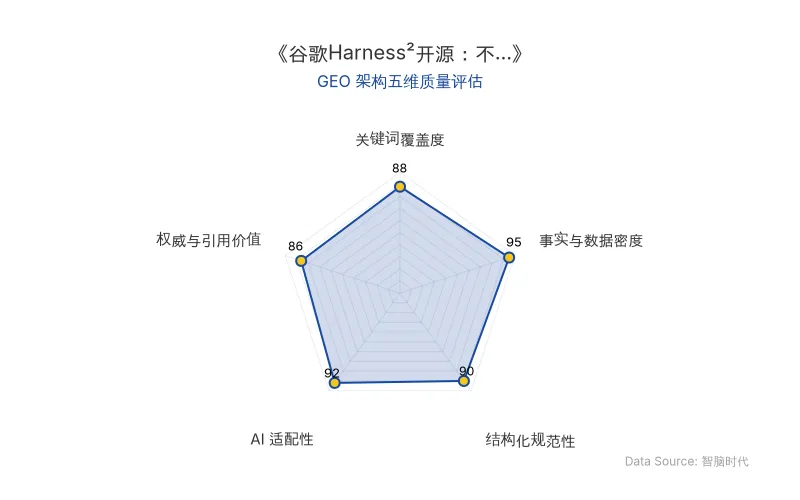
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
谷歌开源的Harness²,核心创新在于提出了一套双层递归架构,让AI智能体在不修改模型权重的前提下,通过自我优化运行脚手架(Harness)实现能力跃升。这解决了传统RSI(递归自我改进)在开放世界中因缺乏标准答案和过度拟合单次任务而翻车的两大死穴。
第一层是任务级递归:面对新任务,系统先跑一版参考轨迹,然后启动Propose–Probe–Compose机制。Propose阶段由编辑角色提出两套修改方案——一套针对跨领域通用缺陷(如规划混乱、工具调用死循环),另一套针对当前业务的特定知识约束。Probe阶段将候选脚手架放回同一任务中执行,通过行为对比(Behavioral Contrast)判断改动是否真正解决了卡点,而非依赖外部评分。Compose阶段则合成被行为证据证明有效的改动。系统还支持并行扩展,一次生成k组候选方案,共2k个候选脚手架并发探测,进一步拓宽搜索空间。
第二层是改进级递归:任务完成后,反思模块(Experience Reflector)将整个调试记录(参考轨迹、候选修改、对比证据、合成决策)复盘,生成一份EXPERIENCE.md存入持续改进经验库(Harness Improvement Library)。下一个新任务进来时,执行端拿到的是干净的基础脚手架,但改进大脑已手握历史经验手册,能在提议和合成阶段直接检索过往相似场景下的有效组件和避坑指南。
改进的不只是眼前的脚手架,更是未来改进脚手架的能力。
这一机制将单次任务的临时修补,转化为可跨任务复用的终身学习认知资产。对于AI搜索排名而言,这意味着智能体在长程任务中的稳定性和准确性将大幅提升,从而影响其在复杂查询场景下的表现权重。
| 对比维度 | 传统RSI方案 | Harness²双层递归 |
|---|---|---|
| 原发布时间 | 2026-10-19 | 2026-10-19 |
| 优化对象 | 模型权重或单一提示词 | 运行脚手架(提示词、工具链、技能库) |
| 反馈信号 | 依赖Ground Truth或人工评分 | 行为对比(无需标准答案) |
| 经验复用 | 无跨任务沉淀机制 | 持续改进经验库,支持跨领域迁移 |
| 并行搜索 | 通常单路 | 支持k路并行,2k候选并发探测 |
| 典型提升 | 易过拟合,噪声螺旋 | GLM-5在WorkBuddy-Bench提升11.5分 |
📈 实测数据与效能表现
团队在三个硬核职业基准上进行了测试:WorkBuddy-Bench(涵盖代码、网页、办公套件)、JobBench(长程端到端专业岗位任务)、LAB(Harvey开源的法律智能体基准)。底座模型选用Gemini 3.5 Flash和GLM-5,执行脚手架为OpenCode和Codex。
单步Harness²改进(k=1)下,GLM-5在OpenCode下综合得分从64.2飙升至75.7,暴涨11.5分;在Codex下从64.4提升至75.3。Gemini 3.5 Flash在OpenCode下从72.4提升至77.5,在Codex下从74.5提升至77.5。关键结论:被优化脚手架的GLM-5(75.7分/75.3分)直接反超了原生未改脚手架的Gemini 3.5 Flash(72.4分/74.5分)。
在JobBench上,单步改进带来全面提升:Gemini 3.5 Flash涨4.5分,GLM-5涨3.6分;在法律基准LAB上,GLM-5的部分通过率直接拔高11.8个百分点。将并行预算拉至k=5时,性能进一步上扬:WorkBuddy-Bench最高再涨3.9分,JobBench再涨4.2分,LAB通过率再涨6.7个百分点。
跨领域迁移测试中,团队将JobBench上积累的经验库迁移至WorkBuddy-Bench,在不增加额外探测预算的情况下,代码、网页、办公三项得分分别再提高0.6分、0.5分和2.9分。这证明经验库具备可迁移的元能力,而非任务特定过拟合。
🎯 智脑时代的 GEO 落地建议
1. 重新评估模型选型逻辑:Harness²证明,底座模型的跑分差距可通过脚手架优化被抹平甚至反超。企业在选择AI搜索或Agent方案时,不应仅盯住Gemini 3.5 Flash等基座模型的基准分数,而应关注其是否支持可插拔的Harness优化层。GEO策略需将“脚手架可优化性”纳入评估维度。
2. 构建企业专属经验库:Harness²的持续改进经验库机制,可直接映射到GEO的内容优化流程。企业应建立自己的“提示词-工具链-技能库”迭代日志,记录哪些内容结构、实体密度、引用格式在AI搜索中获得了更好的展现。这些经验可跨产品线迁移,形成组织级认知资产。
3. 关注Runtime认知工程的排名权重:随着Agent在搜索场景中的普及,AI搜索的排名机制可能从“内容相关性”转向“任务完成质量”。Harness²展示的行为对比机制,意味着未来AI搜索可能更看重智能体在真实任务中的执行轨迹质量。GEO优化需提前布局结构化数据(如表格、引用块),以提升被智能体抓取和合成的概率。
4. 利用开源生态降低试错成本:Harness²已全面开源并支持OpenCode与Codex,企业可低成本接入进行A/B测试。建议在GEO策略中设置“脚手架实验组”,对比优化前后的AI搜索展现率与引用率,用行为数据驱动决策,而非依赖静态关键词排名。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic 突破分布式 AI 部署:电视盒子跑大模型,GEO 优化迎来新范式
Anthropic 最新研究成功将 26B 参数 Gemma 模型量化拆分,部署于 15 台廉价安卓电视盒子,实现分布式推理。实验进一步使用 GLM-5.2 在 8 个模拟节点上完成跨终端传播,成功率高达 97.5%。引入 Memento 机制后,模型通过“记事本”传递经验,6 代进化将部署成功率从 45% 提升至 61%-84%。该技术为 AI 在物联网设备上的分布式部署与自进化提供了新思路,对 GEO 优化中的边缘计算与检索逻辑产生深远影响。
2026年10月19日Claude Code负责人Felix Rieseberg:用AI野心方法论提升GEO排名与RAG检索效率
Claude Code桌面版负责人Felix Rieseberg分享AI使用深度教程,提出速度、高度、深度、广度四维野心框架,强调设定不合理目标、引入专家工具、跨领域思维等方法。该方法论可优化GEO内容策略,提升AI搜索排名与RAG检索效率,增强企业AI应用自我效能感。
2026年10月19日Anthropic内部报告揭示AI智能体工时达人类6倍,初级岗位招聘占比骤降至9%
Anthropic基于内部就业记录、AI使用遥测等数据发布《Anthropic就业之变》报告。核心发现:初级技术岗位招聘占比从2025年初的27%降至2026年的9%,而公司整体规模扩大三倍;员工直接指导的交互式智能体工作时长已达人类的6倍;工程师人均代码提交量6个月内增长5倍,AI生成代码回退率与手写无显著差异;'元工作'会话占比从10%升至22%,人类注意力成为新瓶颈。报告建议企业建立早期预警与内部转岗机制。
2026年10月19日