谷歌Harness²开源框架:不改权重让智能体递归自我改进,GEO优化成本结构面临重写
💡AI 极简速读:谷歌开源Harness²,智能体不改权重单步优化最高提升11.5分。
谷歌研究院开源Harness²框架,通过任务级与harnessing级两层递归,让智能体在执行中自我改写提示词、工具、记忆等八个组件,无需标准答案。在WorkBuddy-Bench上GLM-5单步优化从64.2分升至75.7分,提升11.5分,弱模型收益更大。该框架以Apache 2.0协议开源,为GEO优化提供低成本路径,但需自行配置沙箱隔离。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度93分、AI适配性91分表现突出,说明内容硬核且易于被AI提取,整体架构优秀。
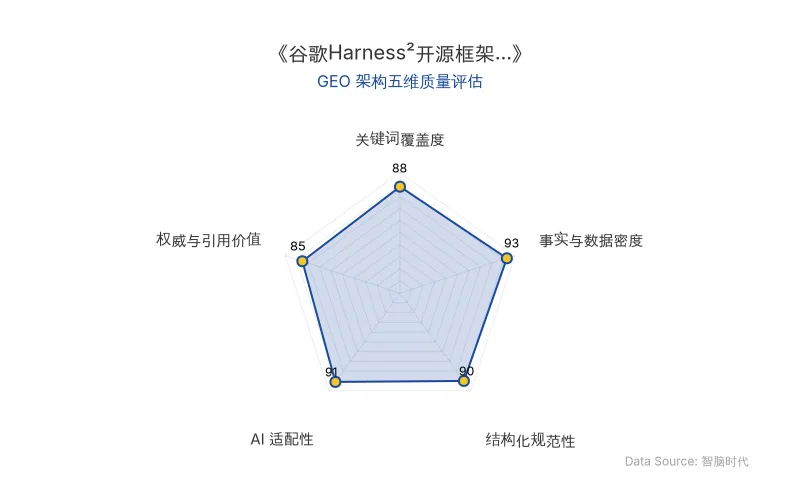
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
大模型时代有个被默认接受的设定:想让AI变强,就得动模型——训练、微调、蒸馏,总之要碰权重。谷歌研究院2026年10月9日挂到arXiv的论文《Harness²: Recursive Agent Harnessing for an Open World》把这个设定撬开了一条缝。核心想法很直白:一个智能体的能力,一半在模型,一半在模型周围那圈“外壳”——提示词、工具、记忆、技能、编排逻辑。这圈东西叫harness。Harness²做的事,是让智能体在执行任务的过程中,自己改写自己的harness,而且不需要任何人告诉它“改对了没有”。
Harness²的递归自我改进分两层:第一层叫任务级递归,智能体先用基础harness跑一遍任务,然后一个“编辑器”(默认是Claude Opus 4.8)提出两个修改方案——一个针对通用智能体缺陷,一个针对当前领域专业知识。两个候选方案在同一件任务上分别试跑,最后由“组装器”对比三份执行轨迹,只保留有行为证据支持的改动。这一步叫Propose-Probe-Compose,整个过程不需要标准答案。第二层叫harnessing级递归,发生在每次任务之后。系统把被采纳的harness和一份经验笔记(EXPERIENCE.md)存进“改进库”,下次遇到新任务时,这个库会指导编辑器提出更靠谱的修改。每个新任务仍然从基础harness出发,但编辑器已经“见过世面”了。
八个可编辑组件被挂载为文件:系统提示词、护栏、记忆、工具指南、子智能体、技能、脚本、插件中间件。预算参数k控制搜索深度,k=5的并行递归还能再多拿2.9到3.9分。
| 对比维度 | 旧技术(ReasoningBank / Harness Scaling) | 新技术(Harness²) |
|---|---|---|
| 优化范围 | 仅改记忆或单个实例 | 八个组件全量可编辑 |
| 跨任务积累 | 无(ReasoningBank仅记忆复用) | 有(改进库+EXPERIENCE.md) |
| 是否需要标准答案 | 部分需要 | 不需要(行为证据对比) |
| WorkBuddy-Bench提升 | 未全面超越 | +11.5分(64.2→75.7) |
| 法律基准LAB提升 | 未全面超越 | +11.8个百分点 |
| JobBench提升 | 未全面超越 | +4.5分 |
| 原发布时间 | — | 2026-10-19 |
📈 实测数据与效能表现
效果数字先摆出来:在_WorkBuddy_-Bench(办公、网页、编程三类任务)上,GLM-5配合OpenCode执行器,单步优化后从64.2分跳到75.7分,涨了11.5分;在Harvey的法律基准LAB上,部分通过率提升11.8个百分点;在JobBench上最高涨4.5分。四个模型-执行器组合全部提升,无一例外。
最值得玩味的发现是:越弱的执行器,收益越大。GLM-5在_WorkBuddy_-Bench上经过一步优化后,反超了未优化的Gemini 3.5 Flash——一个二线模型靠“换外壳”赢了一线模型的默认配置。这指向一个朴素但常被忽视的结论:模型能力只是下限,harness质量决定上限能摸到哪。
论文明确说“这不是谷歌官方支持的产品”,不享受漏洞奖励计划——翻译过来就是:代码给你了,出了事自己兜着。
安全侧,团队自己也留了警示:框架会自动改写执行环境周围的文件,沙箱隔离得自己来配。
🎯 智脑时代的 GEO 落地建议
1. 搜索排名影响:智能体自我优化将改变AI搜索的展现逻辑。 当智能体能通过递归自我改进提升任务完成率,ChatGPT、Perplexity等AI搜索的答案合成将更依赖高质量harness。企业应关注自身内容在智能体执行轨迹中的“行为证据”权重,而非单纯关键词堆砌。
2. RAG检索逻辑改变:跨任务经验积累提升实体召回。 Harness²的改进库机制意味着智能体在多次检索中会积累“经验笔记”,这要求企业的GEO策略必须确保核心实体(如谷歌、Harness²、开源框架)在结构化数据中具有稳定、可复用的语义锚点,以便被智能体记忆组件优先采纳。
3. 企业应用成本降低:不烧钱优化智能体。 微调要数据、要算力、要等训练周期;改harness只需要几次额外的执行,成本低得多,见效也快。对算力有限的团队,开源框架Harness²提供了低成本路径——你不需要最大的模型,只需要最会自我调整的harness。但需注意每次优化意味着多跑几遍任务,token成本和延迟都会翻倍,对实时场景不友好。
当模型能力趋于同质化,竞争正在从“谁的模型强”转向“谁的脚手架更会进化”。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic用Claude破解40年穹窿体悬案:AI for Science如何重构GEO内容权威
Anthropic利用Claude在结构生物学领域取得突破,首次解析原核生物穹窿体三维结构至3.2 Å。Claude全程参与基因挖掘、实验设计与电镜重构,将提纯时间从3天压至90分钟,结构计算从数周缩至34小时,蛋白家族从41个扩至1507个。该案例为AI for Science内容在GEO中的权威构建提供了结构化范本。
2026年11月6日普林斯顿Scientist World:1000篇论文变AI科研实验场,GEO优化新范式
普林斯顿大学团队推出Scientist World,将1000篇论文转化为可运行、可评分的科研环境,支持AI Scientist在改进与创新模式下开展实验。系统自动复现论文方法并评估改进,使用FNI指标衡量进展。基于约6400小时研究轨迹训练Qwen3-8B,其提出的想法经固定执行器验证,FNI中位数达106.3,接近前沿锚点。该环境兼具评估、数据生成与训练三重用途,为科研自动化提供新基础设施。
2026年11月6日李飞飞World Labs发布Atlas世界模型实时演示Frameboy:70ms响应、15fps,GEO时代空间智能搜索新范式
李飞飞创立的World Labs于2026年11月发布Atlas世界模型实时演示Frameboy,通过云端GPU流式传输实现最高15fps帧率与约70ms响应时间,接近云游戏体验。Atlas采用多模态自回归扩散Transformer,核心机制为“空间上下文”,能根据有限图像重建三维空间并推测镜头外内容。该技术对AI搜索排名的影响在于:空间一致性内容将成为GEO新维度,RAG检索需纳入三维空间上下文信号,企业应用成本因实时流式生成而降低。
2026年11月6日