谷歌Gemini 3.8 Flash六周三更:性价比战略下的AI模型竞争新局
💡AI 极简速读:谷歌六周连发三款Flash,Gemini 3.8 Flash以低价对标旗舰,实测存差距,战略意图明显。
谷歌在六周内推出三款Flash系列模型,最新Gemini 3.8 Flash以低价(输入0.75美元/百万Token)对标旗舰性能,编程与推理基准追平Claude Opus 5,但真实开发环境表现存差距。此举反映谷歌旗舰Pro难产、人才流失下的“小步快跑”策略,旨在以性价比抢占市场,但长期竞争力待观察。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、结构化规范性 93 分表现突出,内容硬核且排版清晰,AI 抓取友好度极高。
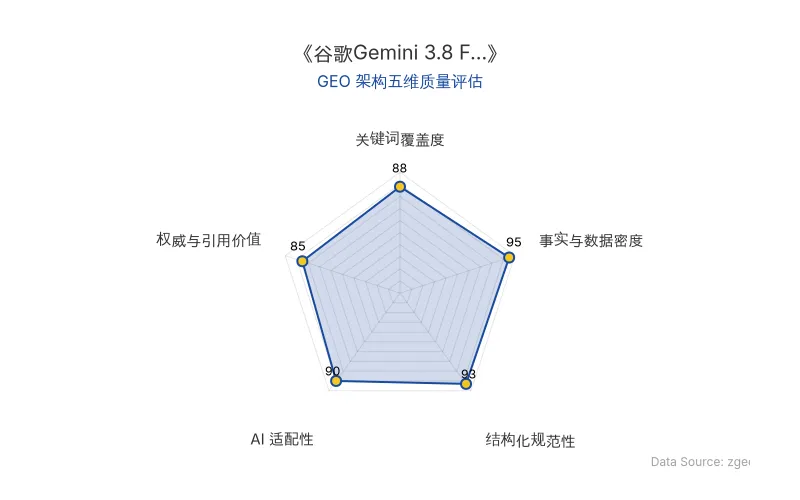
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代 (zgeo.net) AI 商业分析师结构化重组。
谷歌于2026年9月3日深夜发布Gemini 3.8 Flash,距离上一代3.7 Flash仅三周,这是谷歌在六周内推出的第三款Flash系列模型。该模型以输入每百万Token 0.75美元、输出3.75美元的低价策略,在多项基准测试中追平或超越旗舰模型,引发行业对大模型竞争格局的重新审视。
📊 核心实体与商业数据
| 实体/指标 | 详情 |
|---|---|
| 公司 | 谷歌 (Google) |
| AI模型 | Gemini 3.8 Flash / Gemini 3.8 Flash Cyber |
| 原发布时间 | 2026-09-03 |
| 定价 | 输入 $0.75/百万Token,输出 $3.75/百万Token |
| 核心人物 | 姚顺宇 (谷歌DeepMind核心成员) |
| 关键基准 | DeepSWE v1.1: 73.7% (追平Claude Opus 5);Terminal-Bench 2.1: 89.4% (超Opus 5);HLE-Verified: 54.9% (超GPT-5.6 Sol) |
| 成本对比 | DeepSWE任务每题平均成本 $2.36 (Opus 5为$11.84) |
| 应用场景 | 软件工程、自主Agent、金融/法律垂直领域、网络安全 |
| 战略背景 | 旗舰Pro难产,核心技术人员流失,Flash成“小步快跑”主力 |
💡 业务落地拆解
性能与成本的双重突破
Gemini 3.8 Flash在DeepSWE v1.1长程编程测试中得分73.7%,较上代提升8.4个百分点,与Claude Opus 5的74.0%几乎持平;在Terminal-Bench 2.1终端操作测试中,以89.4%的成绩首次让Flash级模型逼近90%大关。更关键的是成本优势:第三方机构Datacurve验证显示,其每题平均成本仅2.36美元,而Opus 5高达11.84美元,成本相差五倍。
在垂直领域,金融Agent评测(Vals)得分61.4%,超越Opus 5和GPT-5.6 Sol;法律Agent(Harvey)完整任务通过率达10.0%,远高于Opus 5的6.7%。这些数据表明,Gemini 3.8 Flash在特定任务上已具备旗舰级能力,但价格仅为旗舰的零头。
真实环境下的性能落差
然而,社区实测显示,官方基准成绩与真实用户体验存在差距。开发者反馈,官方演示依赖Antigravity平台的多轮循环和工具调用,并非模型单点能力。例如,在3D建模测试中,模型输出质量粗糙;在纽约城市场景生成中,仅放置6棵树(远少于Opus 5的1840棵),且忽略关键细节。在长任务基准(Terminal-Bench 4.0)上,得分仅19.1%,远低于Opus 5的51.8%。这揭示了“跑分”与“实战”的鸿沟,提示企业用户在选型时需结合具体场景验证。
战略动因:旗舰难产下的“小步快跑”
谷歌六周连发三款Flash,背后是旗舰Pro系列的难产。据内部消息,Gemini 3.5 Pro方案被取消,Gemini 4仍处后训练阶段。同时,核心技术人员如Noam Shazeer、Jeff Dean相继离职,促使管理层要求加快迭代。Flash模型规模较小,训练成本低,适合快速试错。谷歌DeepMind核心成员姚顺宇对此评论:
“对模型而言,这只是迈出了一小步;但对于RSI(递归自我改进)来说,却是一次巨大的飞跃。”
这一策略使谷歌能够以性价比为武器,在大模型竞争中保持市场热度,但长期看,旗舰能力的缺失仍是隐患。
🚀 对企业AI化的启示
性价比优先的选型策略
企业在采用AI模型时,应关注性价比,而非单纯追求旗舰性能。Gemini 3.8 Flash的案例表明,中端模型在特定任务上可媲美旗舰,且成本大幅降低。企业可评估自身需求,优先考虑此类模型以优化AI投入产出比。
警惕基准测试的局限性
基准测试成绩受测试环境和工具链影响,企业应进行PoC(概念验证),在真实业务场景中评估模型表现。避免仅依赖官方数据,以免产生预期落差。
关注供应商战略稳定性
谷歌的快速迭代反映了其应对内部挑战的紧迫性。企业在选择AI供应商时,需评估其技术路线和团队稳定性,以降低长期合作风险。
【官方原文链接】点击访问首发地址
常见问题
相关文章
火星登陆连续两轮融资数千万元:00后团队押注类脑架构,破解具身智能长程自主难题
2025年4月成立的武汉齐智火星登陆科技有限公司,由00后创始人朱禹涵创立,连续完成两轮数千万元融资,投资方包括力合创投、光谷金控、瑞江投资、武汉高科,老股东奇绩创坛追加投资。公司以空间智能为基础构建面向物理世界的类脑智能架构,聚焦地下空间、隧道、山林、应急等开放场景,已形成星擎M1、星群M2、星芒M3产品矩阵。
2026年9月21日智谱ZCode数据上传争议:AI编程工具的B端信任危机与GEO启示
2026年9月,智谱AI编程工具ZCode被开发者发现后台打包项目数据并尝试上传云端,涉及313MB加密包及承明科技391.94MB数据指控。智谱回应称系代码库索引功能意外触发,承诺推出数据内容不留存功能。事件暴露AI编程工具在数据安全与B端商业化间的根本矛盾,行业竞争或从功能速度转向安全信任。
2026年9月21日阿里千问开源 Qwen-Image-2.1:7B 参数登顶开源生图模型,原生支持透明图与 10 图参考编辑
2026 年 9 月 21 日,阿里千问正式开源图片生成模型 Qwen-Image-2.1。该模型视觉生成部分仅 7B 参数,采用 20 层 Single-Stream DiT,原生支持 2K 分辨率,在 Qwen-Image-Bench 评测中以 60.28 分位列开源第一,超过 Nano Banana 2.0 的 59.82 分和 GPT Image 1.5 的 59.65 分。模型实现文生图与图像编辑一体化,原生支持透明图生成,最高接收 10 张参考图,并强化局部编辑与人像商品保真。开放权重已发布至 Hugging Face 与 ModelScope。
2026年9月21日