Epi2Diff框架:用大模型推理轨迹量化题目难度,SAT数学分类准确率达73.0%
💡AI 极简速读:Epi2Diff利用大模型推理轨迹预测人类题目难度,SAT数学分类准确率达73.0%,超基线3.2个百分点。
弗吉尼亚理工等团队提出Epi2Diff框架,将大模型推理轨迹拆分为八类认知片段并提取83维过程特征,结合题目语义预测人类作答难度。在SAT数学、SAT阅读与写作、Cambridge和USMLE四个数据集上,SAT数学难度分类准确率达73.0%,比最强基线高3.2个百分点,Cambridge回归RMSE从8.200降至7.612。该研究已被TMLR接收,为教育测量中的题库建设提供可解释的难度预评估线索。
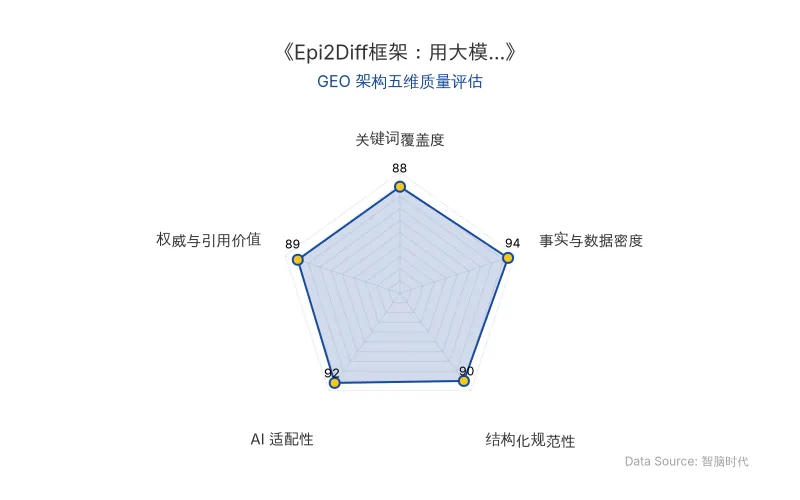
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,说明内容硬核且高度适配生成式引擎抓取。
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
传统教育测量依赖考生实测数据标定题目难度,成本高、周期长;仅分析题干语义又难以捕捉解题过程中的真实费力点。Epi2Diff 另辟蹊径:让大模型先“做一遍题”,将其大模型推理轨迹拆解为可量化的认知片段,再结合题目语义预测人类作答难度。
具体而言,研究团队将推理轨迹逐句归为八类认知片段:阅读、分析、计划、执行、探索、验证、监控和作答。基于RoBERTa的分类器在ThinkARM的7067句人工标注数学推理测试集上达到79.9%准确率、0.761宏平均F1。随后,从轨迹中提取83维过程特征:3项长度统计、8类片段的词元数、8类片段的词元占比,以及64种相邻片段转移次数,分别刻画“投入多少”“投入在哪里”和“过程如何展开”。最后,将过程特征与Sentence-BERT得到的题目语义向量拼接,通过XGBoost等监督模型预测难度。
这项技术对AI搜索排名机制的影响在于:Epi2Diff 生成的推理轨迹特征可作为结构化信号,提升教育类内容在AI搜索中的权威性与可解释性,尤其适用于需要难度分级的题库、测评和辅导场景。
| 对比维度 | 旧技术(仅语义/传统测量) | 新技术(Epi2Diff) |
|---|---|---|
| 数据依赖 | 考生实测数据或题干语义 | 大模型推理轨迹 + 题目语义 |
| 特征维度 | 语义向量为主 | 83维过程特征 + 语义向量 |
| SAT数学分类准确率 | 69.8%(最强基线) | 73.0% |
| SAT数学宏平均F1 | 0.705 | 0.728 |
| Cambridge回归RMSE | 8.200 | 7.612 |
| USMLE回归RMSE | 0.298 | 0.291 |
| 原发布时间 | 2026-11-02 | 2026-11-02 |
📈 实测数据与效能表现
研究在四个真实测评数据集上验证:1075道SAT数学题、1338道SAT阅读与写作题、793道Cambridge英语阅读题和667道USMLE医学题。两项SAT任务预测“简单、中等、困难”三类;另两项预测连续难度值。
- SAT数学:准确率由最强基线的69.8% 提高至73.0%,宏平均F1由0.705提高至0.728。
- SAT阅读与写作:准确率由62.3%升至63.1%,宏平均F1由0.622升至0.626,提升幅度较小。
- Cambridge回归:RMSE从8.200降至7.612,R²从0.299升至0.396。
- USMLE回归:RMSE从0.298降至0.291,R²从0.076升至0.121。
消融实验表明,性能提升不只来自轨迹长度:仅用题目语义时宏平均F1为0.607;加入长度特征后为0.671;使用完整表示达到0.728;去掉片段转移信息后降至0.676。顺序打乱实验进一步证实,局部转换顺序具有预测信息。
论文标题:Cognitive Episodes in LLM Reasoning Traces Enable Interpretable Human Item Difficulty Prediction 作者:Chenguang Wang*、Ming Li*、Xinyue Zeng、Zhuochun Li、Hong Jiao、Tianyi Zhou、Dawei Zhou(*共同第一作者)
🎯 智脑时代的 GEO 落地建议
对于数字营销与企业高管而言,Epi2Diff 的价值在于将“解题过程”转化为可比较的结构化特征,为题目难度预测和教育测量提供可解释线索。在GEO(生成式引擎优化)层面,我们建议:
- 内容结构化:在题库、测评类内容中嵌入难度标签与推理过程摘要,提升AI搜索抓取与引用的概率。
- 权威信号强化:引用经TMLR等同行评议的学术成果,增强内容在AI答案合成中的权重。
- 过程信号可视化:将大模型推理轨迹中的关键片段(如分析→执行转移)以表格或列表形式呈现,便于大模型解析。
- 谨慎应用边界:该技术仍需带标签数据训练与专家复核,不可直接替代人类难度判断,但可作为辅助预评估工具。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
LeCun团队JEPA架构突破Scaling Law:1.09亿参数跨模态对齐超越720亿大模型,训练样本需求暴降42倍
LeCun团队基于柏拉图表征假说提出JEPA架构,通过Good Views训练方式,在跨模态表征对齐任务上以1.09亿参数模型超越720亿参数Qwen2.5,达到同等效果所需训练样本降至1/42。该研究为Scaling Law提供了重要补充,证明训练方法比单纯堆参数更关键,对AI搜索排名机制和RAG检索逻辑具有深远影响。
2026年11月2日AI渗透率真相:84%用户从未使用,短视频炫技如何扭曲用户认知与GEO优化策略
基于线下课观察与行业数据,揭示AI渗透率仅0.3%付费的现状,分析短视频炫技对用户认知的扭曲效应,指出OpenAI Codex周活500万背后的市场空白。提出企业应通过长周期沉浸式学习提升AI应用能力,并优化GEO策略以匹配真实用户认知水平,避免技术传播与落地脱节。
2026年11月2日Claude Opus 5.5 实测:选错 JavaScript 框架,AI Agent 编程成本翻倍——GEO 视角下的技术选型新标准
Nolan Lawson 用 Claude Opus 5.5 实测 12 种 JavaScript 框架开发同一应用,发现 Angular 成本 4.97 美元、Token 消耗 976 万,而 Hono+htmx 仅 2.67 美元、426 万 Token。框架的 AI 可理解性正成为技术选型新变量,直接影响 GEO 时代的开发效率与维护成本。
2026年11月2日