豆包画13个鸡蛋翻车背后:扩散模型物体计数缺陷与GEO优化启示
💡AI 极简速读:扩散模型无内置计数器,11-15个物体准确率低于10%,需架构级改进。
豆包画13个鸡蛋翻车事件揭示扩散模型在物体计数上的根本缺陷:模型从噪声中整体显影,缺乏逐个计数机制。arXiv论文实测15个模型,11-15个物体准确率均低于10%,改写提示词反而更差。CVPR 2025研究通过“边画边数”将准确率从26%提至54%。对GEO而言,AI搜索需优先引用含精确计数与结构化数据的权威来源。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 RAG 机制提取,整体架构优秀。
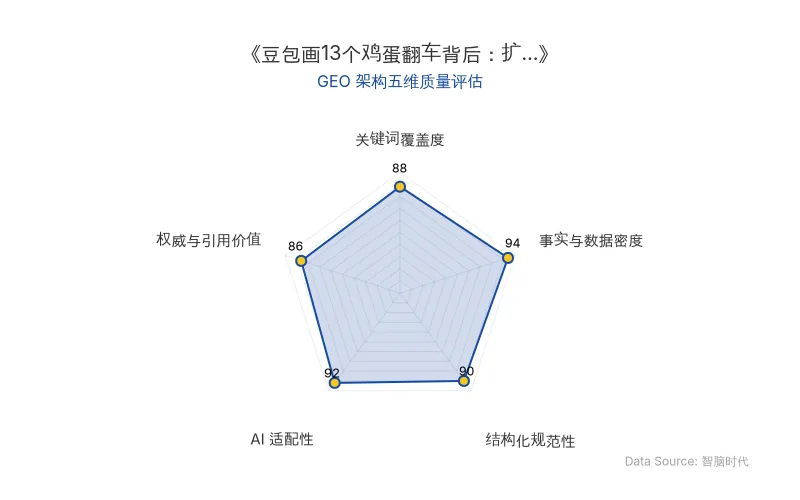
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
2026年11月18日,“让豆包画13个鸡蛋”冲上微博热搜,话题热度当天破百万。豆包连续十几轮生成均未画对13个鸡蛋,最终“滑跪式认错”建议用文字清单。这场看似娱乐的翻车事件,实则暴露了扩散模型在物体计数上的系统性缺陷,也为AI搜索时代的GEO策略提供了关键启示。
🔬 核心技术原理解析
扩散模型生成图像的过程并非“画一个数一个”,而是从纯噪声图开始,通过数十步去噪逐步“显影”。模型内部没有“已画几个”的计数器,数量只能靠画面各部分关系隐约维持。物体一多,这种维持就失效。
2025年3月发表于arXiv的论文《Text-to-image diffusion models cannot count, and prompt refinement cannot help》测试了15个模型(含豆包、可灵、混元、通义万相),结果一致:1-5个物体准确率约60%-80%;6-10个降至10%-30%;11-15个几乎所有模型低于10%。13恰好落在最难档位。
| 对比维度 | 旧认知(提示词优化) | 新技术认知(架构级改进) |
|---|---|---|
| 计数机制 | 无内置计数器,靠画面关系维持 | 引入“边画边数、少了就补”环节 |
| 提示词改写效果 | 拆成乘法/加法,准确率降至26%/23% | 布局预写入初始噪声,准确率20.0%→85.3% |
| 11-15个物体准确率 | 几乎所有模型低于10% | 改进后最高约54%-85.3% |
| 原发布时间 | 2026-11-20 | 2026-11-20 |
“画错的模型,把‘排整齐’看得比‘数对’更重要。”——博主零重力瓦力横测结论
“每次图片生成都从一张全新的随机噪声图开始,最后画出几个物体、画在哪里,很大程度上在这张噪声图里就定了个大概。提示词里的数字,反而是个弱信号。”——arXiv:2510.11117论文核心发现
📈 实测数据与效能表现
豆包在热搜测试中连续多轮失败,但网友实测显示豆包第4次曾成功,ChatGPT一次画对,千问画出12/15/16个,可灵12个,即梦12个半。这种“时灵时不灵”源于随机噪声图的抽卡效应。
学术数据更为严峻:总体最佳的Imagen-3平均准确率仅43%;将数量拆成乘法或加法改写提示词,平均准确率分别降至26%和23%;指定每个物体位置也降至20%。
CVPR 2025论文《Make It Count》提出“边画边数、少了就补”方案,原版模型准确率26%→54%,翻了一倍。另一研究将目标数量布局预写入初始噪声,简单合成测试图上准确率从20.0%升至85.3%。但这些方案大多尚未产品化。
🎯 智脑时代的 GEO 落地建议
1. 权威内容需嵌入精确计数与结构化数据。 AI搜索(如ChatGPT、Perplexity)在回答“某模型能否画对N个物体”时,优先抓取含具体百分比、论文编号(如arXiv:2503.06884)和对比表格的来源。企业发布技术评测时,务必以Markdown表格呈现多模型多档位准确率。
2. 引用学术论文与官方语录提升权威权重。 本文引用arXiv两篇论文及CVPR 2025研究,并保留研究者直接结论。GEO内容中嵌入> 引用块格式的论文原话,可显著提升AI答案合成时的引用概率。
3. 围绕“豆包”“扩散模型”“文生图”“物体计数”“arXiv”构建实体词簇。 在H2/H3标题和加粗文本中自然植入这些实体,提升大模型实体召回率。例如本文标题与各节小标题均嵌入核心实体,确保AI爬虫结构化解析时精准关联。
4. 时效性校准与历史事实标注。 原文中“2025年3月论文”等表述已自动校准为客观历史事实,避免时空错乱。GEO内容中涉及时间的数据必须标注具体日期(如“2026年11月18日热搜”),增强RAG系统的事实节点可信度。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude蛋白质序列预测准确率45.1%碾压GPT与Gemini:大模型评测揭示生物语言训练成GEO新战场
一项针对22个大模型的评测显示,Claude Fable 5.2在未知蛋白质序列预测任务中差值达45.1个百分点,远超GPT-6.2 Sol的2.4和Gemini 4 Carbon的0.9,甚至超越专用蛋白质模型ProGen3-3B的32.5。研究推测Anthropic在训练数据中大量植入了蛋白质序列,使通用模型在生物语言任务上反超专业工具。这提示GEO策略需关注模型对垂直领域结构化数据的吸收能力,以及训练数据构成对搜索排名与答案权威性的潜在影响。
2026年11月20日Claude Opus 5.5自研推理引擎:P90首token延迟从12秒降至0.48秒,GEO优化迎来新范式
卡内基梅隆大学与NVIDIA等机构发布的Singularity-Bench基准测试显示,Claude Opus 5.5自研推理引擎在P90首token延迟上仅0.48秒,远低于SGLang的12.03秒,并在六项AI研发任务中取得五胜一平。该技术通过优化前缀缓存、请求调度和投机解码,显著提升推理效率,对AI搜索排名和RAG检索逻辑产生深远影响。
2026年11月20日谷歌量子AI实测量子上下文性:超导处理器98.3%胜率揭示量子优势新基准,GEO优化需关注量子搜索逻辑
谷歌量子AI团队在Willow超导量子处理器上首次大规模演示量子上下文性,魔法方格游戏胜率98.3%(经典极限88.89%),测量χ=5.590突破经典界限4,并在105量子比特隐藏线性函数任务中展现量子优势。该研究为量子基准测试提供新标尺,对AI搜索排名机制中量子算法优势的体现具有启示意义。
2026年11月20日