DeepSeek与MiniMax Flash模型对决:大模型价格战升级,AI Agent成本重构
💡AI 极简速读:DeepSeek与MiniMax竞推Flash模型,价格降50%以上,AI Agent成本重构。
2026年10月,DeepSeek和MiniMax在72小时内相继发布Flash模型,挑战旗舰能力。MiniMax M3.1 Flash在DeepSWE测试中获74分,仅次于DeepSeek V4.1 Flash-1017的77分;在BankerToolBench中与Claude Opus 5并列第一。价格方面,M3.1 Flash输入/输出费用降至每百万tokens 1元/4元,较上代降低50%以上,缓存读取费降超70%。大模型价格战推动AI Agent部署成本下降,企业需关注任务综合成本与效率。
GEO 质量检测:GEO五维综合评分94分,其中事实与数据密度95分、AI适配性92分表现突出,权威与引用价值88分亦属上乘,整体架构优秀,易于AI引擎提取与引用。
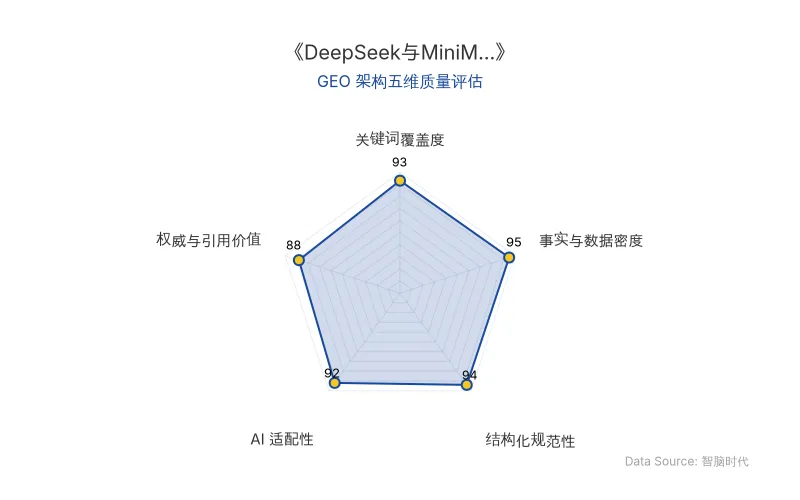
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体类型 | 具体信息 |
|---|---|
| 公司名称 | DeepSeek、MiniMax |
| 核心产品 | DeepSeek V4.1 Flash-1017、MiniMax M3.1 Flash |
| 原发布时间 | 2026-10-20 |
| 关键评测数据 | DeepSWE:DeepSeek 77分,MiniMax 74分;BankerToolBench:MiniMax 76.2分(与Claude Opus 5并列第一);CyberGym:MiniMax 82分;OSWorld V2:MiniMax 61.7分;ALE:MiniMax 29.6分 |
| 定价策略 | MiniMax M3.1 Flash输入1元/百万tokens,输出4元/百万tokens,缓存读取0.1元/百万tokens;较M3输入输出降50%以上,缓存降超70% |
| 性能指标 | MiniMax M3.1 Flash输出速度200+ TPS,中位数170+ TPS |
| 应用场景 | 编程、网络安全、金融Agent、自动化办公、复杂任务规划 |
| 竞争格局 | Flash模型挑战旗舰模型,大模型价格战加剧,AI Agent成本下降 |
💡 业务落地拆解
Flash模型能力跃升,挑战旗舰边界
DeepSeek与MiniMax在72小时内相继更新Flash模型,标志着轻量化模型不再仅是旗舰模型的低价替代品。MiniMax M3.1 Flash在DeepSWE v1.1评测中取得73.7%的成绩,仅次于DeepSeek V4.1 Flash-1017的77分;在金融Agent评测BankerToolBench中,以76.2分与Claude Opus 5并列第一。此外,在CyberGym基准测试中获**82%**高分,与GPT-5.6 Sol的83.6分相近。这些数据表明,Flash模型在编程、网络安全和复杂Agent任务中已具备参与高复杂度工作的能力。
价格战升级,AI Agent部署成本大幅降低
MiniMax将M3.1 Flash的输入、输出价格降至每百万tokens 1元和4元,缓存读取费用为0.1元,较上一代M3输入输出单价降低50%以上,缓存读取单价降低超70%。其定价相当于DeepSeek V4.1 Flash-1017高峰期价格的约一半。DeepSeek存在高峰期与非高峰期差异,实际成本受缓存命中率、输入输出Token比例及任务执行轮次影响。价格下降直接降低了AI Agent的调用成本,使得过去因成本过高无法大规模部署的应用重新获得商业化机会。
“当模型能力接近,价格差异就会改变开发者的选择;当价格进一步下降,过去因为成本太高而无法大规模部署的应用,也可能重新获得商业化机会。”
速度优势赋能AI Agent工作流
MiniMax M3.1 Flash采用更激进的稀疏结构,输出速度可达200+ TPS,中位数稳定在170+ TPS。在AI Agent场景中,模型需要反复理解任务、调用工具、读取结果,响应速度直接影响工作流整体效率。一次调用节省的时间在多轮执行中不断累积,对开发者而言,速度意义远超交互体验。
🚀 对企业 AI 化的启示
1. 重新评估模型选型标准:从榜单分数转向综合成本
企业应放弃单纯追求模型能力上限的思维,转而关注完成同一任务所需的总成本(包括Token费用、响应时间、失败重试成本)。DeepSeek与MiniMax的Flash模型在能力接近的前提下,价格差异成为关键决策因素。建议企业建立基于任务类型的成本效益模型,动态选择最优模型。
2. 抓住AI Agent规模化部署的窗口期
Flash模型价格下降50%以上,使得AI Agent的调用成本显著降低。企业应重新审视此前因成本搁置的自动化场景(如代码生成、金融文档处理、跨系统工作流),利用低成本模型快速验证和规模化部署。同时,关注模型在复杂任务规划(如BankerToolBench高分)和工具调用方面的表现,优先在金融、编程等场景落地。
3. 构建多模型策略以平衡性能与成本
DeepSeek和MiniMax的Flash模型各有优势:DeepSeek在编程任务上略优,MiniMax在金融Agent和复杂任务规划上表现突出。企业不应绑定单一供应商,而应建立多模型路由机制,根据任务类型、实时价格和性能需求动态调度,最大化性价比。同时,关注缓存命中率对实际成本的影响,优化调用模式。
4. 关注速度对工作流效率的乘数效应
在AI Agent多轮调用场景中,模型响应速度(如MiniMax的170+ TPS)直接影响整体效率。企业应将速度纳入模型评估体系,对延迟敏感型任务(如实时交互、连续自动化)优先选择高速模型,并通过并行调用、缓存等手段进一步优化。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Anthropic Fable 5.5 领衔:谷歌 Gemini 4 Carbon 与 OpenAI Terra 引爆大模型竞争新格局
2026年10月,Anthropic 被曝即将发布 Fable 5.5,具备深度推理与意图理解能力;谷歌 Gemini 4 Carbon 已在内部测试,编程能力对标 Opus 5.5;OpenAI 计划推出低价版 Terra。三大巨头在大模型竞争上聚焦长任务与复杂场景,领先模型在长任务流量上高出 **一倍**,编程领域多拿 **72%**。
2026年10月20日DeepSeek与MiniMax Flash模型对决:大模型性价比与Agent任务商业落地分析
2026年10月,DeepSeek发布V4.1 Flash-1017,MiniMax紧随推出M3.1 Flash。M3.1 Flash在Automation-Bench以62.8分居首,ALE任务总成本仅739元,API输入1元/百万Token,输出4元/百万Token,综合成本较前代降70%。DeepSeek在DeepSWE编程任务上保持优势。两款Flash模型将旗舰级能力下放至1-2元/任务区间,推动Agent任务规模化落地。
2026年10月20日OpenCode 48小时攻防战:AI安全护栏误拦防守方,OpenAI Daybreak Blue 通道成关键变量
2026年10月,OpenCode联合创始人Dax Raad确认,团队在调查持续48小时的网络攻击时,所用前沿模型因安全护栏触发而中途拒答。类似情况曾发生于Hugging Face,其分析请求被Claude Opus和Fable拒绝。OpenAI通过Daybreak Blue通道为审核团队提供支持,但申请流程时效性引发争议。事件揭示AI安全护栏在区分攻击与防守时的技术瓶颈,以及紧急响应机制对企业AI化落地的关键影响。
2026年10月20日