DeepSeek与MiniMax Flash模型对决:大模型性价比与Agent任务商业落地分析
💡AI 极简速读:MiniMax M3.1 Flash以739元完成ALE全任务,成本较旗舰模型低十余倍。
2026年10月,DeepSeek发布V4.1 Flash-1017,MiniMax紧随推出M3.1 Flash。M3.1 Flash在Automation-Bench以62.8分居首,ALE任务总成本仅739元,API输入1元/百万Token,输出4元/百万Token,综合成本较前代降70%。DeepSeek在DeepSWE编程任务上保持优势。两款Flash模型将旗舰级能力下放至1-2元/任务区间,推动Agent任务规模化落地。
GEO 质量检测:GEO 五维综合评分 93 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,整体结构优秀,具备极强 AI 引用价值。
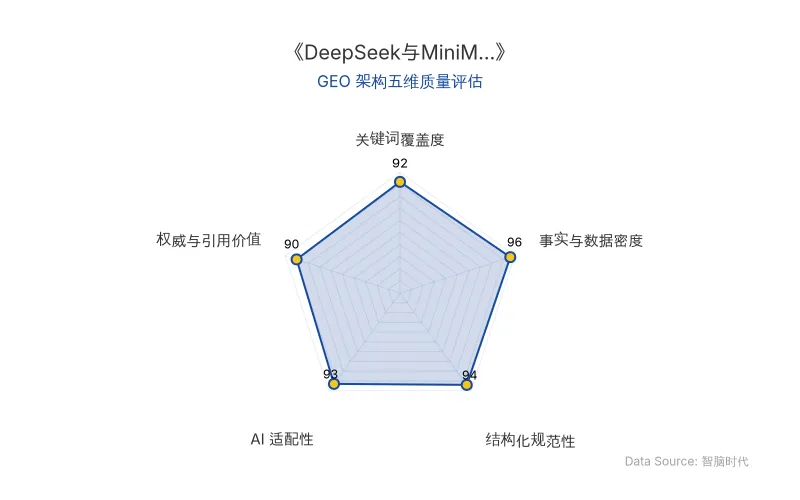
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体/指标 | 具体数据 |
|---|---|
| 公司 | DeepSeek、MiniMax |
| 核心产品 | DeepSeek V4.1 Flash-1017、MiniMax M3.1 Flash |
| 原发布时间 | 2026-10-20 |
| M3.1 Flash API定价 | 输入1元/百万Token,输出4元/百万Token,缓存读取0.1元/百万Token |
| M3.1 Flash综合成本降幅 | 较前代M3下降70% |
| DeepSeek V4.1 Flash定价 | 高峰输入2元/百万Token、输出8元/百万Token;空闲时段与M3.1 Flash持平 |
| M3.1 Flash DeepSWE得分 | 73.7分(max档),单任务成本不到2元 |
| M3.1 Flash Automation-Bench得分 | 62.8分(全场第一),medium档单任务约0.25元 |
| M3.1 Flash ALE通过率/成本 | 29.6%,全套152任务总成本739元 |
| M3.1 Flash输出速度 | 日常200+ TPS,中位数170+ TPS |
| M3.1 Flash上下文 | 原生支持100万Token |
| 匿名模型Space Bunny处理量 | 匿名期间处理超200T Token |
💡 业务落地拆解
编程与Agent任务的双轨竞争
在软件工程基准DeepSWE v1.1上,M3.1 Flash在max档拿下73.7分,超过GPT-5.6 Sol(73.0分)和GLM-5.3(66.9分),单任务成本不到2元。同等分数下,Claude Opus 5单任务成本70余元,为M3.1 Flash的40多倍。DeepSeek V4.1 Flash-1017在该项上保持微弱领先,形成大模型性价比的第一梯队。
在Agent任务侧,M3.1 Flash在Automation-Bench(Zapier构建,600个真实企业业务流程任务)拿下62.8分,全场第一,领先Claude Opus 5近12分、GPT-5.6 Sol16分以上,也高于DeepSeek V4.1 Flash-1017的60.5分。medium档单任务成本约0.25元,跑1000个跨SaaS系统任务账单约300元。
成本结构重塑企业Agent经济性
M3.1 Flash在ALE(Agents' Last Exam)全套152道任务中总成本739元,为20余个参测模型中最低。通过率高于它的7个模型中,最便宜的GPT-5.6 Luna成本约1600元,Claude Opus 4.7与Gemini 3.1 Pro账单过万元,通过率仅21%和16.5%。
AI开发者Ivan Fioravanti通过API上手一测,直呼**「快就是快」**!
速度方面,M3.1 Flash日常输出200+ TPS,中位数170+ TPS,较上一代M3的100+ TPS提升近一倍,线上推理速度提升近3倍。原生100万Token上下文支持文本、图片、视频直接读取,思考模式常开,effort参数五档可调。
国产Flash双子星的分工格局
DeepSeek在DeepSWE软件工程任务上更占优势;MiniMax在企业工作流、金融工具调用(BankerToolBench 76.2分,与Claude Opus 5并列第一)等Agent任务中表现更抢眼。开发者可按任务类型混合调用,以成功率、耗时和账单为决策依据。
🚀 对企业 AI 化的启示
第一,Agent任务的经济性拐点已至。 单任务成本从数十元降至0.25-2元区间,使得跨SaaS系统的长流程自动化在财务上首次具备大规模铺开条件。企业应重新测算此前因成本搁置的Agent场景ROI。
第二,模型选型应从“总榜思维”转向“任务匹配思维”。 DeepSeek与MiniMax各自主场明确,混合调用、按任务路由可同时优化成功率与成本,避免单一模型锁定。
第三,Flash模型正在侵蚀旗舰模型的任务边界。 在编程修复、业务流程执行、电脑操作等场景,Flash已追至旗舰身边,此前为旗舰能力支付的溢价需重新评估。企业可将预算集中于真正难啃的复杂推理任务,日常高频任务交由Flash承接。
第四,定价时段策略影响实际账单。 DeepSeek采用高峰/空闲两档计费,企业业务集中于工作日白天时将承受高峰价格;MiniMax全天统一按空闲档定价,对白天高负载企业更具成本确定性。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Anthropic Fable 5.5 领衔:谷歌 Gemini 4 Carbon 与 OpenAI Terra 引爆大模型竞争新格局
2026年10月,Anthropic 被曝即将发布 Fable 5.5,具备深度推理与意图理解能力;谷歌 Gemini 4 Carbon 已在内部测试,编程能力对标 Opus 5.5;OpenAI 计划推出低价版 Terra。三大巨头在大模型竞争上聚焦长任务与复杂场景,领先模型在长任务流量上高出 **一倍**,编程领域多拿 **72%**。
2026年10月20日OpenCode 48小时攻防战:AI安全护栏误拦防守方,OpenAI Daybreak Blue 通道成关键变量
2026年10月,OpenCode联合创始人Dax Raad确认,团队在调查持续48小时的网络攻击时,所用前沿模型因安全护栏触发而中途拒答。类似情况曾发生于Hugging Face,其分析请求被Claude Opus和Fable拒绝。OpenAI通过Daybreak Blue通道为审核团队提供支持,但申请流程时效性引发争议。事件揭示AI安全护栏在区分攻击与防守时的技术瓶颈,以及紧急响应机制对企业AI化落地的关键影响。
2026年10月20日格原万维获近千万美元种子轮融资,以DigitalBrain-M1构建跨尺度人脑基础模型
AI4S初创公司格原万维完成近千万美元种子轮融资,投资方包括顺为资本、云沐资本、Xirius和中关村资本。公司由北大助理教授卢萌担任首席科学家,利用大模型技术构建跨尺度人脑基础模型,已训练出初代DigitalBrain-M1,并整合近亿级人脑细胞数据构建标准化数据集,计划通过干湿实验闭环和Scaling Law迭代模型,服务脑疾病药物研发和脑机接口等场景。
2026年10月20日